df <- read_csv("datos/peso-estatura.csv", show_col_types = FALSE)
ggplot(df, aes(x = estatura, y = peso)) +
  geom_point(color = myblue) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()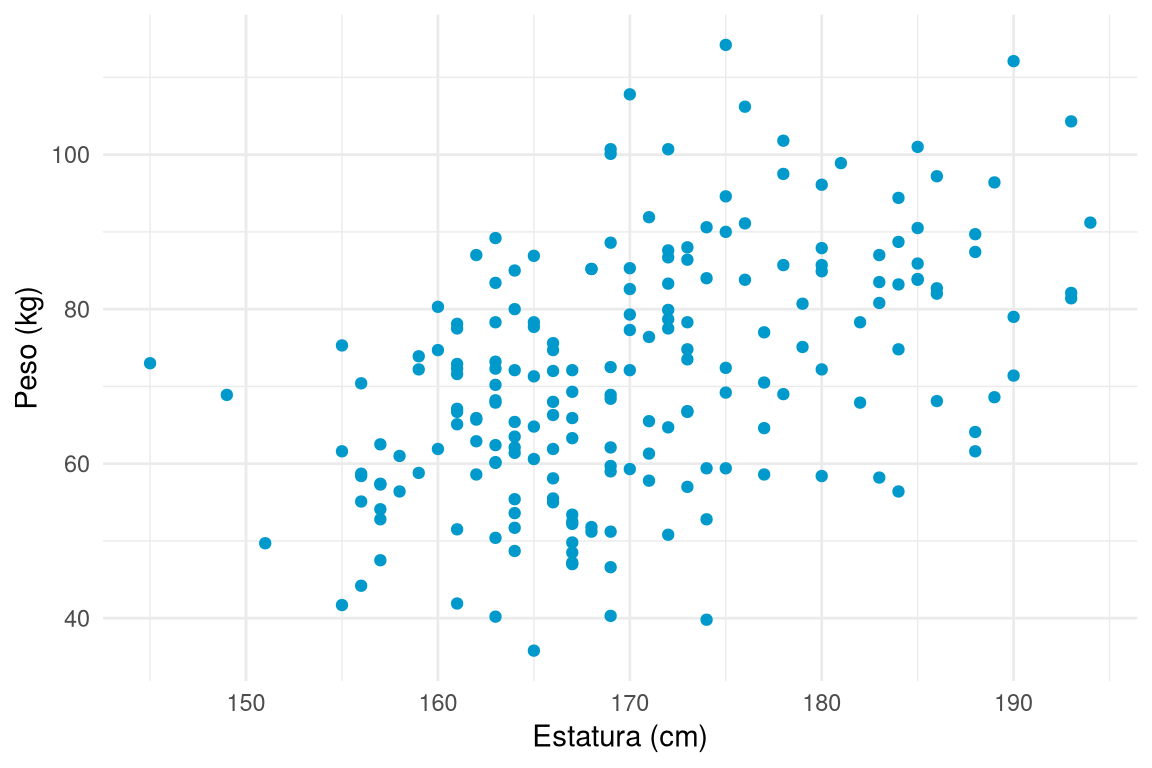
Los modelos de regresión son el instrumento más utilizado para estudiar cómo se relaciona una variable con otras. En este capítulo se introduce la regresión lineal simple desde el enfoque bayesiano, se extiende a la regresión múltiple y a los modelos con interacciones, y se termina con la evaluación de los modelos, la comparación entre ellos y la predicción.
En estadística se utilizan modelos de regresión para describir la relación entre una variable dependiente \(Y\) y una o varias variables independientes \(X_1, X_2, \ldots, X_n\).
En el caso de una sola variable independiente se habla de regresión simple, y el modelo se expresa como
\[ Y = f(X) + \varepsilon, \]
donde \(f(X)\) es una función de \(X\) que describe la relación entre \(Y\) y \(X\), y \(\varepsilon\) es un término de error que refleja la variabilidad de \(Y\) que no se explica por \(X\). Se asume que el error sigue una distribución normal con media cero y desviación típica \(\sigma\):
\[ \varepsilon \sim \mathcal{N}(0, \sigma). \]
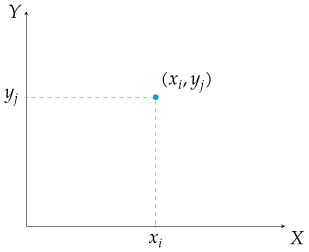
Para analizar la relación entre dos variables cuantitativas hay que estudiar la variabilidad conjunta de ambas. Esta variabilidad conjunta se representa habitualmente con un diagrama de dispersión: sobre unos ejes cartesianos, la variable independiente se sitúa en el eje \(X\) y la dependiente en el eje \(Y\), y por cada par de valores \((x_i,y_j)\) de la muestra se dibuja un punto.
Ejemplo 6.1 El conjunto de datos peso-estatura contiene el peso y la estatura de una muestra de 200 personas mayores de 18 años. El siguiente código muestra el diagrama de dispersión del peso frente a la estatura.
df <- read_csv("datos/peso-estatura.csv", show_col_types = FALSE)
ggplot(df, aes(x = estatura, y = peso)) +
geom_point(color = myblue) +
labs(x = "Estatura (cm)", y = "Peso (kg)") +
theme_minimal()La forma de la nube de puntos nos da una idea de la forma de la función \(f\) que describe la relación entre \(Y\) y \(X\).
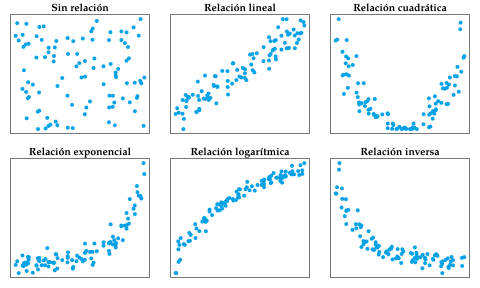
Cuando \(f\) es una recta, el modelo es un modelo de regresión lineal simple:
\[ Y = \beta_0 + \beta_1 X + \varepsilon, \]
donde \(f(x) = \beta_0 + \beta_1 x\) es la recta que expresa la relación lineal entre \(Y\) y \(X\), y \(\varepsilon \sim N(0, \sigma)\).
Para cada valor \(x_i\) de la variable independiente, el modelo asume que la variable dependiente \(Y\) sigue una distribución normal con media \(\mu_i = \beta_0 + \beta_1 x_i\) y desviación típica \(\sigma\). La relación lineal queda determinada por dos coeficientes:
En estadística frecuentista, el modelo de regresión lineal simple se estima con el método de los mínimos cuadrados, que consiste en encontrar los valores de \(\beta_0\) y \(\beta_1\) que minimizan la suma de los cuadrados de las diferencias entre los valores observados \(y_i\) y los valores predichos \(\hat{y}_i = \beta_0 + \beta_1 x_i\).
Esto da lugar a la fórmula de la recta de regresión lineal simple:
\[ y = \bar{y} + \frac{\sigma_{xy}}{\sigma_x^2}(x-\bar{x}), \]
donde \(\bar{x}\) y \(\bar{y}\) son las medias de \(X\) e \(Y\), \(\sigma_{xy}\) es la covarianza entre \(X\) e \(Y\), y \(\sigma_x^2\) es la varianza de \(X\). Los coeficientes son, por tanto, las estimaciones puntuales
\[ \beta_0 = \bar{y} - \beta_1 \bar{x} \quad \text{y} \quad \beta_1 = \frac{\sigma_{xy}}{\sigma_x^2}. \]
En R existen varias funciones para ajustar modelos de regresión. Las más habituales son:
lm(). Se utiliza para variables dependientes continuas con distribución normal. Ajusta el modelo por mínimos cuadrados ordinarios.glm(). Se utiliza para variables dependientes con distribuciones de la familia exponencial (normal, binomial, Poisson, gamma, etc.). Ajusta el modelo por máxima verosimilitud.lm()
Ajusta un modelo de regresión lineal por el método de los mínimos cuadrados ordinarios.
Parámetros:
formula: fórmula que especifica el modelo de regresión lineal.data: conjunto de datos que se utiliza para ajustar el modelo.La fórmula para especificar un modelo de regresión en R tiene la sintaxis
var_dependiente ~ var_independientesdonde, en los modelos de regresión múltiple, las variables independientes se combinan con los operadores
+ para incluir varias variables independientes sin interacción.* para incluir varias variables independientes con interacción.: para incluir solo la interacción entre varias variables independientes.Ejemplo 6.2 Recordemos el ajuste de un modelo de regresión lineal simple del peso sobre la estatura por mínimos cuadrados con la función lm().
modelo_lineal <- lm(peso ~ estatura, data = df)
tidy(modelo_lineal) |> kable(digits = 3)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | -59.676 | 17.113 | -3.487 | 0.001 |
| estatura | 0.770 | 0.100 | 7.675 | 0.000 |
glm()
Ajusta un modelo de regresión generalizada por el método de máxima verosimilitud.
Parámetros:
formula: fórmula que especifica el modelo.family: familia de distribuciones del error aleatorio y función de enlace.data: conjunto de datos que se utiliza para ajustar el modelo.La familia de distribuciones family puede ser cualquiera de las siguientes:
family |
Variable dependiente | Función de enlace | Uso típico |
|---|---|---|---|
gaussian() |
Continua | identidad \(\mu\) | Equivalente a lm |
binomial() |
0/1 o proporción | logit \(\log\left(\frac{\mu}{1-\mu}\right)\) | Regresión logística |
poisson() |
Conteos | logaritmo \(\log(\mu)\) | Modelos de conteo |
Gamma() |
Continua positiva | inversa \(1/\mu\) | Tiempos, costes |
inverse.gaussian() |
Continua positiva | inversa cuadrada \(1/\mu^2\) | Tiempos de espera |
Ejemplo 6.3 El mismo modelo lineal simple puede ajustarse por máxima verosimilitud con glm(), usando la familia gaussiana:
modelo_lineal <- glm(peso ~ estatura, data = df, family = gaussian())
tidy(modelo_lineal) |> kable(digits = 3)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | -59.676 | 17.113 | -3.487 | 0.001 |
| estatura | 0.770 | 0.100 | 7.675 | 0.000 |
En estadística bayesiana, los dos coeficientes \(\beta_0\) y \(\beta_1\) son parámetros más del modelo, a los que se asocia una distribución que refleja la incertidumbre sobre su valor.
Si asumimos que el término de error sigue una distribución normal, el modelo de los datos es
\[ Y_i|\beta_0, \beta_1, \sigma \sim N(\beta_0 + \beta_1 x_i, \sigma). \]
Como con otros parámetros, asignamos una distribución a priori a cada coeficiente y a la desviación típica \(\sigma\) del error, y actualizamos estas distribuciones con los datos para obtener las distribuciones a posteriori de todos los parámetros del modelo.
El modelo de regresión lineal simple se basa en los siguientes supuestos:
Si disponemos de información previa sobre los parámetros del modelo, debemos utilizar distribuciones informativas que reflejen esa información. En otro caso, podemos usar distribuciones poco informativas.
Como \(\beta_0\) y \(\beta_1\) son parámetros de localización, es decir, pueden tomar cualquier valor real, una distribución a priori adecuada para ellos es la normal:
\[ \beta_0 \sim N(\theta_0,\tau_0), \qquad \beta_1 \sim N(\theta_1,\tau_1). \]
Para la desviación típica \(\sigma\) del término de error, que es un parámetro de escala y solo puede tomar valores positivos, una distribución a priori adecuada es la exponencial (o la gamma inversa):
\[ \sigma \sim \text{Exp}(\lambda). \]
El modelo completo queda así:
\[ \begin{align*} \text{Distribución de los datos:} &\quad Y_i|\beta_0, \beta_1, \sigma \sim N(\beta_0 + \beta_1 x_i, \sigma) \\ \text{Distribuciones a priori:} &\quad \beta_0 \sim N(\theta_0,\tau_0), \quad \beta_1 \sim N(\theta_1,\tau_1), \quad \sigma \sim \text{Exp}(\lambda) \end{align*} \]
Ejemplo 6.4 Para modelizar la relación entre el peso y la estatura podemos utilizar un modelo de regresión lineal simple con las siguientes distribuciones a priori:
\[ \begin{align*} \beta_0' & \sim N(70, 10) \\ \beta_1 & \sim N(2, 1) \\ \sigma & \sim \text{Exp}(0{,}5) \end{align*} \]
Hemos cambiado \(\beta_0\), que sería el peso de una persona de estatura 0 cm, algo que no tiene sentido en este caso, por un término independiente centrado, \(\beta_0'\), que representa el peso típico de una persona de estatura media.
Cuando utilizamos distribuciones a priori informativas es importante validar que reflejan realmente la información previa que tenemos. Para ello podemos simular valores de los parámetros a partir de las distribuciones a priori y comprobar que son razonables. Con Stan, la opción algorithm = "Fixed_param" permite simular a partir de las distribuciones a priori sin ajustar el modelo a los datos.
Ejemplo 6.5 Para validar las distribuciones a priori del ejemplo anterior, simulamos 100 valores de \(\beta_0'\), \(\beta_1\) y \(\sigma\) a partir de sus distribuciones a priori:
set.seed(123)
modelo <- "
data {
  int<lower=1> n;   // número de simulaciones (100)
}

generated quantities {
  real beta0 = normal_rng(70, 10);
  real beta1 = normal_rng(2, 1);
  real sigma = exponential_rng(0.5);
}
"
prior <- stan(model_code = modelo, data = list(n = 100),
    chains = 1, iter = 200,  algorithm = "Fixed_param")
A continuación representamos las rectas de regresión que implican estas simulaciones, para comprobar que son razonables. Cada recta se dibuja con \(\beta_0'\) como altura en la estatura media de 170 cm:
library(tidybayes)
prior |>
  spread_draws(beta0, beta1, sigma) |>
  expand_grid(x = seq(120, 220, length.out = 2)) |>
  mutate(y = beta0 + beta1 * (x - 170)) |>
  ggplot(aes(x = x, y = y, group = .draw)) +
  geom_line(color = myred, alpha = 0.2) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()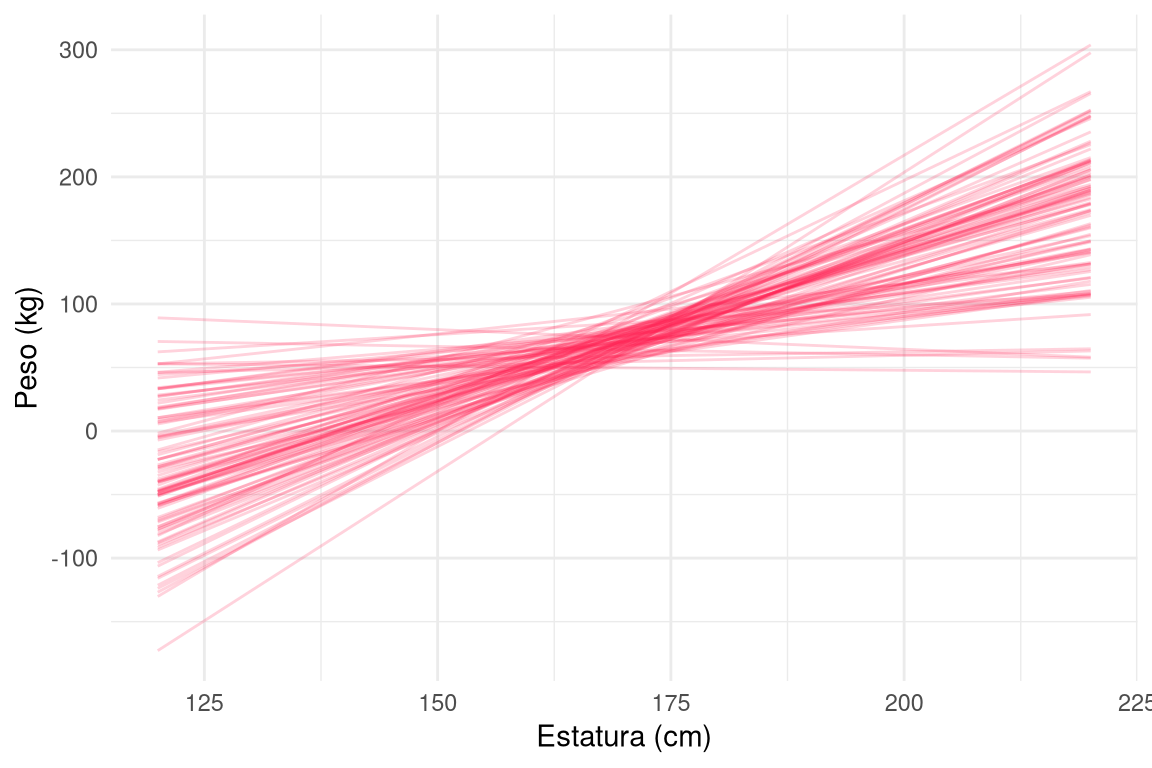
Una vez validadas las distribuciones a priori, definimos la función de verosimilitud \(L(\beta_0, \beta_1, \sigma|X,Y)\) y aplicamos la regla de Bayes para obtener las distribuciones a posteriori de los parámetros:
\[ f(\beta_0, \beta_1, \sigma | X, Y) \propto f(\beta_0, \beta_1, \sigma) \cdot L(\beta_0, \beta_1, \sigma|X,Y). \]
Ejemplo 6.6 Veamos cómo ajustar el modelo de regresión lineal simple a los datos de pesos y estaturas. El programa de Stan define los datos, los parámetros, el modelo y las distribuciones a priori:
modelo <- "
  data {
    int<lower = 0> n;
    vector[n] estatura;
    vector[n] peso;
  }
  transformed data {
    // Centramos la estatura para que beta0 sea el peso medio de una persona de estatura media
    vector[n] estatura_c = estatura - mean(estatura);
  }
  parameters {
    real beta0;
    real beta1;
    real<lower = 0> sigma;
  }
  model {
    peso ~ normal(beta0 + beta1 * estatura_c, sigma); // verosimilitud
    beta0 ~ normal(70, 10);                           // prior
    beta1 ~ normal(2, 1);                             // prior
    sigma ~ exponential(0.5);                         // prior
  }
"
ajuste_peso <- stan(model_code = modelo,
    data = list(n = nrow(df), estatura = df$estatura, peso = df$peso),
    chains = 4, iter = 2000, seed = 123)
Podemos comprobar la convergencia de las cadenas de Markov del ajuste anterior con la traza del parámetro de la pendiente:
library(bayesplot)
mcmc_trace(ajuste_peso, pars = "beta1", size = 0.2) +
  labs(x = "Iteración", y = expression(beta[1])) +
  theme_gray()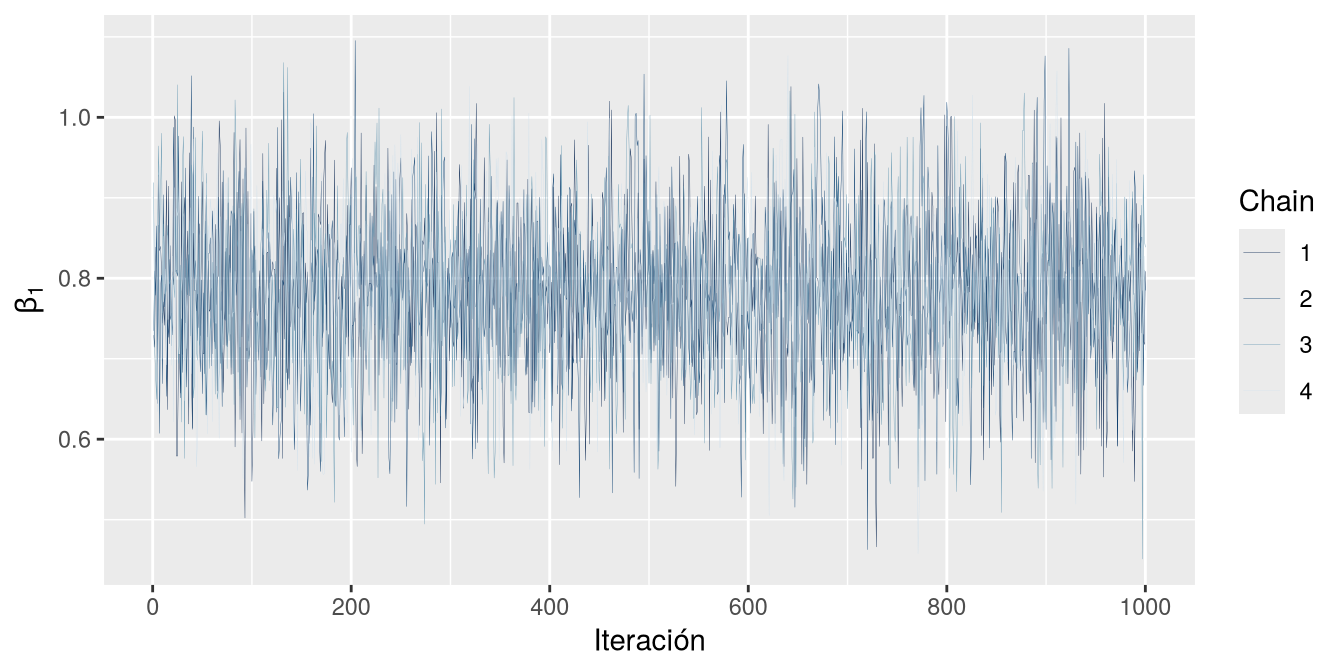
rstanarmAunque ya hemos visto cómo ajustar un modelo de regresión directamente con rstan, la definición del modelo en el lenguaje de Stan puede resultar compleja, sobre todo en modelos más elaborados. Para facilitar el ajuste de modelos de regresión lineales y generalizados podemos utilizar la función stan_glm() del paquete rstanarm, que ofrece una interfaz más sencilla con la misma sintaxis que glm().
stan_glm()
Ajusta un modelo de regresión lineal generalizado mediante inferencia bayesiana.
Parámetros:
formula: fórmula que especifica el modelo, con la misma sintaxis que glm().data: conjunto de datos que se utiliza para ajustar el modelo.family: familia de distribuciones que se utiliza para modelar la variable dependiente. Para la regresión lineal simple se usa gaussian().prior: distribución a priori de los coeficientes de regresión (las pendientes).prior_intercept: distribución a priori del término independiente.prior_aux: distribución a priori de la desviación típica del término de error.Ejemplo 6.7 Ajustamos el modelo de regresión lineal simple a los datos de pesos y estaturas con stan_glm(), usando las distribuciones a priori que hemos validado:
library(rstanarm)
set.seed(123)
modelo_peso_estatura <- stan_glm(peso ~ estatura, data = df, family = gaussian(),
  prior = normal(2, 1),
  prior_intercept = normal(70, 10),
  prior_aux = exponential(0.5),
iter = 5000*2, chains = 4, seed = 123)stan_glm() centra la variable independiente en su media antes de ajustar el modelo. Por eso el término independiente \(\beta_0\) representa el peso medio de una persona de estatura media, y no el peso de una persona de estatura 0.
Analizamos las cadenas de Markov generadas por el ajuste:
mcmc_trace(modelo_peso_estatura, size = 0.1)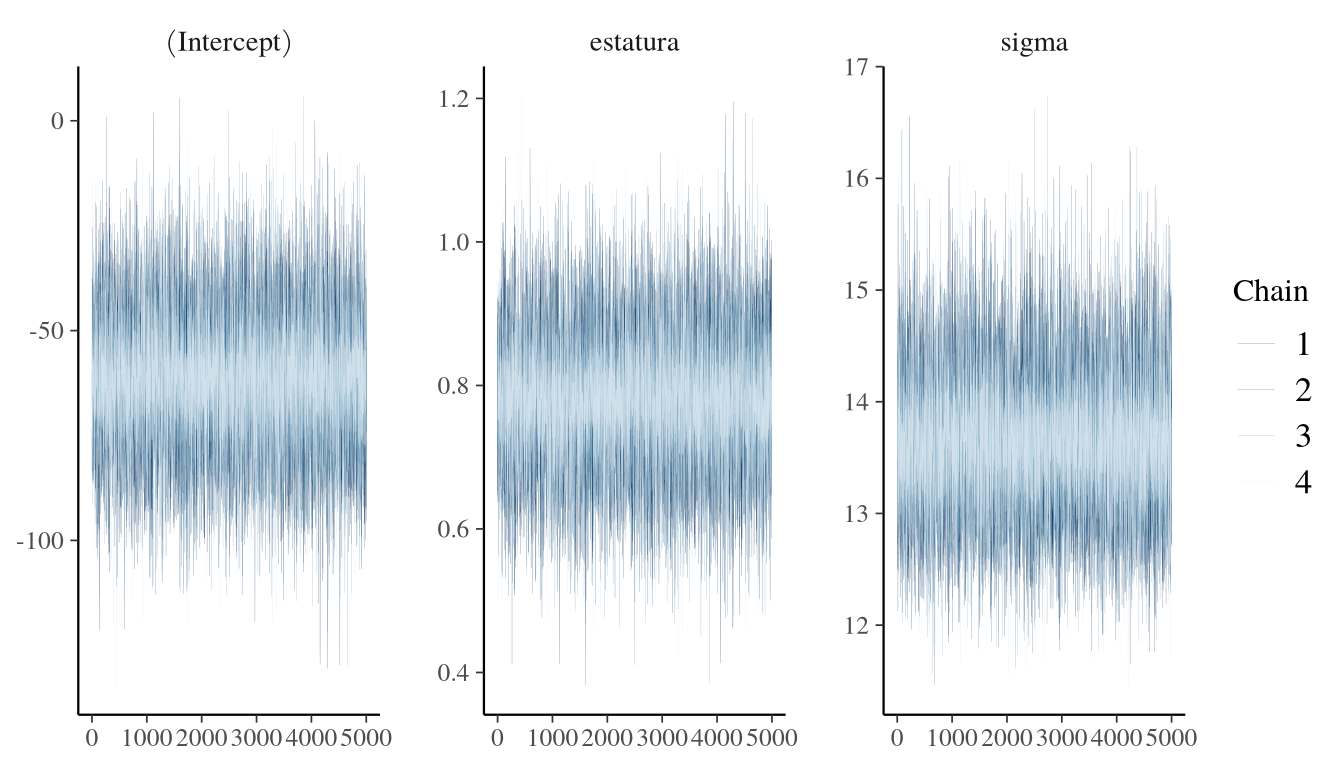
mcmc_dens_overlay(modelo_peso_estatura)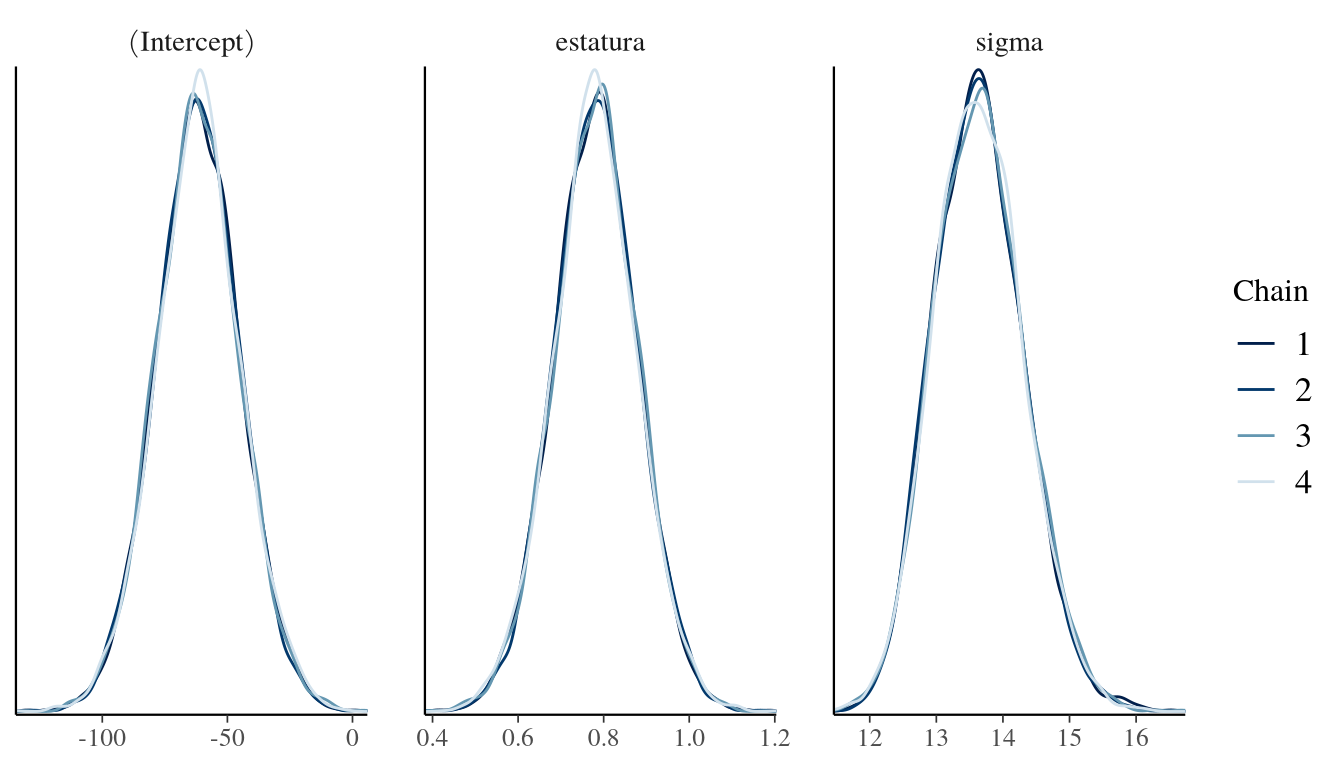
Las cadenas de Markov de los tres parámetros son estables y convergentes. Además, el número efectivo de simulaciones y el valor de \(\hat{R}\) confirman la convergencia:
neff_ratio(modelo_peso_estatura) |> t() |> kable(digits = 3)| (Intercept) | estatura | sigma |
|---|---|---|
| 0.966 | 0.966 | 0.957 |
rhat(modelo_peso_estatura) |> t() |> kable(digits = 3)| (Intercept) | estatura | sigma |
|---|---|---|
| 1 | 1 | 1 |
Cuando no tenemos evidencias fundadas sobre los posibles valores de los parámetros, es preferible usar distribuciones a priori poco informativas. La función stan_glm() puede escalar automáticamente las distribuciones a priori a los datos cuando se indica autoscale = TRUE.
Ejemplo 6.8 Veamos qué distribuciones a priori se usan en el modelo de regresión lineal simple del peso sobre la estatura cuando las especificamos como poco informativas con escalado automático:
modelo_peso_estatura_2 <- stan_glm(peso ~ estatura, data = df, family = gaussian(),
  prior_intercept = normal(0, 2.5, autoscale = TRUE),
  prior = normal(0, 2.5, autoscale = TRUE),
  prior_aux = exponential(1, autoscale = TRUE),
iter = 5000*2, chains = 4, seed = 123)prior_summary(modelo_peso_estatura_2)Priors for model 'modelo_peso_estatura_2'
------
Intercept (after predictors centered)
Specified prior:
~ normal(location = 0, scale = 2.5)
Adjusted prior:
~ normal(location = 0, scale = 39)
Coefficients
Specified prior:
~ normal(location = 0, scale = 2.5)
Adjusted prior:
~ normal(location = 0, scale = 4)
Auxiliary (sigma)
Specified prior:
~ exponential(rate = 1)
Adjusted prior:
~ exponential(rate = 0.064)
------
See help('prior_summary.stanreg') for more detailsEjercicio 6.1 Utiliza la función stan_glm() para ajustar el modelo de regresión del peso sobre el sexo, usando el conjunto de datos peso-estatura y distribuciones a priori poco informativas para los parámetros del modelo. ¿Qué distribuciones a priori propone stan_glm()? ¿Qué representan los parámetros del modelo?
Cuando la variable independiente es categórica, stan_glm() crea automáticamente variables indicadoras (dummy) tomando una categoría como referencia. En el caso del sexo, toma H como referencia y le asigna el valor 0, mientras que a M le asigna el valor 1. El coeficiente sexoM es, por tanto, la diferencia de peso medio de las mujeres respecto a los hombres.
modelo_peso_sexo <- stan_glm(peso ~ sexo, data = df, family = gaussian(),
  prior_intercept = normal(0, 2.5, autoscale = TRUE),
  prior = normal(0, 2.5, autoscale = TRUE),
  prior_aux = exponential(1, autoscale = TRUE),
chains = 4, iter = 5000*2, seed = 123)prior_summary(modelo_peso_sexo)Priors for model 'modelo_peso_sexo'
------
Intercept (after predictors centered)
Specified prior:
~ normal(location = 0, scale = 2.5)
Adjusted prior:
~ normal(location = 0, scale = 39)
Coefficients
Specified prior:
~ normal(location = 0, scale = 2.5)
Adjusted prior:
~ normal(location = 0, scale = 79)
Auxiliary (sigma)
Specified prior:
~ exponential(rate = 1)
Adjusted prior:
~ exponential(rate = 0.064)
------
See help('prior_summary.stanreg') for more detailssexoM es la diferencia de peso medio entre mujeres y hombres, y sigma es la desviación típica del peso dentro de cada grupo.
Igual que en el capítulo anterior, podemos describir las distribuciones a posteriori mediante estadísticos de tendencia central e intervalos de credibilidad. Para extraer las muestras de los parámetros generadas por stan_glm() podemos usar la función gather_draws del paquete tidybayes.
gather_draws()
Devuelve un data frame con las muestras de los parámetros en formato tidy, es decir, con una fila por cada simulación de cada parámetro.
Parámetros:
modelo: modelo ajustado con stan_glm()....: nombres de los parámetros que se quieren extraer.Ejemplo 6.9 Calculamos la media y los intervalos de credibilidad del 90 % de las distribuciones a posteriori de los parámetros del modelo de regresión del peso sobre la estatura:
modelo_peso_estatura |>
  gather_draws(`(Intercept)`, estatura, sigma) |>
  mean_qi(.width = 0.9) |>
kable(digits = 2)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | -61.60 | -89.38 | -33.79 | 0.9 | mean | qi |
| estatura | 0.78 | 0.62 | 0.94 | 0.9 | mean | qi |
| sigma | 13.65 | 12.59 | 14.79 | 0.9 | mean | qi |
Según estos resultados, por cada centímetro más de estatura se espera un incremento del peso de entre 0,62 y 0,94 kg, con una probabilidad del 90 %.
Ejercicio 6.2 Obtén los intervalos de credibilidad del 90 % de las distribuciones a posteriori de los parámetros del modelo de regresión del peso sobre el sexo. ¿Cómo se interpretan?
modelo_peso_sexo |>
  gather_draws(`(Intercept)`, sexoM, sigma) |>
  mean_qi(.width = 0.9) |>
kable(digits = 2)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | 82.85 | 80.78 | 84.93 | 0.9 | mean | qi |
| sexoM | -20.61 | -23.42 | -17.83 | 0.9 | mean | qi |
| sigma | 11.92 | 10.96 | 12.96 | 0.9 | mean | qi |
sexoM.
Cada muestra de la distribución a posteriori de los parámetros define una recta de regresión distinta, y todas ellas reflejan la incertidumbre sobre el modelo. Podemos dibujar algunas de estas rectas para hacernos una idea visual del ajuste con la función add_epred_draws del paquete tidybayes.
add_epred_draws()
Añade al conjunto de datos las predicciones de la media de un modelo de regresión bayesiano ajustado con stan_glm(), una por cada simulación de la distribución a posteriori.
Parámetros:
newdata: conjunto de datos en el que se hacen las predicciones (por defecto, los datos del modelo).modelo: modelo ajustado con stan_glm().ndraws: número de simulaciones de la distribución a posteriori que se quieren dibujar.value: nombre de la columna donde se guardarán las predicciones.Ejemplo 6.10 Dibujamos 50 de las rectas de regresión obtenidas a partir de la simulación de las distribuciones a posteriori de los parámetros:
df |>
  add_epred_draws(modelo_peso_estatura, ndraws = 50, value = "Predicción_media") |>
  ggplot(aes(x = estatura, y = peso)) +
  geom_point(data = df, color = myblue) +
  geom_line(aes(y = Predicción_media, group = .draw), color = myred, alpha = 0.2) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()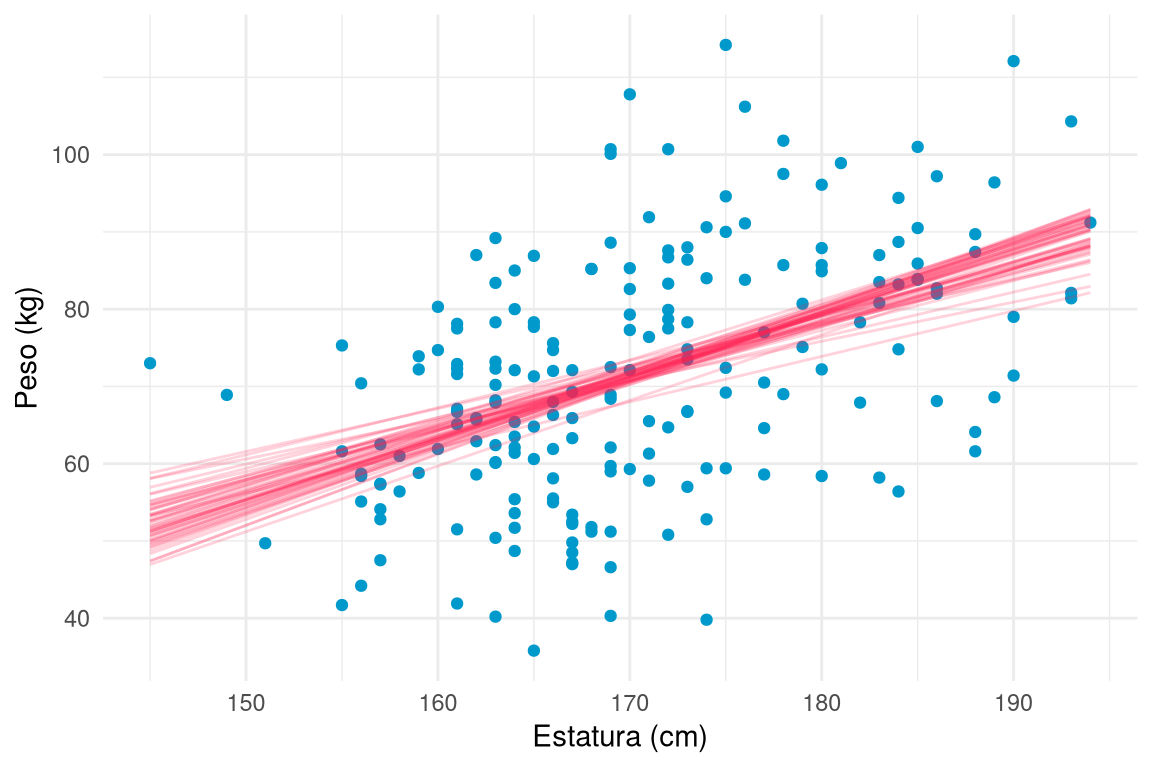
En estadística frecuentista, después de ajustar un modelo de regresión lineal se suele contrastar si cada coeficiente es distinto de cero. Para la pendiente:
\[ H_0: \beta_1 = 0 \qquad \text{frente a} \qquad H_1: \beta_1 \neq 0. \]
Este contraste se realiza con el test t de Student, y proporciona un \(p\)-valor que indica la probabilidad de obtener un valor tan extremo como el observado si la hipótesis nula fuera cierta.
En estadística bayesiana, en cambio, el contraste se realiza comparando las distribuciones a posteriori de los parámetros con un valor de interés, calculando la probabilidad a posteriori de cada hipótesis.
Ejemplo 6.11 Calculamos la probabilidad a posteriori de que la pendiente del modelo de regresión lineal del peso sobre la estatura sea positiva:
\[ H_0: \beta_1 \leq 0 \qquad \text{frente a} \qquad H_1: \beta_1 > 0. \]
modelo_peso_estatura |>
  spread_draws(estatura) |>
  summarise(prob = mean(estatura > 0)) |>
kable(col.names = "P(β1 > 0 | datos)", digits = 3)| P(β1 > 0 | datos) |
|---|
| 1 |
Es decir, podemos afirmar, con total certeza según el modelo, que la pendiente es positiva: a mayor estatura, mayor peso.
Ejercicio 6.3 Realiza un contraste bayesiano para ver si el peso medio de los hombres es mayor que el de las mujeres, y calcula la probabilidad de que esto sea cierto a partir de las distribuciones a posteriori de los parámetros del modelo.
En el modelo del sexo, sexoM mide la diferencia entre el peso medio de las mujeres y el de los hombres, de modo que la hipótesis de interés es \(H_1: \mu_H > \mu_M\), que equivale a \(\beta_{\text{sexoM}} < 0\). Su probabilidad a posteriori es la proporción de muestras de la distribución a posteriori en que sexoM es negativo:
modelo_peso_sexo |>
  spread_draws(sexoM) |>
  summarise(prob_H_mayor_M = mean(sexoM < 0)) |>
kable(digits = 3)| prob_H_mayor_M |
|---|
| 1 |
Una de las principales utilidades de los modelos de regresión es predecir nuevos casos a partir de los valores de las variables independientes.
Al hacer predicciones con un modelo de regresión hay que tener en cuenta dos fuentes de variabilidad:
Dado un nuevo caso con un valor concreto de la variable independiente \(\hat{x}\), podemos estar interesados en dos tipos de predicciones:
Para predecir la media de la variable dependiente para un nuevo caso basta con aplicar
\[ E[Y|\hat{x}] = \beta_0 + \beta_1\hat{x} \]
a cada una de las simulaciones de los parámetros del modelo. Para ello podemos usar la función epred_draws del paquete tidybayes.
epred_draws()
Genera una simulación de la distribución a posteriori de la predicción de la media de la variable dependiente para nuevos casos, a partir de un modelo de regresión bayesiano ajustado con stan_glm().
Parámetros:
modelo: modelo ajustado con stan_glm().newdata: nuevos casos para los que se quiere hacer la predicción, en un data frame con las mismas variables independientes que el modelo.value: nombre de la columna donde se guardarán las predicciones.Ejemplo 6.12 Obtenemos la distribución a posteriori de la predicción del peso medio para una persona de estatura 180 cm:
datos_nuevos <- tibble(estatura = c(180))
pred_media_180 <- epred_draws(modelo_peso_estatura, newdata = datos_nuevos, value = "Predicción_media")
pred_media_180
# A tibble: 20,000 × 6
# Groups: estatura, .row [1]
estatura .row .chain .iteration .draw Predicción_media
<dbl> <int> <int> <int> <int> <dbl>
1 180 1 NA NA 1 78.1
2 180 1 NA NA 2 82.4
3 180 1 NA NA 3 81.6
4 180 1 NA NA 4 79.0
5 180 1 NA NA 5 78.5
6 180 1 NA NA 6 77.0
7 180 1 NA NA 7 80.1
8 180 1 NA NA 8 77.2
9 180 1 NA NA 9 80.6
10 180 1 NA NA 10 81.1
# ℹ 19,990 more rowsObtendríamos lo mismo calculando directamente la fórmula con las simulaciones de los parámetros:
modelo_peso_estatura |>
  spread_draws(`(Intercept)`, estatura) |>
  mutate(Predicción_media = `(Intercept)` + estatura * 180) |>
  head() |>
kable(digits = 2)| .chain | .iteration | .draw | (Intercept) | estatura | Predicción_media |
|---|---|---|---|---|---|
| 1 | 1 | 1 | -73.52 | 0.84 | 78.14 |
| 1 | 2 | 2 | -83.63 | 0.92 | 82.36 |
| 1 | 3 | 3 | -81.76 | 0.91 | 81.56 |
| 1 | 4 | 4 | -37.58 | 0.65 | 78.95 |
| 1 | 5 | 5 | -75.57 | 0.86 | 78.55 |
| 1 | 6 | 6 | -44.35 | 0.67 | 76.95 |
Describimos la distribución a posteriori de la predicción con su media y su intervalo de credibilidad:
mean_qi(pred_media_180, .width = 0.9) |>
kable(digits = 2)| estatura | .row | Predicción_media | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|
| 180 | 1 | 79.03 | 76.8 | 81.29 | 0.9 | mean | qi |
Es decir, para una persona de 180 cm el peso medio estaría entre unos 77 y 81 kg, con una probabilidad del 90 %.
Para predecir un nuevo valor de la variable dependiente, debemos tener en cuenta tanto la variabilidad de los parámetros como la del muestreo:
\[ Y|\hat{x},\beta_0,\beta_1,\sigma \sim N(\beta_0 + \beta_1 \hat{x}, \sigma). \]
Para obtener una muestra de esta distribución basta con generar un valor normal para cada simulación de los parámetros:
\[ \begin{align*} \beta_{0,1}, \beta_{1,1}, \sigma_1 &\longrightarrow \hat{y}_1 = \text{rnorm}(1, \beta_{0,1} + \beta_{1,1} \hat{x}, \sigma_1) \\ \beta_{0,2}, \beta_{1,2}, \sigma_2 &\longrightarrow \hat{y}_2 = \text{rnorm}(1, \beta_{0,2} + \beta_{1,2} \hat{x}, \sigma_2) \\ &\vdots \\ \beta_{0,n}, \beta_{1,n}, \sigma_n &\longrightarrow \hat{y}_n = \text{rnorm}(1, \beta_{0,n} + \beta_{1,n} \hat{x}, \sigma_n) \end{align*} \]
Podemos hacerlo con la función predicted_draws del paquete tidybayes.
predicted_draws()
Genera una simulación de la distribución a posteriori de la predicción de un nuevo valor de la variable dependiente para nuevos casos, a partir de un modelo de regresión bayesiano ajustado con stan_glm().
Parámetros:
modelo: modelo ajustado con stan_glm().newdata: nuevos casos para los que se quiere hacer la predicción, en un data frame con las mismas variables independientes que el modelo.value: nombre de la columna donde se guardarán las predicciones.Ejemplo 6.13 Obtenemos la distribución a posteriori de la predicción de un nuevo valor del peso para una persona de 180 cm:
pred_180 <- predicted_draws(modelo_peso_estatura, newdata = datos_nuevos, value = "Predicción")
mean_qi(pred_180, .width = 0.9) |> kable(digits = 1)| estatura | .row | Predicción | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|
| 180 | 1 | 79 | 56.2 | 101.4 | 0.9 | mean | qi |
Es decir, el rango de pesos factibles para una persona de 180 cm está entre unos 56 y 101 kg, con una probabilidad del 90 %. No todos los valores de esta distribución son igualmente probables, por lo que a menudo es más útil representarla gráficamente:
ggplot(pred_180, aes(x = Predicción)) +
  stat_halfeye(.width = 0.9, fill = myblue, alpha = 0.5) +
  labs(x = "Peso (kg)", y = "Densidad")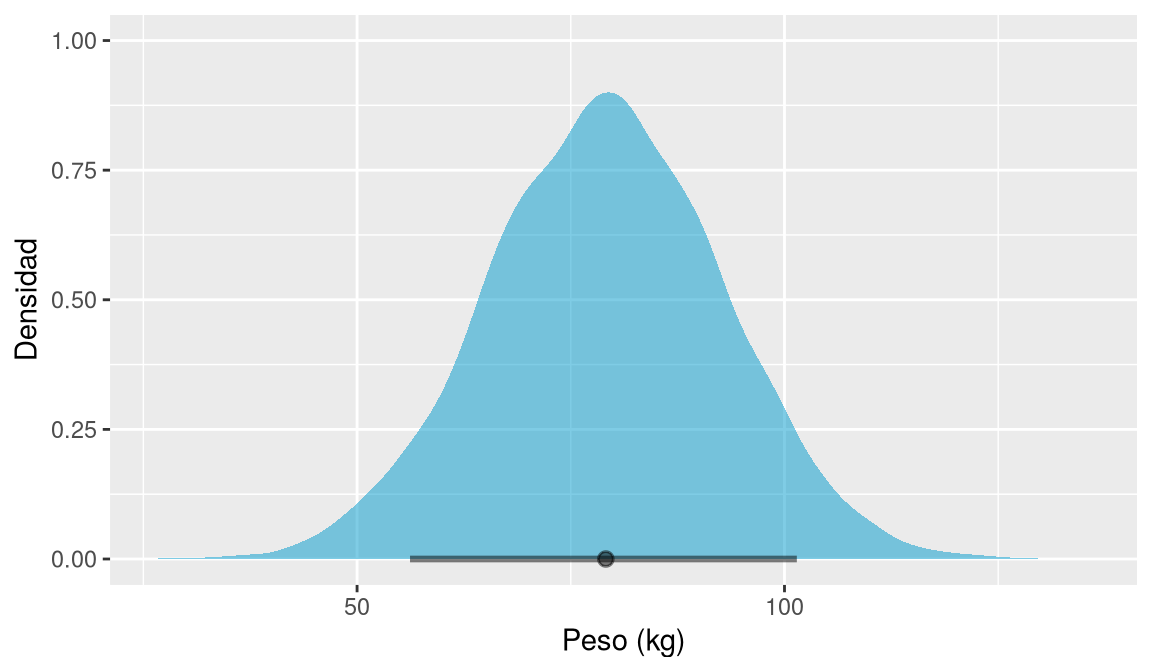
La siguiente gráfica muestra sobre el diagrama de dispersión el intervalo de credibilidad para la predicción de la media (en verde) y para la predicción de un nuevo valor (en rojo) de una persona de 180 cm:
ggplot(df, aes(x = estatura, y = peso)) +
  geom_point(color = myblue) +
  stat_pointinterval(
    data = pred_180,
    aes(x = estatura, y = Predicción),
    .width = 0.9, color = myred, size = 5
  ) +
  stat_pointinterval(
    data = pred_media_180,
    aes(x = estatura, y = Predicción_media),
    .width = 0.9, color = mygreen, size = 5
  ) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()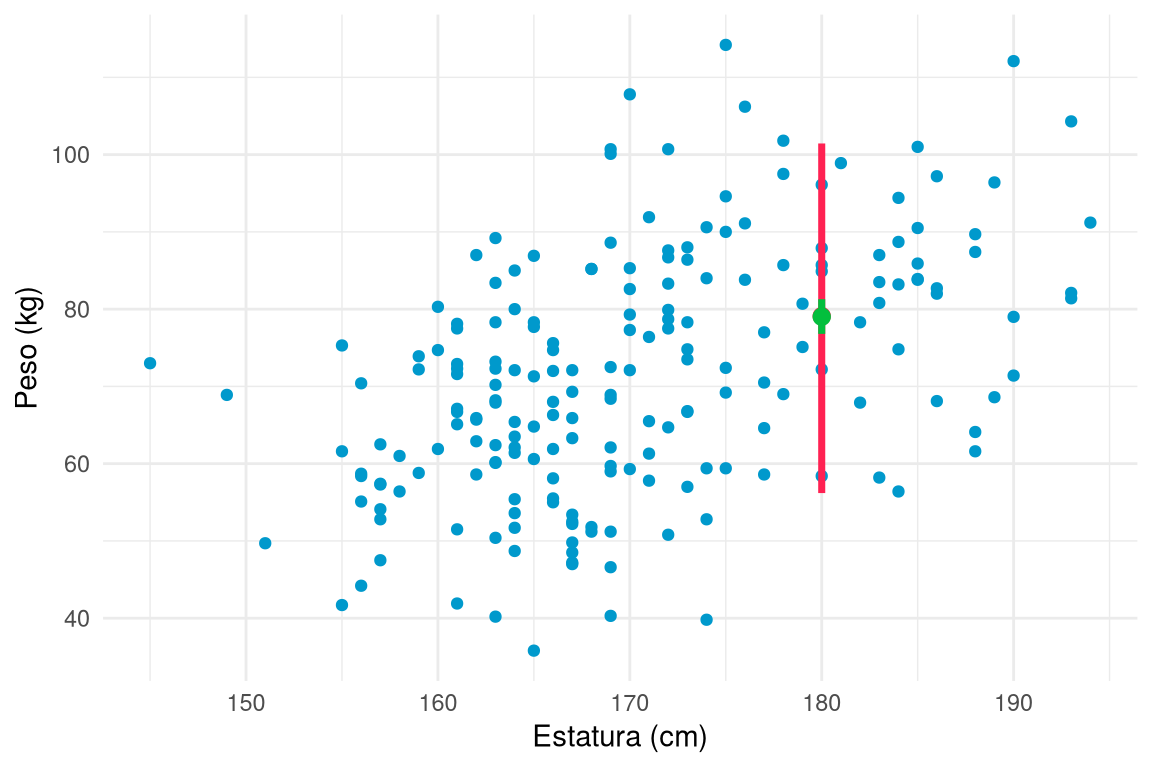
Ejercicio 6.4 Calcula la predicción de la media y de un nuevo valor del peso para un hombre y para una mujer, usando el modelo de regresión del peso sobre el sexo. Obtén los intervalos de credibilidad del 90 % de cada predicción y representalos gráficamente sobre el diagrama de dispersión de los datos.
datos_nuevos_sexo <- tibble(sexo = c("H", "M"))
pred_media_sexo <- epred_draws(modelo_peso_sexo, newdata = datos_nuevos_sexo, value = "Predicción_media")
mean_qi(pred_media_sexo, .width = 0.9) |> kable(digits = 1)| sexo | .row | Predicción_media | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|
| H | 1 | 82.8 | 80.8 | 84.9 | 0.9 | mean | qi |
| M | 2 | 62.2 | 60.4 | 64.1 | 0.9 | mean | qi |
pred_sexo <- predicted_draws(modelo_peso_sexo, newdata = datos_nuevos_sexo, value = "Predicción")
mean_qi(pred_sexo, .width = 0.9) |> kable(digits = 1)| sexo | .row | Predicción | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|
| H | 1 | 82.8 | 63.2 | 102.5 | 0.9 | mean | qi |
| M | 2 | 62.3 | 42.6 | 82.2 | 0.9 | mean | qi |
ggplot(df, aes(x = sexo, y = peso)) +
  geom_jitter(color = myblue, alpha = 0.4, width = 0.1) +
  stat_pointinterval(
    data = pred_media_sexo,
    aes(x = sexo, y = Predicción_media),
    .width = 0.9, color = mygreen, linewidth = 3, size = 5
  ) +
  stat_pointinterval(
    data = pred_sexo,
    aes(x = sexo, y = Predicción),
    .width = 0.9, color = myred, linewidth = 1, size = 3
  ) +
  labs(x = "Sexo", y = "Peso (kg)") +
  theme_minimal()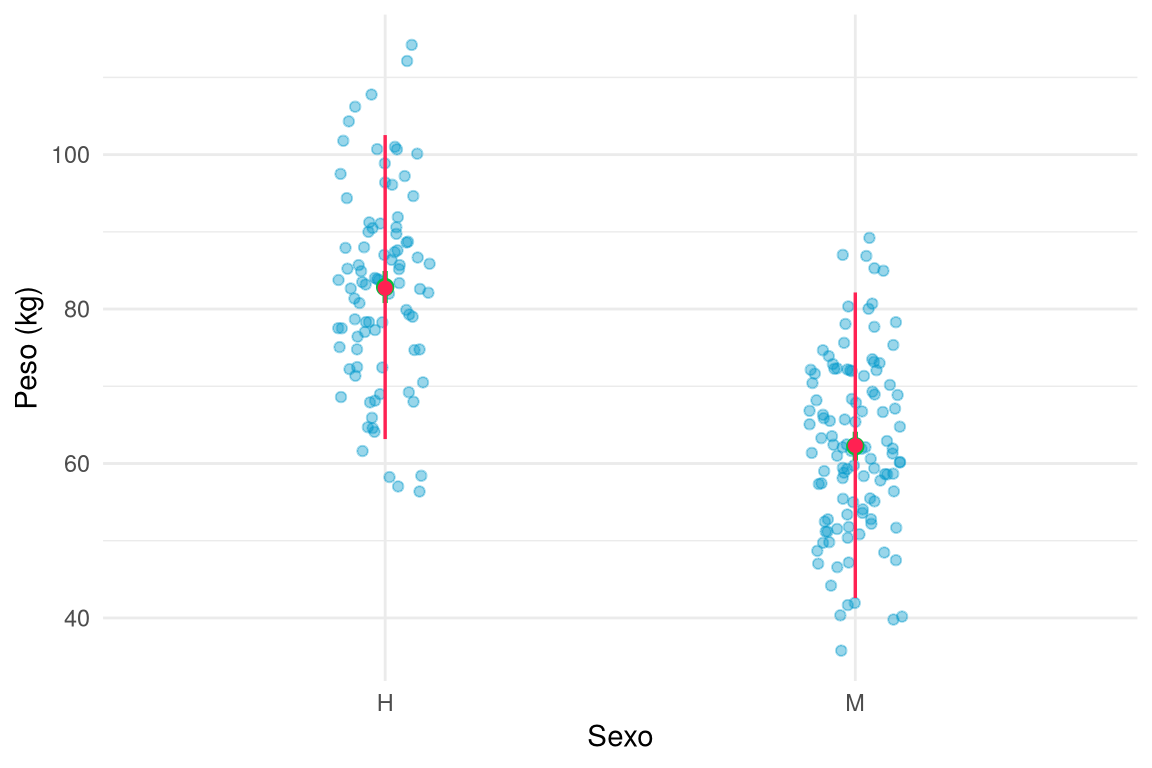
Todos los modelos de regresión son aproximaciones de la realidad. Por eso es importante evaluar la calidad del ajuste, sobre todo si queremos hacer predicciones con el modelo. La forma más lógica de hacerlo es comparar las predicciones con los valores observados y medir la discrepancia entre ambos.
Para ello, primero obtenemos la distribución a posteriori de la predicción para cada caso de la muestra con predicted_draws():
Ejemplo 6.14 Calculamos los intervalos de credibilidad de las predicciones para cada una de las estaturas del conjunto de datos:
post_pred <- predicted_draws(modelo_peso_estatura, newdata = df, value = "Predicción")
ggplot(post_pred, aes(x = estatura, y = Predicción)) +
  stat_pointinterval(.width = c(0.5, 0.95), color = myred) +
  geom_point(data = df, aes(y = peso), color = myblue) +
  labs(x = "Estatura (cm)", y = "Peso (kg)")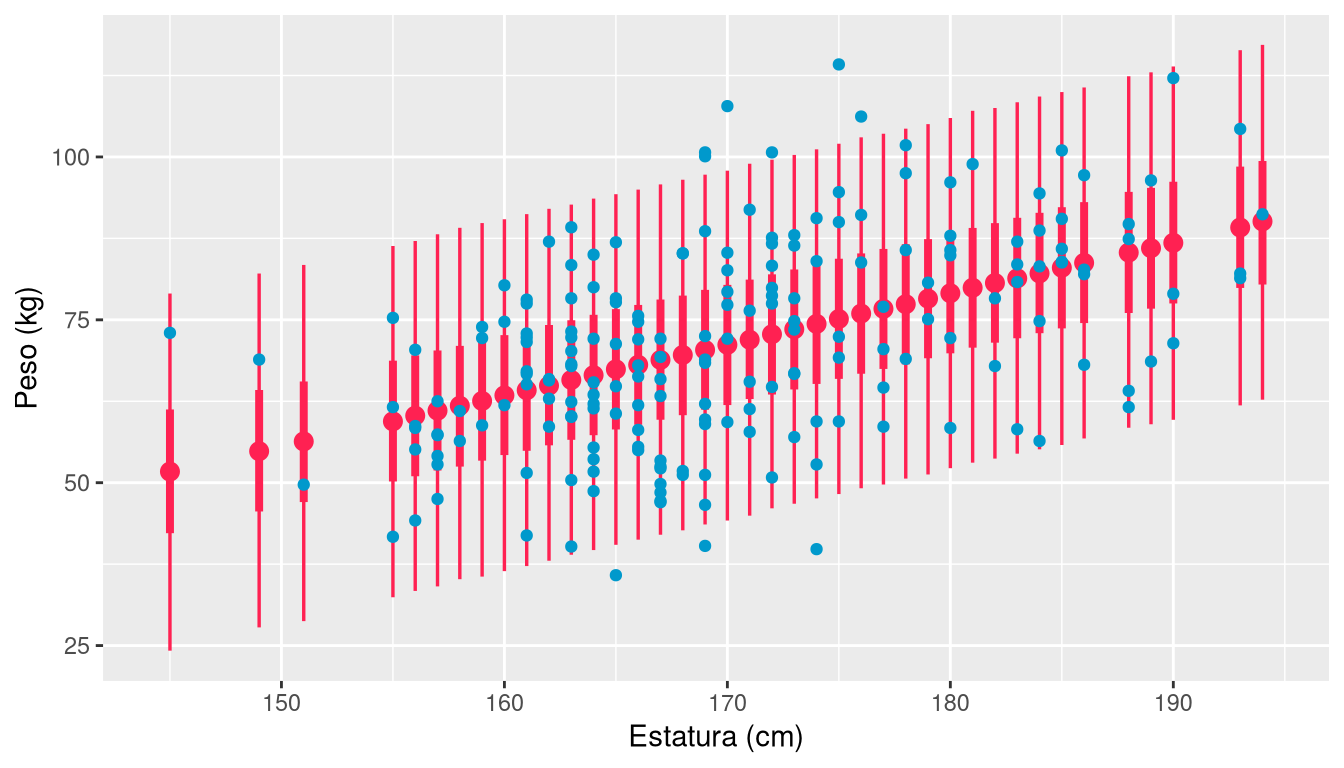
Una vez generadas las distribuciones a posteriori de las predicciones para cada caso de la muestra, podemos usar las siguientes métricas para evaluar la precisión del modelo:
\[ MAE = \mbox{Mediana}\{|y_i - \hat{y}_i|\}. \]
\[ MAE_t = \mbox{Mediana}\left\{\frac{|y_i - \hat{y}_i|}{\sigma_y}\right\}. \]
\[ RMSE = \sqrt{\frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2}. \]
\[ R^2_{\mbox{Bayes}} = \frac{\mbox{Var}(\hat{y})}{\mbox{Var}(\hat{y}) + \mbox{Var}(y - \hat{y})}. \]
Para calcular el error absoluto mediano, el error absoluto mediano tipificado y la cobertura de los intervalos podemos usar la función prediction_summary() del paquete bayesrules.
prediction_summary()
Devuelve el error absoluto mediano, el error absoluto mediano tipificado y las coberturas de los intervalos de las predicciones de un modelo de regresión bayesiano.
Parámetros:
model: modelo de regresión bayesiano ajustado con stan_glm().data: conjunto de datos con la variable dependiente y las variables independientes.prob_inner: nivel de credibilidad del intervalo interior. Por defecto 50 %.prob_outer: nivel de credibilidad del intervalo exterior. Por defecto 90 %.Ejemplo 6.15 Calculamos las métricas del modelo de regresión lineal simple del peso sobre la estatura:
library(bayesrules)
prediction_summary(modelo_peso_estatura, data = df, prob_outer = 0.9) |> kable(digits = 2)| mae | mae_scaled | within_50 | within_90 |
|---|---|---|---|
| 9.15 | 0.66 | 0.5 | 0.92 |
Así, en los 200 individuos de la muestra, el peso observado se encuentra típicamente a unos 9,2 kg de la mediana de la distribución predictiva correspondiente a su estatura, es decir, a unas 0,66 desviaciones típicas. Además, el 50 % de los pesos cae dentro del intervalo de credibilidad del 50 % y el 92 % cae dentro del intervalo del 90 %.
Para calcular el coeficiente de determinación bayesiano \(R^2\) podemos usar la función bayes_R2() del paquete rstanarm.
bayes_R2()
Calcula la distribución a posteriori del coeficiente de determinación bayesiano \(R^2\) de un modelo de regresión bayesiano ajustado con stan_glm().
Parámetros:
object: modelo de regresión bayesiano ajustado con stan_glm().Ejemplo 6.16 Calculamos la distribución a posteriori del coeficiente de determinación del modelo de regresión lineal simple:
bayes_R2(modelo_peso_estatura) |>
  mean_qi(.width = 0.9) |>
kable(digits = 3, col.names = c("R² medio", ".lower", ".upper", ".width", ".point", ".interval"))| R² medio | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 0.238 | 0.159 | 0.319 | 0.9 | mean | qi |
El modelo explica en torno al 24 % de la variabilidad del peso y, con una probabilidad del 90 %, entre el 16 % y el 32 %.
Ejercicio 6.5 Calcula las métricas de evaluación del modelo de regresión del peso sobre el sexo. ¿Qué conclusiones se pueden extraer?
prediction_summary(modelo_peso_sexo, data = df, prob_outer = 0.9) |> kable(digits = 2)| mae | mae_scaled | within_50 | within_90 |
|---|---|---|---|
| 8.03 | 0.67 | 0.5 | 0.9 |
bayes_R2(modelo_peso_sexo) |>
  mean_qi(.width = 0.9) |>
kable(digits = 3, col.names = c("R² medio", ".lower", ".upper", ".width", ".point", ".interval"))| R² medio | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 0.426 | 0.345 | 0.501 | 0.9 | mean | qi |
En general, un modelo de regresión se ajusta mejor a los datos con los que se ha construido que a otros datos nuevos. Este problema se conoce como sobreajuste (overfitting).
Cuando hay sobreajuste, las medidas de precisión evaluadas sobre el propio conjunto de datos sobreestiman la capacidad predictiva del modelo. Por eso es importante evaluar la predicción en datos nuevos. Para ello se suele dividir el conjunto de datos en dos subconjuntos:
Para obtener una estimación más fiable de la precisión predictiva, es recomendable repetir el proceso con distintos conjuntos de entrenamiento y prueba, y promediar las métricas obtenidas. Esta es la idea de la validación cruzada: dividir los datos en \(k\) subconjuntos llamados pliegues (folds) y realizar \(k\) iteraciones. En cada una se reserva un pliegue como conjunto de prueba y se ajusta el modelo con los \(k-1\) restantes. Al final se promedian las métricas de las \(k\) iteraciones.
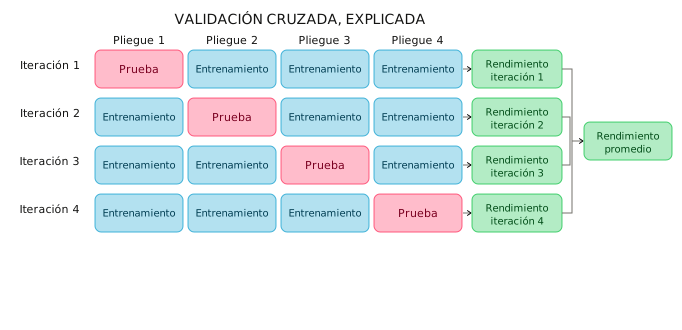
Para evaluar un modelo de regresión mediante validación cruzada podemos usar la función prediction_summary_cv() del paquete bayesrules.
prediction_summary_cv()
Devuelve el error absoluto mediano, el error absoluto mediano tipificado y las coberturas de los intervalos de las predicciones de un modelo de regresión bayesiano mediante validación cruzada.
Parámetros:
model: modelo de regresión bayesiano ajustado con stan_glm().data: conjunto de datos.k: número de pliegues.prob_inner: nivel de credibilidad del intervalo interior. Por defecto 50 %.prob_outer: nivel de credibilidad del intervalo exterior. Por defecto 90 %.Ejemplo 6.17 Evaluamos el modelo de regresión lineal simple del peso sobre la estatura mediante validación cruzada con 10 pliegues:
set.seed(123)
eval_cv <- prediction_summary_cv(model = modelo_peso_estatura, data = df, k = 10, prob_outer = 0.9)
eval_cv$cv |> kable(digits = 2)| mae | mae_scaled | within_50 | within_90 |
|---|---|---|---|
| 9.75 | 0.71 | 0.5 | 0.9 |
Comparadas con las métricas obtenidas sobre todo el conjunto de datos, las métricas por validación cruzada son un poco peores, pero más realistas.
Ejercicio 6.6 Evalúa el modelo de regresión del peso sobre el sexo mediante validación cruzada con 10 pliegues. ¿Qué conclusiones se pueden extraer?
set.seed(123)
eval_cv <- prediction_summary_cv(model = modelo_peso_sexo, data = df, k = 10, prob_outer = 0.9)
eval_cv$cv |> kable(digits = 2)| mae | mae_scaled | within_50 | within_90 |
|---|---|---|---|
| 8.13 | 0.68 | 0.5 | 0.9 |
Cuando la variable dependiente \(Y\) depende de varias variables independientes \(X_1, X_2, \ldots, X_p\) hablamos de regresión lineal múltiple:
\[ Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \cdots + \beta_p X_p + \varepsilon, \quad \varepsilon \sim N(0, \sigma). \]
El procedimiento para ajustar un modelo de regresión lineal múltiple con inferencia bayesiana es el mismo que para la regresión simple, solo que hay más parámetros y hay que especificar la distribución a priori de cada uno.
Ejercicio 6.7 ¿Qué modelo de regresión lineal múltiple ajustarías para modelizar el peso de una persona en función de su estatura y su sexo? ¿Qué distribuciones a priori utilizarías para los parámetros del modelo?
Como el sexo es una variable categórica, debemos codificarla numéricamente para introducirla en el modelo (por ejemplo, 0 para hombres y 1 para mujeres).
Si llamamos \(X_1\) a la estatura y \(X_2\) al sexo, el modelo sería
\[ Y|\beta_0, \beta_1, \beta_2, \sigma \sim N(\beta_0 + \beta_1 X_1 + \beta_2 X_2, \sigma). \]
De esta manera, para cada sexo el modelo proporciona una recta de regresión distinta:
Este modelo asume que la pendiente es la misma para hombres y mujeres, pero que el término independiente es distinto.
Para \(\beta_0\), \(\beta_1\) y \(\sigma\) podemos usar las mismas distribuciones a priori que en el modelo simple. Para \(\beta_2\) podemos usar una normal que refleje la diferencia de peso entre hombres y mujeres, que sabemos por experiencia que es negativa. Por ejemplo, \(\beta_2 \sim N(-10, 5)\) refleja que, para una misma estatura, las mujeres pesan unos 10 kg menos, con una desviación típica de 5 kg.Como en los modelos simples, antes de ajustar el modelo conviene comprobar que las distribuciones a priori son razonables. Podemos hacerlo con la misma función stan_glm(), añadiendo la opción prior_PD = TRUE, que simula a partir de las distribuciones a priori sin usar los datos.
Ejemplo 6.18 Simulamos las distribuciones a priori del modelo de regresión lineal múltiple del peso sobre la estatura y el sexo:
library(rstanarm)
set.seed(123)
modelo_peso_estatura_sexo_prior <- stan_glm(
  peso ~ estatura + sexo,
  data = df,
  family = gaussian(),
  prior_intercept = normal(70, 10),
  prior = normal(location = c(2, -10), scale = c(1, 5)),
  prior_aux = exponential(0.5),
  chains = 4, iter = 5000 * 2, seed = 123,
  prior_PD = TRUE
)stan_glm() codifica las variables categóricas de forma automática: la primera categoría en orden alfabético se toma como referencia (código 0) y la segunda recibe el código 1.
Dibujamos algunas de las rectas de regresión que se obtienen de las distribuciones a priori para comprobar que son razonables:
df |>
  add_epred_draws(modelo_peso_estatura_sexo_prior, ndraws = 50, value = "Predicción_media") |>
  ggplot(aes(x = estatura, y = peso, color = sexo)) +
  geom_line(aes(y = Predicción_media, group = paste(sexo, .draw)), alpha = 0.2) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()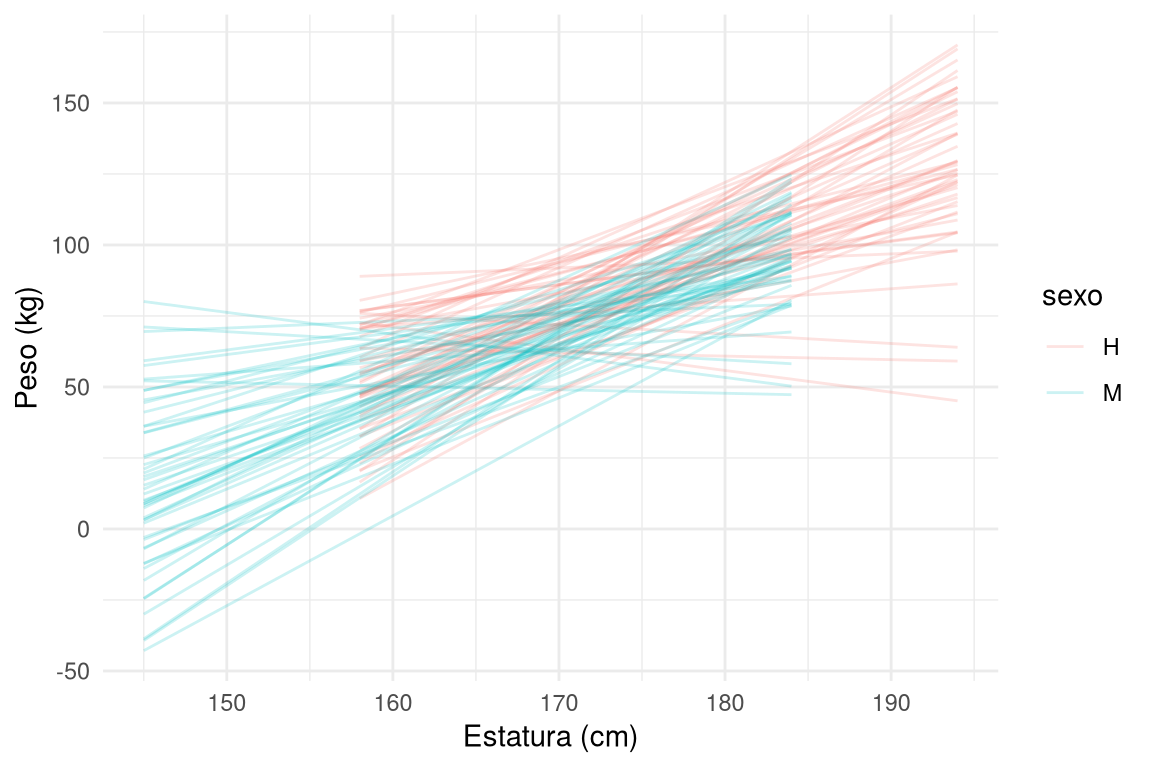
Una vez validadas las distribuciones a priori, no hace falta volver a especificarlas. Basta con actualizar el modelo anterior con update() y prior_PD = FALSE, para que las distribuciones a posteriori se ajusten a partir de los datos:
Ejemplo 6.19
modelo_peso_estatura_sexo <- update(modelo_peso_estatura_sexo_prior, prior_PD = FALSE)Comprobamos la convergencia de las cadenas de Markov:
mcmc_trace(modelo_peso_estatura_sexo, size = 0.2)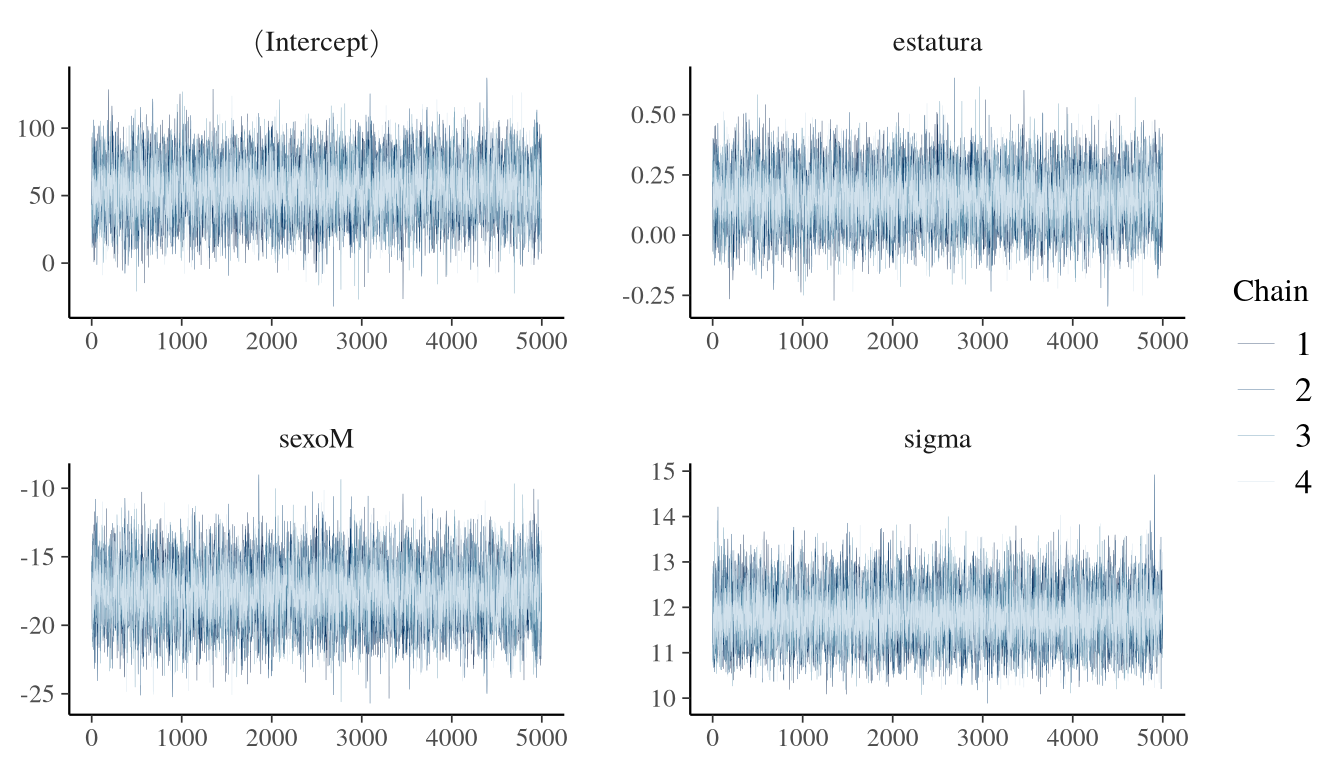
mcmc_dens_overlay(modelo_peso_estatura_sexo)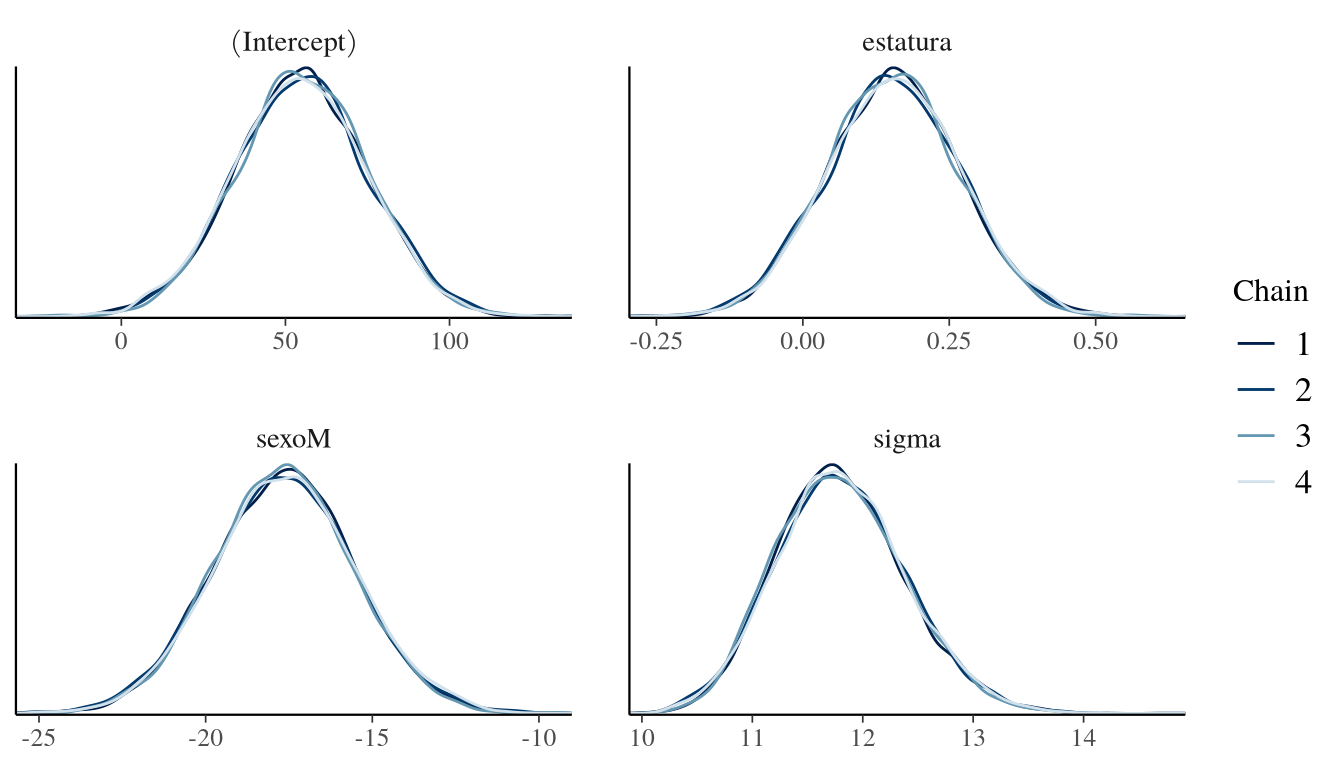
neff_ratio(modelo_peso_estatura_sexo) |> t() |> kable(digits = 3)| (Intercept) | estatura | sexoM | sigma |
|---|---|---|---|
| 0.576 | 0.588 | 0.597 | 0.831 |
rhat(modelo_peso_estatura_sexo) |> t() |> kable(digits = 3)| (Intercept) | estatura | sexoM | sigma |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
Las cadenas son estables y convergentes: el número efectivo de simulaciones es razonablemente alto para todos los parámetros y el valor de \(\hat{R}\) es prácticamente 1.
Ejemplo 6.20 Calculamos la media y los intervalos de credibilidad del 90 % de los parámetros del modelo de regresión del peso sobre la estatura y el sexo:
modelo_peso_estatura_sexo |>
  gather_draws(`(Intercept)`, estatura, sexoM, sigma) |>
  mean_qi(.width = 0.9) |>
kable(digits = 2)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | 54.86 | 21.48 | 88.22 | 0.9 | mean | qi |
| estatura | 0.15 | -0.03 | 0.34 | 0.9 | mean | qi |
| sexoM | -17.65 | -21.12 | -14.16 | 0.9 | mean | qi |
| sigma | 11.80 | 10.88 | 12.81 | 0.9 | mean | qi |
Cuando se controla por el sexo, por cada centímetro más de estatura se espera un incremento de peso de entre −0,03 y 0,34 kg, tanto para hombres como para mujeres. Por otro lado, cuando se controla por la estatura, se espera que las mujeres pesen entre 14,2 y 21,1 kg menos que los hombres.
Ejemplo 6.21 Dibujamos 50 de las rectas de regresión de la distribución a posteriori del modelo de regresión múltiple:
df |>
  add_epred_draws(modelo_peso_estatura_sexo, ndraws = 50, value = "Predicción_media") |>
  ggplot(aes(x = estatura, y = peso, color = sexo)) +
  geom_point(data = df) +
  geom_line(aes(y = Predicción_media, group = paste(sexo, .draw)), alpha = 0.2) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()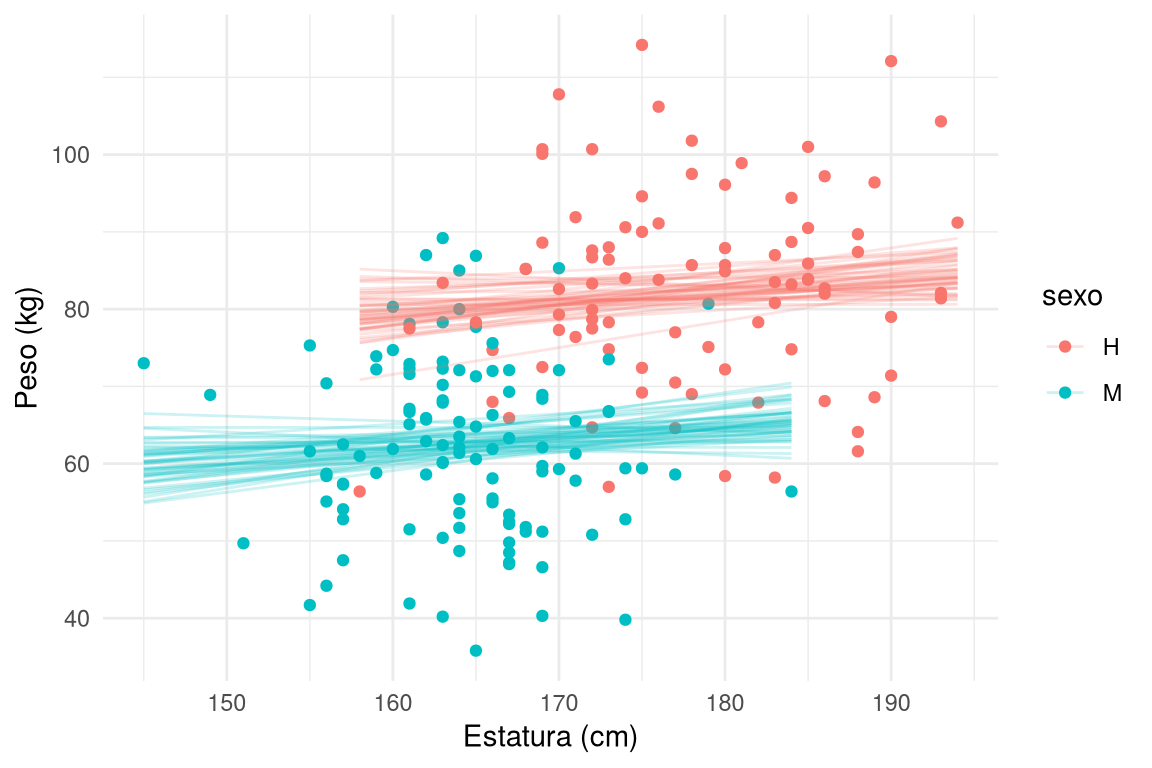
Se observa una relación positiva entre la estatura y el peso, de menor magnitud que en el modelo simple, y que, para la misma estatura, las mujeres tienen un peso medio menor que los hombres, algo coherente con la experiencia.
Ejemplo 6.22 Obtenemos la distribución a posteriori de la predicción del peso para un hombre y una mujer de 160 cm:
datos_nuevos <- tibble(estatura = c(160, 160), sexo = c("H", "M"))
post_pred_160 <- predicted_draws(modelo_peso_estatura_sexo, newdata = datos_nuevos, value = "Predicción")
mean_qi(post_pred_160, .width = 0.9) |> kable(digits = 1)| estatura | sexo | .row | Predicción | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|---|
| 160 | H | 1 | 79.7 | 60.0 | 99.6 | 0.9 | mean | qi |
| 160 | M | 2 | 62.0 | 42.6 | 81.4 | 0.9 | mean | qi |
Un hombre de 160 cm tendría un peso entre unos 60 y 100 kg con una probabilidad del 90 %, mientras que una mujer de la misma estatura tendría un peso entre unos 43 y 81 kg.
predicted_draws(modelo_peso_estatura_sexo, newdata = tibble(estatura = c(160, 160), sexo = c("H", "M")), value = "Predicción") |>
  ggplot(aes(x = Predicción, y = sexo, color = sexo)) +
  stat_halfeye(.width = c(0.5, 0.9), fill = "gray90") +
  scale_y_discrete(labels = c("H" = "Hombre", "M" = "Mujer")) +
  labs(x = "Peso (kg)", y = "Sexo") +
  theme_minimal()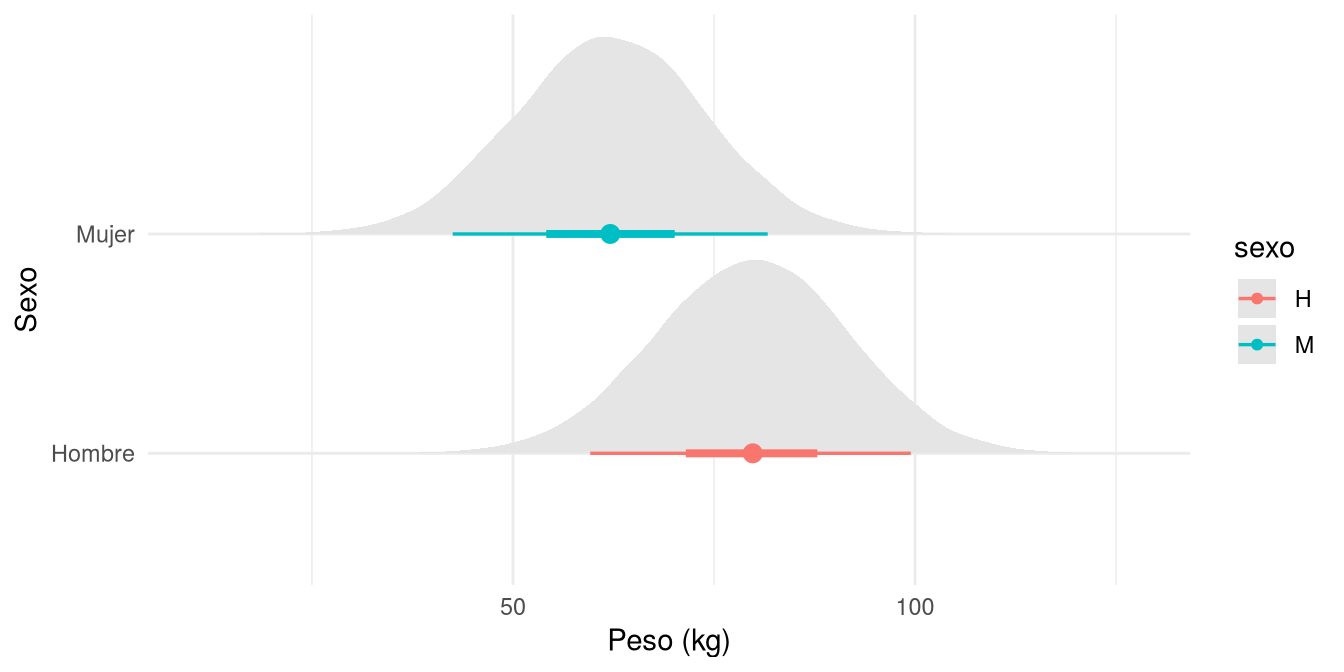
Ejemplo 6.23 Obtenemos las distribuciones predictivas del peso para todas las personas de la muestra:
post_pred <- predicted_draws(modelo_peso_estatura_sexo, newdata = df, value = "Predicción")
ggplot(post_pred, aes(x = estatura, y = Predicción, color = sexo)) +
  stat_pointinterval(.width = c(0.5, 0.95), position = position_dodge(width = 0.5)) +
  geom_point(data = df, aes(y = peso), position = position_dodge(width = 0.5)) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()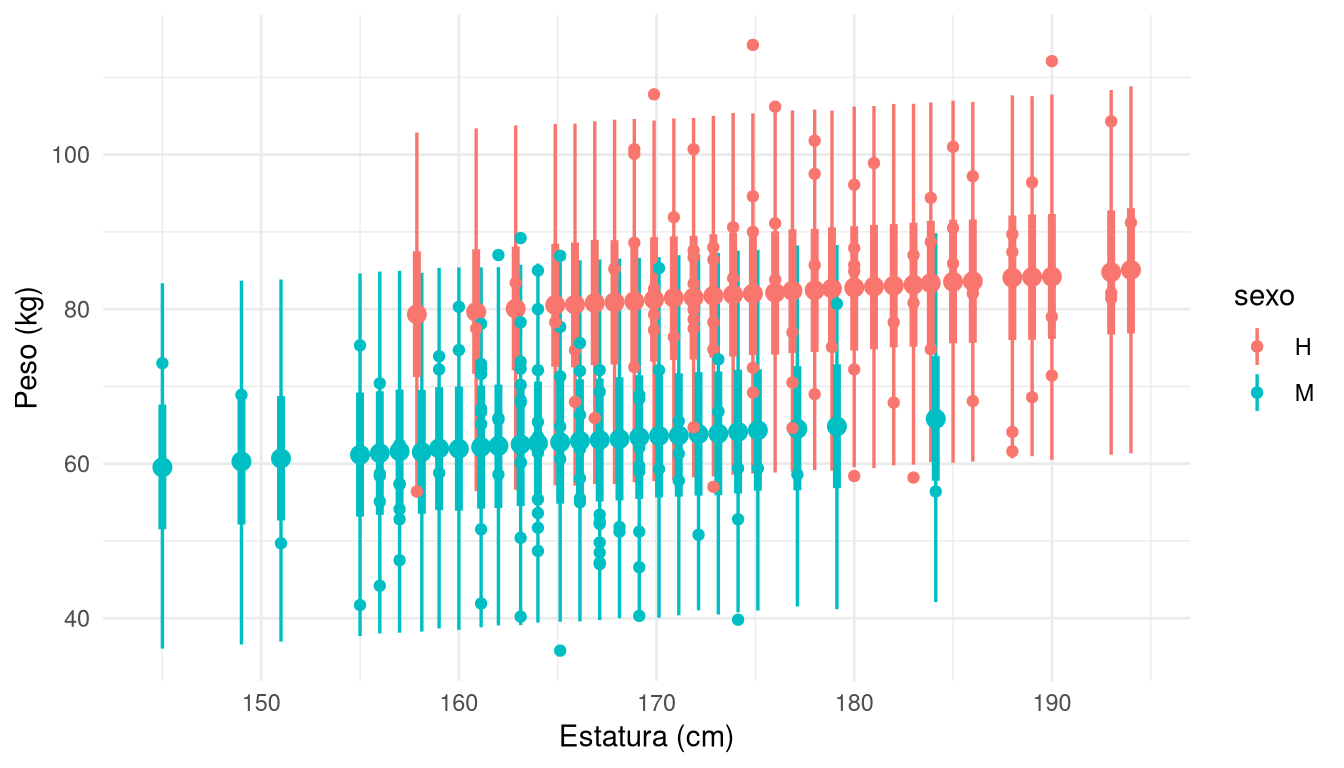
Ejemplo 6.24 Evaluamos el modelo de regresión múltiple mediante validación cruzada con 10 pliegues:
set.seed(123)
eval_cv <- prediction_summary_cv(model = modelo_peso_estatura_sexo, data = df, k = 10, prob_outer = 0.9)
eval_cv$cv |> kable(digits = 2)| mae | mae_scaled | within_50 | within_90 |
|---|---|---|---|
| 8.28 | 0.7 | 0.5 | 0.88 |
El error absoluto mediano por validación cruzada baja de unos 9,7 kg (modelo simple con la estatura) a unos 8,3 kg. Es prácticamente el mismo valor que el del modelo con solo el sexo (unos 8,1 kg, como vimos antes), así que la mejora procede sobre todo del sexo.
El coeficiente de determinación bayesiano del modelo múltiple es:
bayes_R2(modelo_peso_estatura_sexo) |>
  mean_qi(.width = 0.9) |>
kable(digits = 3, col.names = c("R² medio", ".lower", ".upper", ".width", ".point", ".interval"))| R² medio | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 0.415 | 0.336 | 0.488 | 0.9 | mean | qi |
El modelo de regresión múltiple explica alrededor del 42 % de la variabilidad del peso, algo más que el modelo de regresión simple.
En general, cuantas más variables independientes añadimos a un modelo de regresión, mayor es el coeficiente de determinación, porque la variabilidad no explicada disminuye. Sin embargo, eso no significa que el modelo sea mejor, ya que al aumentar el número de variables también aumenta el sobreajuste.
Para comparar la capacidad predictiva de distintos modelos, podemos usar la densidad logarítmica predictiva esperada (ELPD), que penaliza la complejidad del modelo y permite comparar modelos con distinto número de variables independientes.
La ELPD mide el logaritmo de la densidad predictiva de los valores observados según el modelo ajustado con los datos de entrenamiento. Se calcula normalmente con validación cruzada de \(n\) pliegues, conocida como leave-one-out cross-validation (LOO-CV): en cada iteración se reserva un caso como prueba y se ajusta el modelo con los demás.
Para cada caso \(y_i\) de la muestra \((y_1, y_2, \ldots, y_n)\) se calcula el logaritmo de su densidad predictiva según el modelo ajustado sin ese caso:
\[ \log p(y_i|y_{-i}) = \log \int p(y_i|\theta)\, p(\theta|y_{-i})\, d\theta, \]
donde \(y_{-i}\) es el conjunto de datos sin el caso \(y_i\), \(p(y_i|\theta)\) es la densidad de \(y_i\) dados los parámetros \(\theta\), y \(p(\theta|y_{-i})\) es la distribución a posteriori de los parámetros ajustada sin ese caso.
Definición 6.1 (Densidad logarítmica predictiva esperada (ELPD)) Dada una muestra de datos \((y_1, \ldots, y_n)\), la densidad logarítmica predictiva esperada de un modelo, calculada mediante LOO-CV, es
\[ \text{elpd} = \sum_{i=1}^n \log p(y_i|y_{-i}) = \sum_{i=1}^n \log \int p(y_i|\theta)\, p(\theta|y_{-i})\, d\theta. \]
Cuanto mayor es el valor de la ELPD, mejor es la capacidad predictiva del modelo, por lo que podemos comparar modelos mediante esta métrica.
loo()
Calcula la ELPD de un modelo de regresión bayesiano ajustado con stan_glm() mediante validación cruzada LOO-CV. Se encuentra en el paquete loo.
Parámetros:
x: modelo de regresión bayesiano ajustado con stan_glm().Ejemplo 6.25 Calculamos la ELPD del modelo de regresión lineal simple y del múltiple para comparar su capacidad predictiva:
library(loo)
# ELPD del modelo de regresión lineal simple
loo(modelo_peso_estatura)$estimates[1,] |> t() |> kable(digits = 1)| Estimate | SE |
|---|---|
| -810.6 | 9.8 |
# ELPD del modelo de regresión lineal múltiple
loo(modelo_peso_estatura_sexo)$estimates[1,] |> t() |> kable(digits = 1)| Estimate | SE |
|---|---|
| -781.6 | 9.7 |
La diferencia no se interpreta en términos absolutos, sino en relación con su error estándar.
La función loo_compare() del paquete loo permite comparar la ELPD de varios modelos ajustados con stan_glm().
loo_compare()
Compara la ELPD de varios modelos de regresión bayesianos a partir de los objetos calculados con loo().
Parámetros:
x: objetos loo de los modelos que se quieren comparar.Ejemplo 6.26 Comparamos la ELPD de los modelos de regresión lineal simple y múltiple:
loo1 <- loo(modelo_peso_estatura)
loo2 <- loo(modelo_peso_estatura_sexo)
loo_compare(loo1, loo2)[, c("elpd_diff", "se_diff")] |> kable(digits = 2)| elpd_diff | se_diff | |
|---|---|---|
| modelo_peso_estatura_sexo | 0.00 | 0.00 |
| modelo_peso_estatura | -28.99 | 6.37 |
La diferencia tipificada de ELPD es el cociente entre la diferencia de ELPD y su error estándar, que en este caso es de alrededor de 4,6 (28,99 entre 6,37).
Se suele utilizar la siguiente regla, propuesta por Vehtari:
Según esta regla, el modelo de regresión múltiple es sustancialmente mejor que el modelo de regresión simple.
Ejercicio 6.8 Compara la ELPD del modelo de regresión del peso sobre el sexo con la del modelo de regresión múltiple del peso sobre la estatura y el sexo. ¿Qué conclusiones se pueden extraer?
loo1 <- loo(modelo_peso_sexo)
loo2 <- loo(modelo_peso_estatura_sexo)
loo_compare(loo1, loo2)[, c("elpd_diff", "se_diff")] |> kable(digits = 2)| elpd_diff | se_diff | |
|---|---|---|
| modelo_peso_sexo | 0.00 | 0.00 |
| modelo_peso_estatura_sexo | -1.05 | 1.41 |
La diferencia tipificada de ELPD es de alrededor de 0,74 (1,05 entre 1,41), por debajo de 2. La diferencia no es sustancial: el modelo que solo incluye el sexo es ligeramente mejor que el múltiple, por lo que añadir la estatura al modelo del sexo no mejora la capacidad predictiva. Esto es coherente con la pequeña mejora que hemos visto antes al pasar de un modelo a otro, y puede deberse a que la estatura y el sexo están correlacionados, de modo que la estatura aporta poca información adicional cuando ya se conoce el sexo.
En un modelo de regresión múltiple sin interacción,
\[ Y|\beta_0,\beta_1,\beta_2,\sigma \sim N(\beta_0 + \beta_1 X_1+ \beta_2 X_2, \sigma), \]
se asume que la pendiente \(\beta_1\) es la misma para cualquier valor de \(X_2\). En el ejemplo anterior, esto quiere decir que el incremento de peso por centímetro de estatura es el mismo para hombres y mujeres. Pero esto no tiene por qué ser cierto: puede haber interacción entre las variables independientes, es decir, el efecto de una depende del valor de la otra.
Cuando no hay interacción entre \(X_1\) y \(X_2\), las rectas de regresión correspondientes a cada valor de \(X_2\) son paralelas. Si hay interacción, no lo son.
Para modelar la interacción introducimos un nuevo parámetro \(\beta_3\), coeficiente del producto de \(X_1\) y \(X_2\):
\[ Y|\beta_0,\beta_1,\beta_2,\beta_3,\sigma \sim N(\beta_0 + \beta_1 X_1+ \beta_2 X_2+\beta_3 X_1X_2, \sigma). \]
Ejemplo 6.27 Ajustamos el modelo con interacción entre la estatura y el sexo:
modelo_peso_estatura_sexo_interaccion <- stan_glm(
  peso ~ estatura * sexo,
  data = df,
  family = gaussian(),
  prior_intercept = normal(70, 10),
  prior = normal(location = c(2, -10, 0), scale = c(1, 5, 0.5)),
  prior_aux = exponential(0.5),
  chains = 4, iter = 5000 * 2, seed = 123
)
modelo_peso_estatura_sexo_interaccion |>
gather_draws(`(Intercept)`, estatura, sexoM, `estatura:sexoM`, sigma) |>
mean_qi(.width = 0.9) |>
kable(digits = 2)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | 62.66 | 29.03 | 96.70 | 0.9 | mean | qi |
| estatura | 0.11 | -0.08 | 0.30 | 0.9 | mean | qi |
| estatura:sexoM | -0.06 | -0.11 | -0.01 | 0.9 | mean | qi |
| sexoM | -9.24 | -17.38 | -1.16 | 0.9 | mean | qi |
| sigma | 11.77 | 10.84 | 12.78 | 0.9 | mean | qi |
Dibujamos las rectas de regresión a posteriori del modelo con interacción:
Ejemplo 6.28
df |>
  add_epred_draws(modelo_peso_estatura_sexo_interaccion, ndraws = 50, value = "Predicción_media") |>
  ggplot(aes(x = estatura, y = peso, color = sexo)) +
  geom_point(data = df) +
  geom_line(aes(y = Predicción_media, group = paste(sexo, .draw)), alpha = 0.2) +
  labs(x = "Estatura (cm)", y = "Peso (kg)") +
  theme_minimal()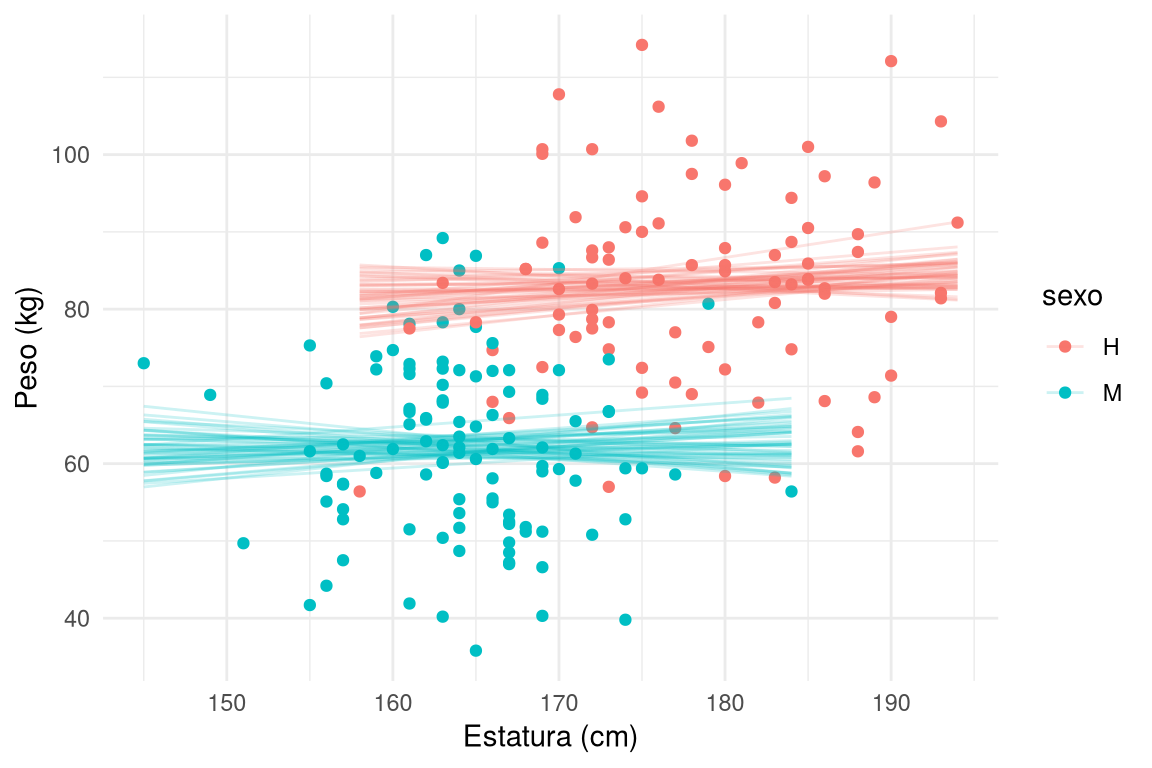
Aunque el modelo incluye la interacción, las rectas de regresión son prácticamente paralelas, lo que indica que casi no hay interacción entre la estatura y el sexo.
Ejercicio 6.9 Compara la ELPD del modelo múltiple sin interacción con la del modelo con interacción. ¿Qué conclusiones se pueden extraer?
loo1 <- loo(modelo_peso_estatura_sexo)
loo2 <- loo(modelo_peso_estatura_sexo_interaccion)
loo_compare(loo1, loo2)[, c("elpd_diff", "se_diff")] |> kable(digits = 2)| elpd_diff | se_diff | |
|---|---|---|
| modelo_peso_estatura_sexo_interaccion | 0.00 | 0.00 |
| modelo_peso_estatura_sexo | -0.41 | 0.83 |
La diferencia tipificada de ELPD es de alrededor de 0,5 (0,41 entre 0,83), por debajo de 2, así que no hay una diferencia sustancial entre los dos modelos. Por el principio de parsimonia, nos quedaríamos con el modelo sin interacción.
En todos los modelos vistos hasta ahora, la variable dependiente \(Y\) era cuantitativa continua (el peso). Sin embargo, en muchos problemas la variable dependiente es categórica y lo que queremos modelizar es la probabilidad de que ocurra un suceso.
En epidemiología, por ejemplo, es muy habitual estudiar la probabilidad de que una persona padezca una enfermedad (enfermo / sano) en función de factores de riesgo como la edad, el sexo, el índice de masa corporal o los hábitos. En estos casos, la variable dependiente es dicotómica:
\[ Y = \begin{cases} 1 & \text{si la persona padece la enfermedad,} \\ 0 & \text{si la persona no la padece.} \end{cases} \]
Un modelo de regresión lineal no es adecuado aquí, porque podría predecir valores de \(Y\) por debajo de 0 o por encima de 1, que no tienen sentido como probabilidades.
Cuando la variable dependiente es dicotómica, suponemos que sigue una distribución de Bernoulli con probabilidad de éxito \(\pi_i\), que es la probabilidad de padecer la enfermedad para el individuo \(i\):
\[ Y_i \mid \pi_i \sim \text{Bernoulli}(\pi_i). \]
Como \(\pi_i\) debe estar entre 0 y 1, no podemos modelizarla directamente como combinación lineal de las variables independientes. En su lugar, modelizamos una transformación conocida como logaritmo de las odds (log-odds o logit):
\[ \text{logit}(\pi_i) = \log\left(\frac{\pi_i}{1-\pi_i}\right) = \beta_0 + \beta_1 x_i, \]
donde el cociente \(\frac{\pi_i}{1-\pi_i}\) es la odds de padecer la enfermedad, que expresa cuántas veces es más probable padecerla que no padecerla.
Despejando \(\pi_i\) se obtiene la función logística, que da nombre al modelo. Transforma cualquier valor real del predictor lineal en una probabilidad entre 0 y 1:
\[ \pi_i = \frac{e^{\beta_0 + \beta_1 x_i}}{1 + e^{\beta_0 + \beta_1 x_i}} = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_i)}}. \]
tibble(x = seq(-10, 10, 0.1)) |>
  mutate(pi = plogis(x)) |>
  ggplot(aes(x = x, y = pi)) +
  geom_line(color = myblue, linewidth = 1.2) +
  geom_hline(yintercept = c(0, 1), linetype = "dashed", color = mygray) +
  labs(x = expression(beta[0] + beta[1] * x), y = expression(pi)) +
  theme_minimal()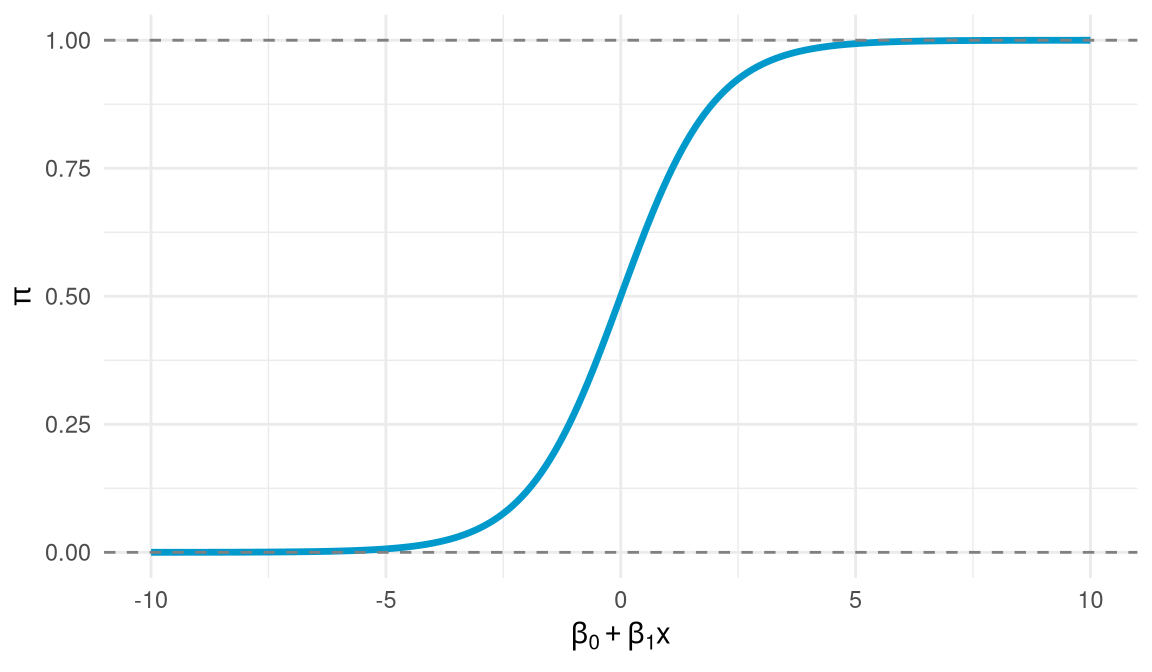
La función logística tiene forma de S, es creciente y toma siempre valores entre 0 y 1, por lo que es ideal para modelizar probabilidades.
En la regresión logística los coeficientes se interpretan en la escala de las odds:
El modelo se especifica como
\[ \begin{align*} Y_i \mid \beta_0, \beta_1 & \sim \text{Bernoulli}(\pi_i) \\ \text{logit}(\pi_i) & = \beta_0 + \beta_1 x_i \end{align*} \]
A diferencia de la regresión lineal, no hay un parámetro \(\sigma\) para la desviación típica del error, porque la variabilidad de una distribución de Bernoulli queda determinada por su probabilidad \(\pi_i\).
Como siempre, asignamos distribuciones a priori a los coeficientes y las actualizamos con los datos para obtener sus distribuciones a posteriori.
Como \(\beta_0\) y \(\beta_1\) son parámetros de localización que pueden tomar cualquier valor real (están en la escala logarítmica de las odds), una distribución a priori adecuada para ambos es la normal:
\[ \beta_0 \sim N(\theta_0, \tau_0), \qquad \beta_1 \sim N(\theta_1, \tau_1). \]
Conviene tener presente que, en la escala logit, valores aparentemente pequeños de los coeficientes pueden corresponder a cambios grandes en la probabilidad. Por ejemplo, una distribución a priori \(\beta_1 \sim N(0, 0{,}5)\) ya es bastante informativa, porque asume que la razón de odds \(e^{\beta_1}\) está, con un 95 % de probabilidad, aproximadamente entre \(e^{-1} \approx 0{,}37\) y \(e^{1} \approx 2{,}72\).
Ejemplo 6.29 Supongamos que queremos estudiar la prevalencia de diabetes tipo 2 en una población adulta en función de la edad. Disponemos de los datos de una cohorte de 250 personas en las que se ha registrado su edad y si padecen o no diabetes.
Para este ejemplo simulamos los datos a partir de un modelo conocido, lo que nos permitirá comprobar después si el modelo bayesiano recupera la prevalencia real:
set.seed(123)
n <- 250
edad <- round(runif(n, 30, 85))
imc <- round(rnorm(n, 27, 4), 1)
# Modelo real: logit(pi) = -9 + 0.07 * edad + 0.12 * imc
prob_real <- plogis(-9 + 0.07 * edad + 0.12 * imc)
diabetes <- rbinom(n, size = 1, prob = prob_real)
df <- tibble(edad = edad, imc = imc, diabetes = diabetes)
La prevalencia es la proporción de individuos de la población que padecen la enfermedad. En la muestra, la prevalencia observada es
df |> summarise(prevalencia = mean(diabetes)) |> kable(digits = 3)| prevalencia |
|---|
| 0.18 |
Representamos la presencia de diabetes frente a la edad. Como la variable dependiente solo toma los valores 0 y 1, añadimos un pequeño ruido vertical (jitter) para visualizar mejor la densidad de puntos:
ggplot(df, aes(x = edad, y = diabetes)) +
  geom_jitter(height = 0.05, alpha = 0.4, color = myblue) +
  labs(x = "Edad (años)", y = "Diabetes (0 = no, 1 = sí)") +
  theme_minimal()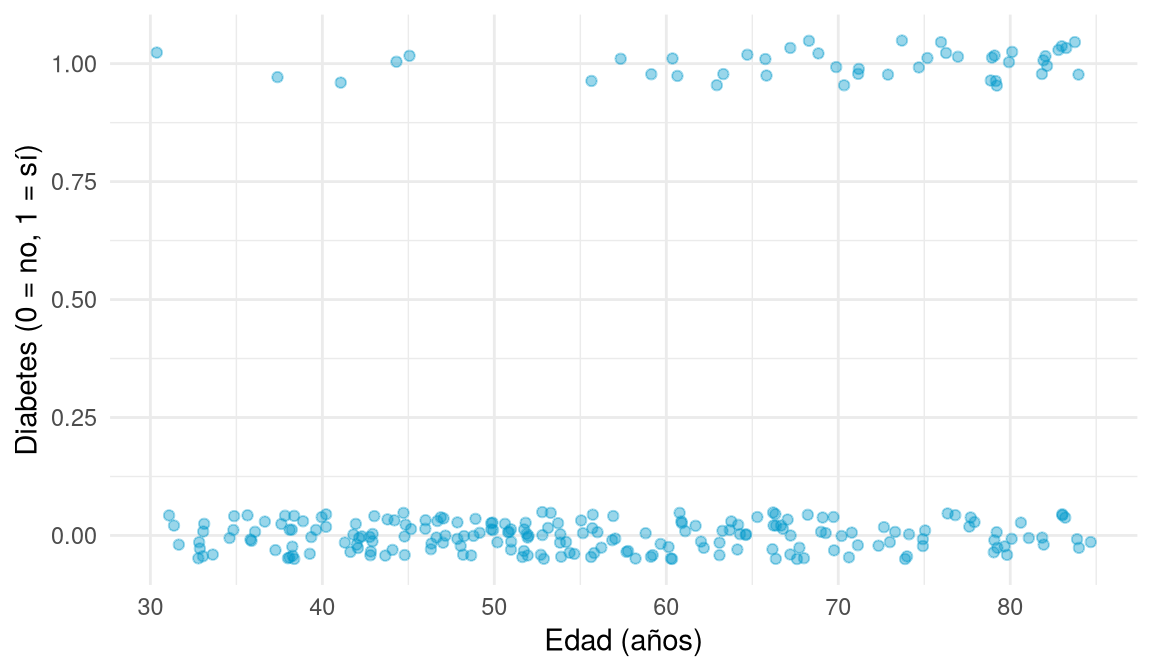
En este contexto usamos distribuciones a priori poco informativas, para que los datos tengan un peso importante en la estimación. Para \(\beta_0\) asumimos una normal de media \(-1{,}5\) y desviación típica \(1{,}5\), lo que implica que la odds de padecer diabetes es baja para una persona de edad media:
\[ \beta_0 \sim N(-1{,}5;\ 1{,}5). \]
Para \(\beta_1\) asumimos una normal de media 0 y desviación típica 0,5, lo que implica un efecto de la edad moderado y de signo desconocido:
\[ \beta_1 \sim N(0;\ 0{,}5). \]
Para ajustar un modelo de regresión logística bayesiano usamos de nuevo stan_glm(), indicando la familia binomial(), que utiliza por defecto la función de enlace logit.
Como con la regresión lineal, conviene comprobar que las distribuciones a priori son razonables antes de ajustar el modelo. Para ello ajustamos el modelo con prior_PD = TRUE, que simula los parámetros a partir de sus distribuciones a priori sin usar los datos.
Ejemplo 6.30 Obtenemos las distribuciones a priori del modelo de regresión logística de la probabilidad de diabetes sobre la edad:
library(rstanarm)
set.seed(123)
modelo_diabetes_prior <- stan_glm(
  diabetes ~ edad, data = df, family = binomial(),
  prior_intercept = normal(-1.5, 1.5),
  prior = normal(0, 0.5),
  chains = 4, iter = 5000 * 2, seed = 123,
  prior_PD = TRUE
)
Dibujamos algunas de las curvas logísticas generadas a partir de las distribuciones a priori para comprobar que cubren un rango razonable de posibilidades:
tibble(edad = seq(30, 85, length.out = 50)) |>
  add_epred_draws(modelo_diabetes_prior, ndraws = 100, value = "prob") |>
  ggplot(aes(x = edad, y = prob, group = .draw)) +
  geom_line(color = myred, alpha = 0.2) +
  labs(x = "Edad (años)", y = "Probabilidad de diabetes") +
  theme_minimal()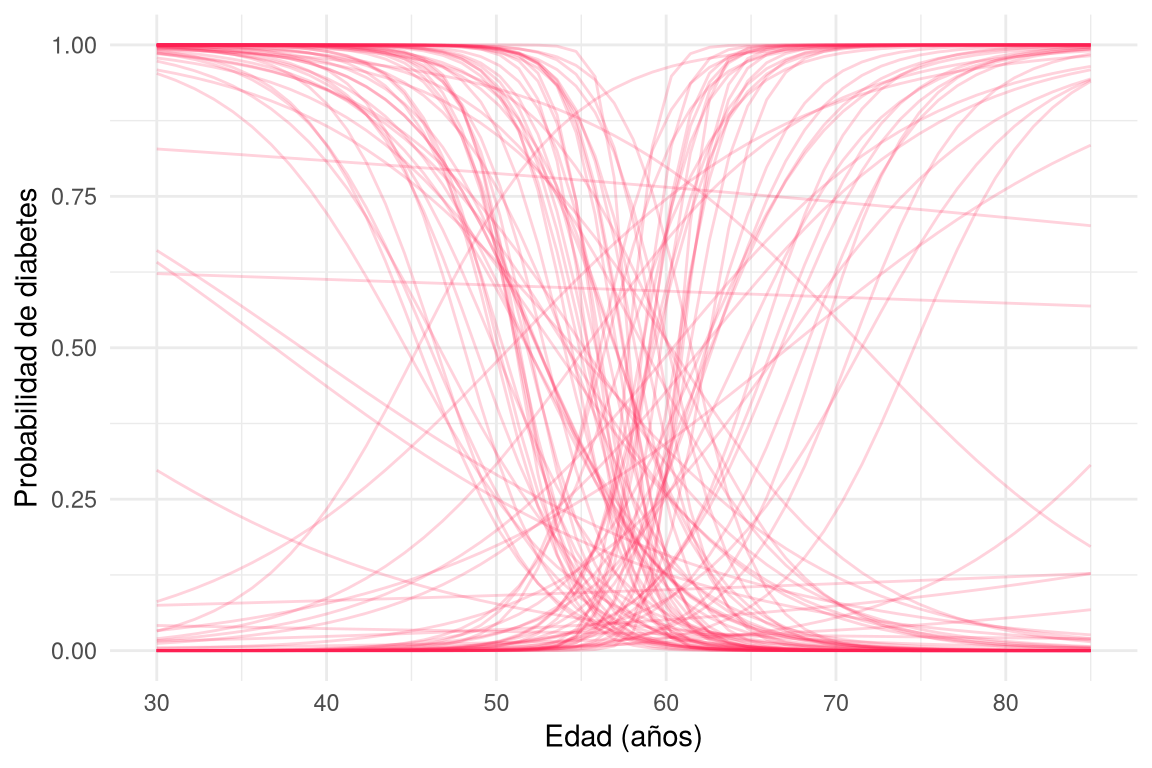
Las curvas a priori contemplan tanto relaciones crecientes como decrecientes con la edad y cubren todo el rango de probabilidades, lo que indica que las distribuciones a priori son poco informativas y razonables.
Una vez validadas las distribuciones a priori, ajustamos el modelo a los datos actualizando el modelo anterior con prior_PD = FALSE:
Ejemplo 6.31
modelo_diabetes <- update(modelo_diabetes_prior, prior_PD = FALSE)Comprobamos la convergencia de las cadenas de Markov:
library(bayesplot)
mcmc_trace(modelo_diabetes, size = 0.2)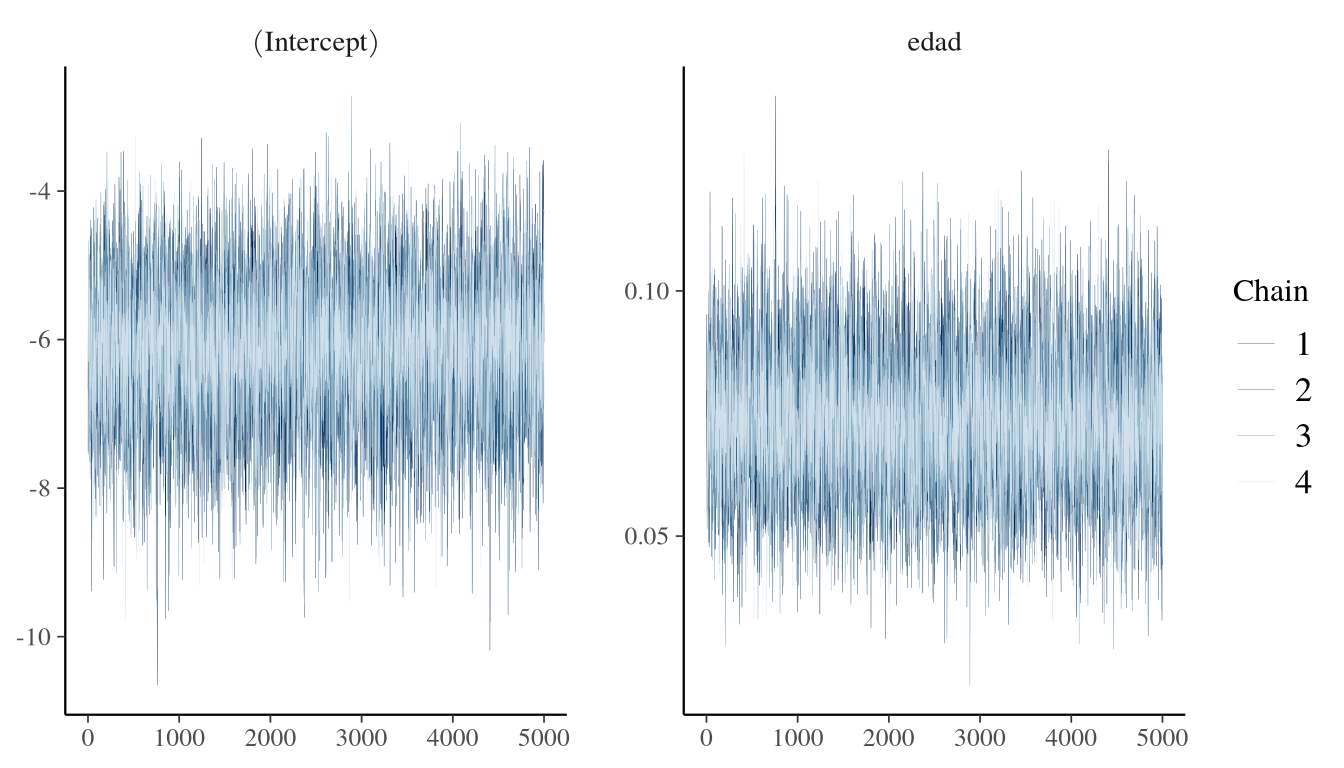
mcmc_dens_overlay(modelo_diabetes)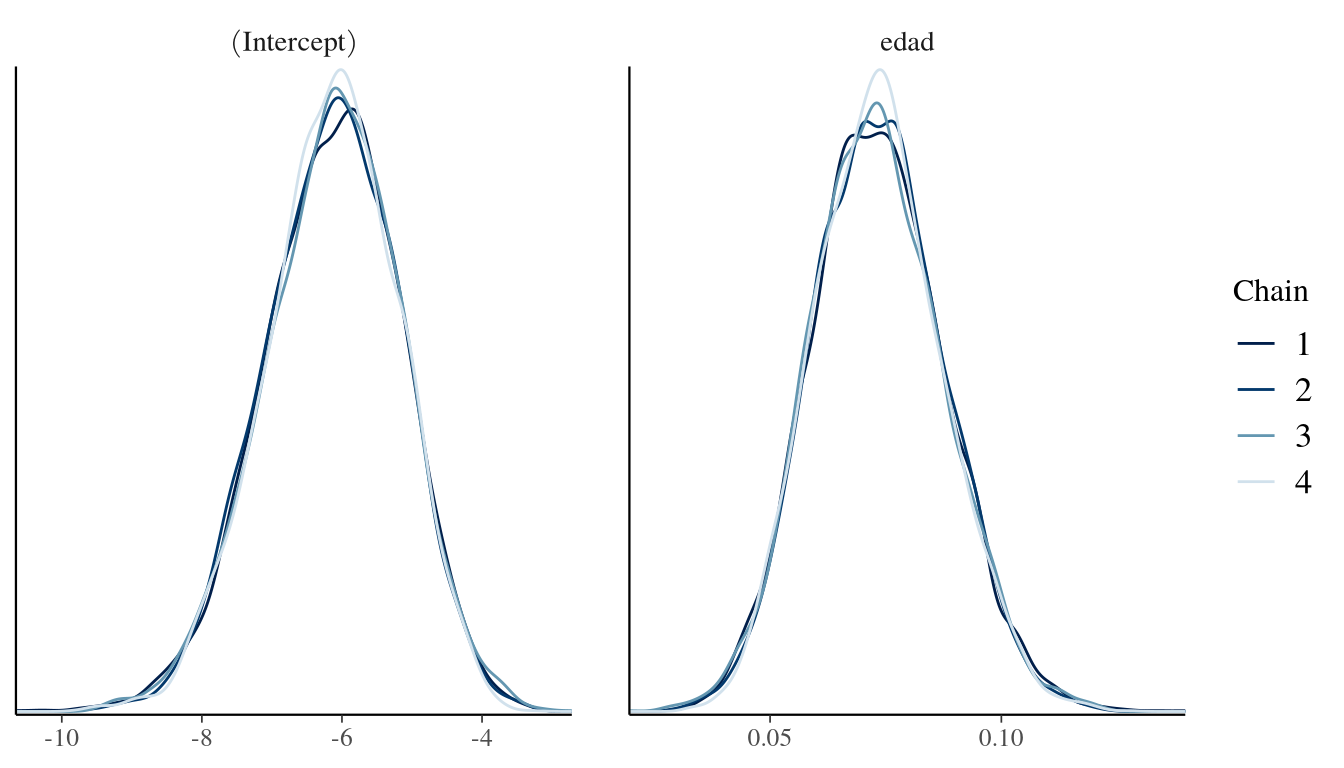
neff_ratio(modelo_diabetes) |> t() |> kable(digits = 3)| (Intercept) | edad |
|---|---|
| 0.403 | 0.427 |
rhat(modelo_diabetes) |> t() |> kable(digits = 3)| (Intercept) | edad |
|---|---|
| 1 | 1 |
Las cadenas son estables y convergentes: el número efectivo de simulaciones es razonable para ambos parámetros y el valor de \(\hat{R}\) es prácticamente 1.
Ejemplo 6.32 Obtenemos la media y los intervalos de credibilidad del 90 % de los parámetros:
modelo_diabetes |>
  gather_draws(`(Intercept)`, edad) |>
  mean_qi(.width = 0.9) |>
kable(digits = 3)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | -6.137 | -7.768 | -4.627 | 0.9 | mean | qi |
| edad | 0.073 | 0.051 | 0.097 | 0.9 | mean | qi |
El coeficiente de la edad es positivo, lo que indica que, a mayor edad, mayor probabilidad de diabetes.
Para interpretar el coeficiente de la edad en términos más intuitivos, calculamos la razón de odds \(e^{\beta_1}\):
modelo_diabetes |>
  gather_draws(edad) |>
  mutate(odds_ratio = exp(.value)) |>
  mean_qi(odds_ratio, .width = 0.9) |>
kable(digits = 3)| .variable | odds_ratio | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| edad | 1.076 | 1.052 | 1.102 | 0.9 | mean | qi |
Es decir, por cada año más de edad, la odds de padecer diabetes se multiplica por aproximadamente 1,07 (un incremento del 7 % en la odds por año), y con una probabilidad del 90 % el factor está entre 1,05 y 1,1.
Cada muestra de la distribución a posteriori de los parámetros define una curva logística distinta. Podemos dibujar algunas de ellas sobre los datos para visualizar el ajuste y la incertidumbre:
tibble(edad = seq(30, 85, length.out = 100)) |>
  add_epred_draws(modelo_diabetes, ndraws = 50, value = "prob") |>
  ggplot(aes(x = edad, y = prob)) +
  geom_line(aes(group = .draw), color = myred, alpha = 0.2) +
  geom_jitter(data = df, aes(y = diabetes), height = 0.03,
              alpha = 0.3, color = myblue) +
  labs(x = "Edad (años)", y = "Probabilidad de diabetes") +
  theme_minimal()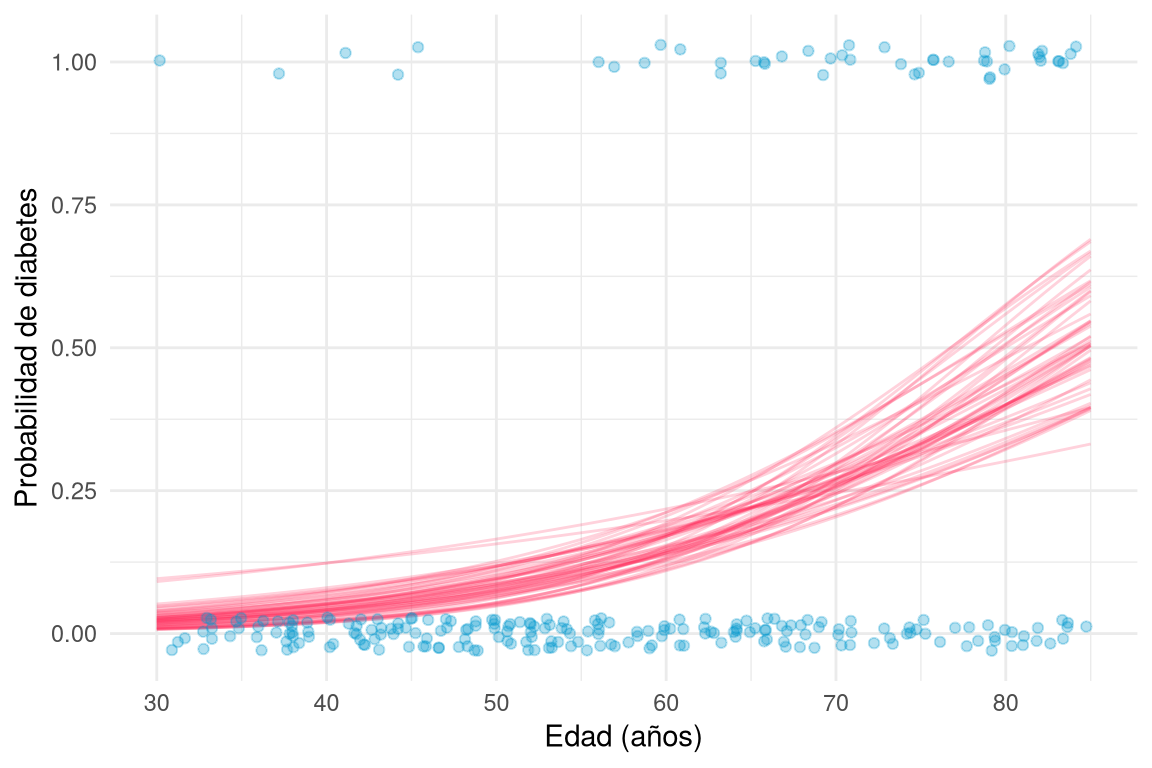
Se observa cómo la probabilidad de padecer diabetes aumenta con la edad, siguiendo una curva en forma de S.
En estadística bayesiana, la estimación de un parámetro es su propia distribución a posteriori, que describimos habitualmente con su media o mediana y su intervalo de credibilidad.
Ejemplo 6.33 Para estimar la prevalencia de la diabetes calculamos, para cada muestra de la distribución a posteriori, la probabilidad media de diabetes en toda la muestra:
df |>
  add_epred_draws(modelo_diabetes, value = "prob") |>
  group_by(.draw) |>
  summarise(prevalencia = mean(prob)) |>
  mean_qi(prevalencia, .width = 0.9) |>
kable(digits = 3)| prevalencia | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 0.181 | 0.145 | 0.218 | 0.9 | mean | qi |
La prevalencia estimada de diabetes en la población es de alrededor del 18 %, con un intervalo de credibilidad del 90 % que va del 15 % al 22 %.
Para predecir la probabilidad de padecer la enfermedad de nuevos individuos usamos epred_draws(), que genera la distribución a posteriori de la probabilidad \(\pi\) para cada nuevo caso.
Ejemplo 6.34 Calculamos la probabilidad de padecer diabetes para personas de 40, 60 y 80 años:
nuevos <- tibble(edad = c(40, 60, 80))
epred_draws(modelo_diabetes, newdata = nuevos, value = "prob") |>
  mean_qi(.width = 0.9) |>
kable(digits = 3)| edad | .row | prob | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|---|
| 40 | 1 | 0.042 | 0.019 | 0.073 | 0.9 | mean | qi |
| 60 | 2 | 0.152 | 0.111 | 0.196 | 0.9 | mean | qi |
| 80 | 3 | 0.435 | 0.334 | 0.539 | 0.9 | mean | qi |
Para una persona de 40 años, la probabilidad de padecer diabetes es baja, mientras que para una de 80 años es considerablemente mayor.
Representamos gráficamente estas distribuciones a posteriori de la probabilidad:
epred_draws(modelo_diabetes, newdata = nuevos, value = "prob") |>
  mutate(edad = factor(edad)) |>
  ggplot(aes(x = prob, y = edad, fill = edad)) +
  stat_halfeye(.width = 0.9, alpha = 0.6) +
  labs(x = "Probabilidad de diabetes", y = "Edad (años)") +
  theme_minimal() +
  theme(legend.position = "none")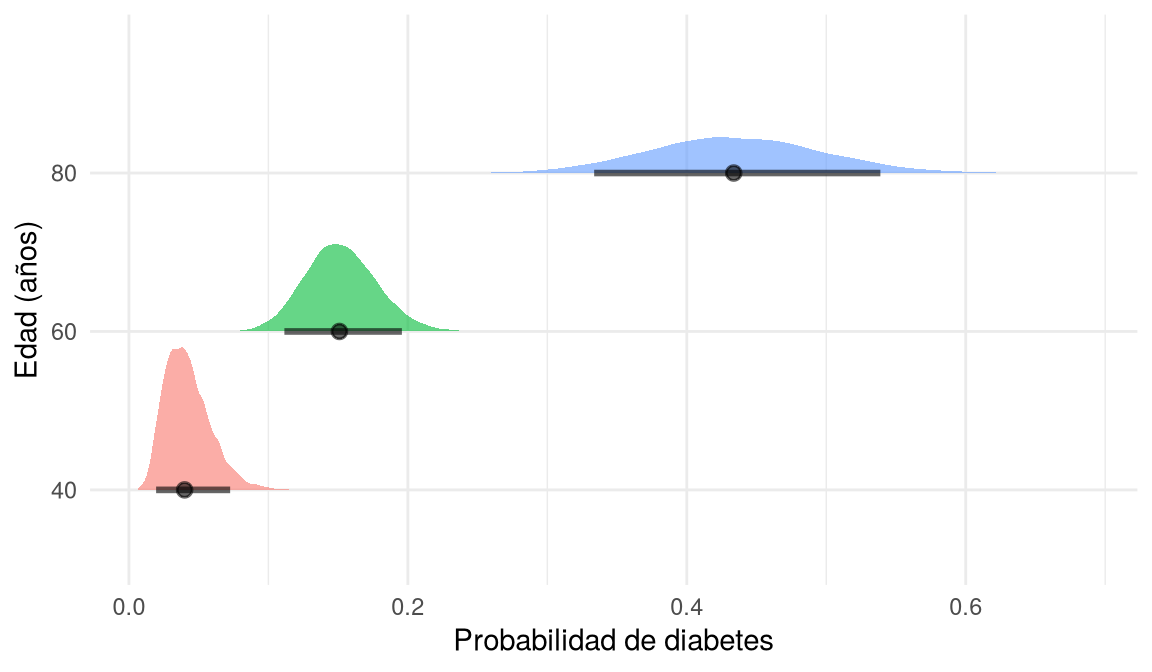
Además de predecir la probabilidad de padecer la enfermedad, a menudo queremos clasificar a cada individuo como enfermo o sano. Para ello fijamos un umbral de clasificación (cutoff): si la probabilidad estimada supera el umbral, clasificamos al individuo como enfermo.
El umbral más habitual es 0,5, pero puede ajustarse según el coste relativo de los errores. En cribados de enfermedades graves se suele bajar el umbral para no dejar pasar a posibles enfermos, es decir, para aumentar la sensibilidad.
Para obtener las clases predichas usamos predicted_draws(), que simula valores 0/1 de la distribución de Bernoulli para cada caso. La proporción de unos es una estimación de la probabilidad:
Ejemplo 6.35 Clasificamos a las personas de 40, 60 y 80 años con un umbral de 0,4:
predicted_draws(modelo_diabetes, newdata = nuevos, value = "clase") |>
  group_by(edad) |>
  summarise(prob_diabetes = mean(clase)) |>
  mutate(clasificacion = if_else(prob_diabetes > 0.4, "Enfermo", "Sano")) |>
kable(digits = 3)| edad | prob_diabetes | clasificacion |
|---|---|---|
| 40 | 0.039 | Sano |
| 60 | 0.152 | Sano |
| 80 | 0.438 | Enfermo |
Con el umbral de 0,4, solo las personas de 80 años serían clasificadas como enfermas.
Para evaluar la capacidad de clasificación del modelo comparamos las clases predichas con las observadas, y construimos una matriz de confusión que clasifica cada caso como:
A partir de la matriz de confusión se calculan:
Para calcular la matriz de confusión y las métricas de clasificación de un modelo de regresión logística bayesiano podemos usar la función classification_summary() del paquete bayesrules.
classification_summary()
Devuelve la matriz de confusión y las métricas de sensibilidad, especificidad y exactitud de un modelo de clasificación bayesiano.
Parámetros:
model: modelo ajustado con stan_glm().data: conjunto de datos con la variable dependiente y las variables independientes.cutoff: umbral de clasificación. Por defecto 0,5.Ejemplo 6.36 Calculamos la matriz de confusión y las métricas de clasificación del modelo de diabetes sobre la edad, con un umbral de 0,4:
library(bayesrules)
set.seed(123)
clasificacion <- classification_summary(model = modelo_diabetes, data = df, cutoff = 0.4)
clasificacion$confusion_matrix |> kable()| y | 0 | 1 |
|---|---|---|
| 0 | 185 | 20 |
| 1 | 29 | 16 |
clasificacion$accuracy_rates |> kable(digits = 3)| sensitivity | 0.356 |
| specificity | 0.902 |
| overall_accuracy | 0.804 |
La exactitud global es de 0,80, pero la sensibilidad es baja (0,36): con el umbral de 0,4, el modelo clasifica bien a los sanos (especificidad de 0,90), pero deja sin detectar a muchos enfermos. Esto es habitual cuando la enfermedad es poco prevalente.
Cuando interesa detectar el mayor número posible de enfermos, por ejemplo en un cribado, podemos bajar el umbral para aumentar la sensibilidad a costa de reducir la especificidad.
Ejemplo 6.37 Repetimos la evaluación con un umbral de 0,2:
set.seed(123)
classification_summary(model = modelo_diabetes, data = df, cutoff = 0.2)$accuracy_rates |>
kable(digits = 3)| sensitivity | 0.733 |
| specificity | 0.712 |
| overall_accuracy | 0.716 |
Al bajar el umbral aumenta la sensibilidad (detectamos más enfermos) y disminuye la especificidad (clasificamos como enfermos a más sanos). La elección del umbral depende del coste relativo de los falsos positivos y de los falsos negativos.
Al igual que en la regresión lineal, las métricas calculadas sobre el propio conjunto de datos tienden a ser optimistas por el sobreajuste. Para obtener una estimación más realista usamos la validación cruzada con la función classification_summary_cv() del paquete bayesrules.
classification_summary_cv()
Devuelve las métricas de clasificación de un modelo bayesiano mediante validación cruzada.
Parámetros:
model: modelo ajustado con stan_glm().data: conjunto de datos.k: número de pliegues.cutoff: umbral de clasificación. Por defecto 0,5.Ejemplo 6.38 Evaluamos el modelo mediante validación cruzada con 10 pliegues:
set.seed(123)
cv_diabetes <- classification_summary_cv(model = modelo_diabetes, data = df, k = 10, cutoff = 0.4)
cv_diabetes$cv |> kable(digits = 3)| sensitivity | specificity | overall_accuracy |
|---|---|---|
| 0.196 | 0.908 | 0.792 |
Las métricas obtenidas por validación cruzada son algo peores que las obtenidas sobre el conjunto de entrenamiento, lo que da una idea más realista de la capacidad predictiva del modelo con datos nuevos.
Al igual que en la regresión lineal, podemos incluir varias variables independientes en el modelo logístico para mejorar la predicción de la probabilidad de la enfermedad:
\[ \text{logit}(\pi_i) = \beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i} + \cdots + \beta_p x_{pi}. \]
Cada coeficiente \(\beta_j\) es el cambio en el logaritmo de la odds por cada unidad que aumenta \(X_j\), manteniendo constantes las demás variables. Su exponencial \(e^{\beta_j}\) es la razón de odds ajustada por el resto de factores de riesgo.
Ejercicio 6.10 Ajusta un modelo de regresión logística múltiple para predecir la probabilidad de diabetes en función de la edad y del índice de masa corporal (IMC), usando los datos simulados anteriormente. Compara su capacidad predictiva con la del modelo que solo incluye la edad mediante la ELPD.
Ajustamos el modelo añadiendo el IMC como variable independiente:
set.seed(123)
modelo_diabetes_imc <- stan_glm(
  diabetes ~ edad + imc, data = df, family = binomial(),
  prior_intercept = normal(-1.5, 1.5),
  prior = normal(0, 0.5),
  chains = 4, iter = 5000 * 2, seed = 123
)
modelo_diabetes_imc |>
gather_draws(`(Intercept)`, edad, imc) |>
mean_qi(.width = 0.9) |>
kable(digits = 3)| .variable | .value | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|---|
| (Intercept) | -9.378 | -12.303 | -6.619 | 0.9 | mean | qi |
| edad | 0.075 | 0.052 | 0.099 | 0.9 | mean | qi |
| imc | 0.114 | 0.038 | 0.191 | 0.9 | mean | qi |
Tanto la edad como el IMC tienen coeficientes positivos, lo que indica que ambos son factores de riesgo para la diabetes.
Comparamos los dos modelos con la ELPD mediante validación cruzada LOO-CV:
loo_edad <- loo(modelo_diabetes)
loo_edad_imc <- loo(modelo_diabetes_imc)
loo_compare(loo_edad, loo_edad_imc)[, c("elpd_diff", "se_diff")] |> kable(digits = 2)| elpd_diff | se_diff | |
|---|---|---|
| modelo_diabetes_imc | 0.00 | 0.00 |
| modelo_diabetes | -1.92 | 2.66 |