modelo <- "
data
{
  int<lower=0> n; // tamaño de la muestra
  int<lower=0> k; // número de éxitos
}
parameters
{
  real<lower=0, upper=1> p; // prevalencia de la hipertensión
}
model
{
  p ~ beta(4, 6); // prior
  k ~ binomial(n, p); // verosimilitud
}
"
tension_post <- stan(model_code = modelo, data = list(n = 200, k = 70),
chains = 4, iter = 5000*2, seed = 123)5 Inferencia bayesiana
La inferencia estadística consiste en extraer conclusiones sobre una población a partir de una muestra. En este capítulo se compara la estimación y el contraste de hipótesis frecuentistas con sus equivalentes bayesianos, y se termina con la predicción de nuevas observaciones. En el enfoque bayesiano, el resultado de la inferencia es siempre una distribución de probabilidad sobre los parámetros o sobre las predicciones.
5.1 Estimación de parámetros
5.1.1 Estimación frecuentista
En estadística frecuentista, la estimación de un parámetro desconocido es un valor que se obtiene a partir de la muestra observada y que se utiliza como aproximación del valor real del parámetro. La función que se aplica a la muestra para obtener la estimación se llama estimador.
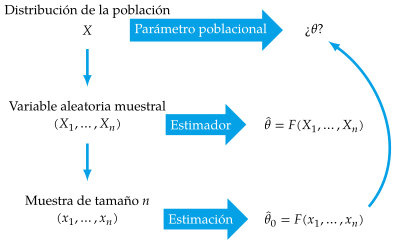
La estimación de un parámetro puede ser puntual (un único valor) o por intervalos (intervalos de confianza).
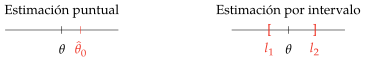
Definición 5.1 (Intervalo de confianza) Dados dos estimadores \(li(X)\) y \(ls(X)\), se dice que el intervalo \([li(X), ls(X)]\) es un intervalo de confianza para el parámetro \(\theta\) con nivel de confianza \(1-\alpha\) si
\[ P(li(X) \leq \theta \leq ls(X)) = 1-\alpha. \]
Obsérvese que aquí no hay una distribución de probabilidad que refleje la incertidumbre sobre el parámetro \(\theta\), sino sobre los límites del intervalo, que son aleatorios porque dependen de la muestra.
5.1.2 Interpretación de un intervalo de confianza
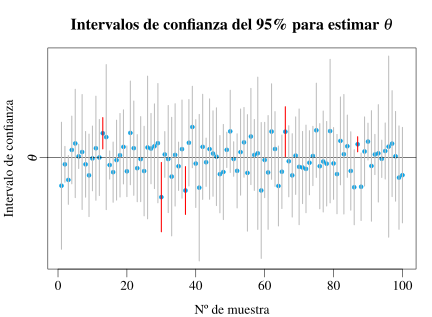
Si repitiéramos el experimento infinitas veces y construyéramos un intervalo a partir de cada muestra, el 95 % de esos intervalos contendría el verdadero valor de \(\theta\).
Advertencia
Esta interpretación es contrafactual, es decir, se refiere a experimentos que no se han realizado, y es fácil de malinterpretar. Lo que no podemos afirmar es que el intervalo obtenido contenga el parámetro con probabilidad 0,95.
5.1.3 Estimación bayesiana
En estadística bayesiana, la estimación de un parámetro desconocido es la propia distribución a posteriori del parámetro, que refleja la incertidumbre sobre su valor después de haber observado los datos. Esta distribución se describe habitualmente con distintas medidas:
- Medidas de tendencia central: media, mediana o moda.
- Medidas de posición: cuantiles.
- Medidas de dispersión: varianza, desviación típica o intervalo de credibilidad.
5.1.4 Intervalo de credibilidad
Definición 5.2 (Intervalo de credibilidad) Dada una distribución a posteriori de un parámetro \(\theta|x\), un intervalo de credibilidad con nivel \(1-\alpha\) es un intervalo \([li, ls]\) tal que
\[ P(\theta \in [li, ls]|x) = 1-\alpha. \]
La interpretación de un intervalo de credibilidad es mucho más natural: dado un intervalo de credibilidad \([li, ls]\) del 95 %, la probabilidad de que el parámetro \(\theta\) esté dentro de ese intervalo es del 95 %.
Habitualmente, para construir un intervalo de credibilidad de nivel \(1-\alpha\) se toman los percentiles \(\alpha/2\) y \(1-\alpha/2\) de la distribución a posteriori.
Ejemplo 5.1 Para estimar la prevalencia de la hipertensión en mayores de 18 años usamos un modelo beta-binomial con prior \(\mbox{Beta}(4, 6)\). Si tomamos una muestra de 200 personas y encontramos 70 con hipertensión, la distribución a posteriori de la prevalencia es \(\mbox{Beta}(4+70, 6+200-70) = \mbox{Beta}(74, 136)\).
Podemos obtener esta distribución a posteriori mediante simulación con Stan:
summary(tension_post, pars = "p", probs = c(0.05, 0.95))$summary |>
kable(digits = 3)| mean | se_mean | sd | 5% | 95% | n_eff | Rhat | |
|---|---|---|---|---|---|---|---|
| p | 0.352 | 0 | 0.033 | 0.298 | 0.408 | 7634.017 | 1 |
Podemos obtener también el intervalo de credibilidad con las funciones spread_draws y mean_qi del paquete tidybayes.
Nota
spread_draws()
Extrae las muestras de la distribución a posteriori obtenidas con MCMC y las organiza en un formato tidy para su análisis posterior.
Parámetros:
post: objeto que contiene las muestras de la distribución a posteriori obtenidas con MCMC.p: nombre del parámetro del que queremos extraer las muestras.
Nota
mean_qi()
Calcula la media y el intervalo de credibilidad de una distribución a posteriori a partir de las muestras obtenidas con MCMC.
Parámetros:
.data: data frame con las muestras de la distribución a posteriori..width: nivel de credibilidad.
tension_post |>
  spread_draws(p) |>
  mean_qi(p, .width = 0.9) |>
kable(digits = 3)| p | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 0.352 | 0.298 | 0.408 | 0.9 | mean | qi |
5.1.4.1 Dibujo de los intervalos de credibilidad
Podemos usar la función mcmc_intervals del paquete bayesplot para dibujar los intervalos de credibilidad de la distribución a posteriori.
Nota
mcmc_intervals()
Dibuja intervalos de credibilidad para los parámetros de una distribución a posteriori a partir de las muestras obtenidas por simulación de Monte Carlo.
Parámetros:
post: objeto que contiene las muestras de la distribución a posteriori.pars: vector de caracteres con los nombres de los parámetros que se quieren dibujar.prob: nivel de credibilidad del intervalo interior.prob_outer: nivel de credibilidad del intervalo exterior (opcional).point_est: método para calcular el punto de estimación central (media, mediana o moda).
Ejemplo 5.2 Dibujamos los intervalos de credibilidad calculados en el ejemplo anterior para la prevalencia de la hipertensión.
mcmc_intervals(tension_post, pars = "p",
  prob = 0.5, prob_outer = 0.9,
  point_est = "mean") +
  labs(x = "Prevalencia de la hipertensión (p)") +
  theme_gray()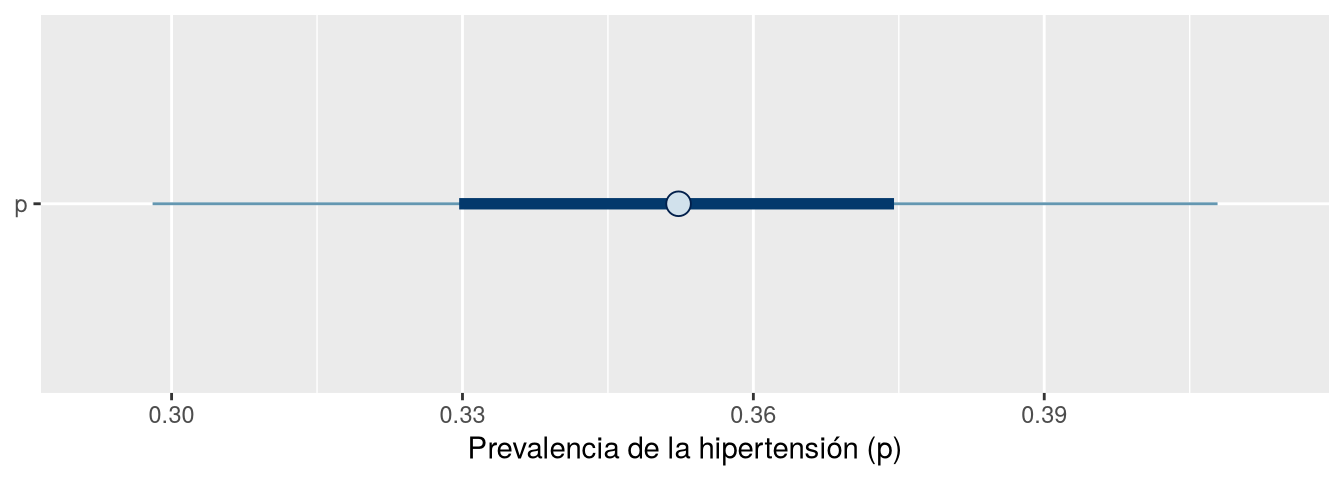
Ejercicio 5.1 Los datos históricos del sistema de vigilancia epidemiológica sugieren que la incidencia de la tuberculosis en una población está entre 8 y 15 casos por cada 100.000 habitantes y año. Si en el último año se han registrado 48 nuevos casos en una población de 300.000 habitantes, ¿cuál es el intervalo de credibilidad del 95 % para la incidencia de la tuberculosis en esa población?
Solución
Calibrando una distribución gamma para que su rango 95 % sea aproximadamente \([8, 15]\), obtenemos una distribución a priori \(\mbox{Gamma}(27{,}5;\ 2{,}5)\), cuyos percentiles 2,5 % y 97,5 % son 7,3 y 15,5.
Sea \(\lambda\) la incidencia por cada 100.000 habitantes y año, y sea \(Y\) el número de casos observados en 3 unidades de exposición (300.000 habitantes), de modo que \(Y|\lambda \sim \mbox{Poisson}(3\lambda)\). Con \(Y=48\), la distribución a posteriori es
\[ \lambda|Y=48 \sim \mbox{Gamma}(27{,}5+48,\ 2{,}5+3) = \mbox{Gamma}(75{,}5;\ 5{,}5). \]
modelo <- "
data {
  int<lower=0> y; // número de casos de tuberculosis
  real<lower=0> t; // exposición: población en unidades de 100000 habitantes-año
}
parameters {
  real<lower=0> lambda; // incidencia por 100000 habitantes-año
}
model {
  y ~ poisson(lambda * t); // función de verosimilitud
  lambda ~ gamma(27.5, 2.5); // distribución a priori
}
"
tuberculosis_post <- stan(model_code = modelo,
    data = list(y = 48, t = 3),
    chains = 4, iter = 5000*2, seed = 123)
Solución (continuación)
tuberculosis_post |>
  spread_draws(lambda) |>
  mean_qi(lambda, .width = 0.95) |>
kable(digits = 2)| lambda | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 13.75 | 10.83 | 17.02 | 0.95 | mean | qi |
mcmc_intervals(tuberculosis_post, pars = "lambda",
  prob = 0.5, prob_outer = 0.95,
  point_est = "mean") +
  labs(x = "Incidencia de tuberculosis (casos por 100.000 habitantes-año)") +
  theme_gray()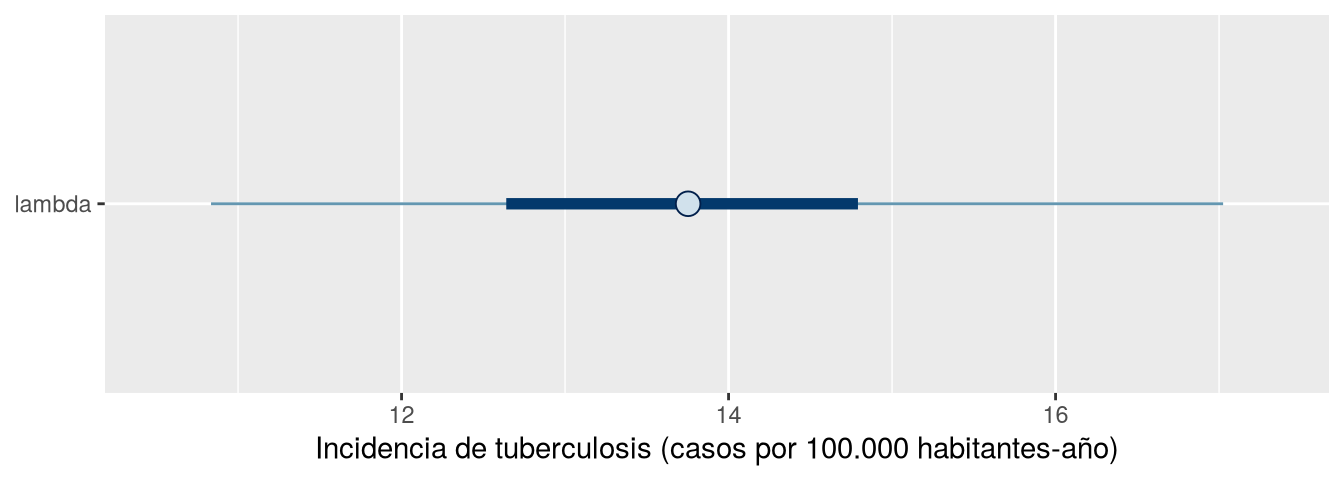
5.2 Contrastes de hipótesis
5.2.1 Hipótesis estadística
Definición 5.3 (Hipótesis estadística) Una hipótesis estadística es cualquier afirmación o conjetura que determina, total o parcialmente, la distribución de una o varias variables de la población.
Cuando las hipótesis se formulan sobre los parámetros que describen una distribución, se dice que son hipótesis paramétricas.
Ejemplo 5.3 Para valorar la gravedad de una epidemia de gripe podríamos estar interesados en contrastar si la incidencia por cada 100.000 personas-día es mayor que 20.
5.2.2 Contrastes de hipótesis paramétricos en estadística frecuentista
En estadística frecuentista, un contraste de hipótesis se realiza eligiendo entre dos hipótesis antagónicas:
- \(H_0\): hipótesis nula.
- \(H_1\): hipótesis alternativa.
La hipótesis nula asigna al parámetro un valor concreto, mientras que la alternativa suele ser una hipótesis abierta que, aunque opuesta a la nula, no fija el valor del parámetro. Esto da lugar a tres tipos de contrastes:
| Bilateral | Unilateral menor | Unilateral mayor |
|---|---|---|
| \(H_0\): \(\theta = \theta_0\) | \(H_0\): \(\theta = \theta_0\) | \(H_0\): \(\theta = \theta_0\) |
| \(H_1\): \(\theta \neq \theta_0\) | \(H_1\): \(\theta < \theta_0\) | \(H_1\): \(\theta > \theta_0\) |
5.2.3 Errores en la toma de decisiones
En un contraste de hipótesis frecuentista se pueden cometer dos tipos de errores:
- Error de tipo I: rechazar la hipótesis nula siendo esta verdadera.
- Error de tipo II: aceptar la hipótesis nula siendo esta falsa.
| Decisión | \(H_0\) cierta | \(H_1\) cierta |
|---|---|---|
| Aceptar \(H_0\) | Decisión correcta | Error de tipo II |
| Rechazar \(H_0\) | Error de tipo I | Decisión correcta |
La probabilidad de cometer un error de tipo I es \(\alpha\), el nivel de significación del contraste, que fijamos de antemano. La probabilidad de cometer un error de tipo II es \(\beta\).
5.2.4 Aceptación o rechazo de la hipótesis nula
La decisión sobre la hipótesis nula se basa en el cálculo de un estadístico de prueba a partir de la muestra observada y su comparación con una distribución de referencia bajo la hipótesis nula.
El p-valor es la probabilidad de obtener un valor del estadístico de prueba tan extremo como o más extremo que el observado, suponiendo que la hipótesis nula es cierta. Habitualmente, la regla de decisión es
| p-valor | Decisión |
|---|---|
| \(p \leq \alpha\) | Rechazar \(H_0\) |
| \(p > \alpha\) | No rechazar \(H_0\) |
Habitualmente se toma \(\alpha = 0{,}05\). Así, la metodología favorece \(H_0\), que es la hipótesis conservadora, y solo se rechaza si la evidencia en su contra es suficientemente fuerte.
5.2.5 Interpretación de la decisión
Cuando el p-valor es menor que \(\alpha\), se rechaza la hipótesis nula y se concluye que hay suficiente evidencia para apoyar la hipótesis alternativa.
Un p-valor menor que \(\alpha\) no significa que la hipótesis alternativa sea cierta, sino que los datos observados son poco compatibles con la hipótesis nula: si la hipótesis nula fuera cierta y repitiéramos el experimento muchas veces, obtendríamos un resultado tan extremo como el observado en menos de un \(\alpha\) % de las ocasiones. Como ocurre con los intervalos de confianza, esta interpretación es contrafactual y genera muchos errores.
5.2.6 Hipótesis bayesianas
En estadística bayesiana, las hipótesis se pueden formular de manera más flexible, porque no es necesario que la hipótesis nula asigne un valor concreto al parámetro. Normalmente, la hipótesis nula plantea un intervalo de valores para el parámetro y la alternativa contempla el resto:
- Contraste bilateral: \(H_0: \theta \in [\theta_1, \theta_2]\) frente a \(H_1: \theta \notin [\theta_1, \theta_2]\).
- Contraste unilateral mayor: \(H_0: \theta \leq \theta_0\) frente a \(H_1: \theta > \theta_0\).
- Contraste unilateral menor: \(H_0: \theta \geq \theta_0\) frente a \(H_1: \theta < \theta_0\).
5.2.7 Contrastes de hipótesis bayesianos
En estadística bayesiana, un contraste de hipótesis se realiza de forma natural calculando la probabilidad a posteriori de las hipótesis que se quieren contrastar:
\[ P(\theta_1\leq \theta \leq \theta_2 \mid x) = \sum_{\theta \in [\theta_1, \theta_2]} f(\theta|x) \]
para parámetros discretos, o
\[ P(\theta_1\leq \theta \leq \theta_2 \mid x) = \int_{\theta_1}^{\theta_2} f(\theta|x) \, d\theta \]
para parámetros continuos. Casi siempre no calcularemos esta integral, sino que la aproximaremos con las muestras de la distribución a posteriori obtenidas por simulación.
Esta metodología no da ventaja a ninguna de las hipótesis: cada una recibe la probabilidad que le corresponde según la distribución a posteriori.
Ejemplo 5.4 En el ejemplo de la prevalencia de la hipertensión podríamos estar interesados en contrastar si la prevalencia es mayor que el 30 %. Para ello hay que calcular
\[ P(p > 0{,}3 \mid x) = \int_{0{,}3}^{1} f(p|x) \, dp, \]
que puede aproximarse con las muestras de Stan:
tension_post |>
  spread_draws(p) |>
  summarise(prob = mean(p > 0.3)) |>
kable(digits = 3)| prob |
|---|
| 0.943 |
Con la distribución \(\mbox{Beta}(74, 136)\) la probabilidad es, aproximadamente, 0,94: los datos son muy favorables a que la prevalencia supere el 30 %.
Ejercicio 5.2 En el ejemplo de la incidencia de la tuberculosis, contrasta si la incidencia es mayor que 15 casos por cada 100.000 habitantes y año.
¿Cómo plantearías el contraste para ver si la incidencia es 18?
Solución
Planteamos el contraste como \(H_0: \lambda \leq 15\) frente a \(H_1: \lambda > 15\). Calculamos la probabilidad a posteriori de la hipótesis alternativa:
tuberculosis_post |>
  spread_draws(lambda) |>
  summarise(prob = mean(lambda > 15)) |>
kable(digits = 3)| prob |
|---|
| 0.213 |
Esta probabilidad es de aproximadamente 0,21. Como \(H_0\) tiene una probabilidad a posteriori de unos 0,79, los datos son más compatibles con \(H_0\). Sin embargo, una probabilidad de 0,21 para \(H_1\) no es despreciable, así que la conclusión debe presentarse con cautela y no como una certeza.
Para contrastar si la incidencia es 18 podemos mirar si ese valor está dentro del intervalo de credibilidad:
tuberculosis_post |>
  spread_draws(lambda) |>
  mean_qi(lambda, .width = 0.99) |>
kable(digits = 2)| lambda | .lower | .upper | .width | .point | .interval |
|---|---|---|---|---|---|
| 13.75 | 10.02 | 18.17 | 0.99 | mean | qi |
5.2.8 Odds a posteriori
En los contrastes bayesianos resulta habitual comparar las probabilidades a posteriori de las hipótesis mediante las odds a posteriori:
\[ \mbox{Odds}(H_0|x) = \frac{P(H_0|x)}{P(H_1|x)}. \]
Si las odds a posteriori son mayores que 1, la hipótesis nula es más probable que la alternativa; si son menores que 1, la alternativa es más probable que la nula.
Ejemplo 5.5 En el ejemplo de la prevalencia de la hipertensión, las odds a posteriori de que la prevalencia sea mayor que el 30 % se calculan con
tension_post |>
  spread_draws(p) |>
  summarise(odds = mean(p > 0.3) / mean(p <= 0.3)) |>
kable(digits = 1)| odds |
|---|
| 16.7 |
Es decir, la hipótesis de que la prevalencia supera el 30 % es casi 17 veces más probable que la alternativa.
5.2.9 Factor de Bayes
En ocasiones interesa comparar las odds de la hipótesis nula según la distribución a posteriori con las odds según la distribución a priori. Para ello se utiliza el factor de Bayes.
Definición 5.4 (Factor de Bayes) El factor de Bayes es la razón entre las odds a posteriori y las odds a priori de una hipótesis \(H_0\) frente a una hipótesis \(H_1\):
\[ \mbox{BF} = \frac{\mbox{Odds}(H_0|x)}{\mbox{Odds}(H_0)}. \]
Esta medida cuantifica la evidencia que aportan los datos a favor de una hipótesis frente a otra, teniendo en cuenta la información previa que se tenía sobre el parámetro.
- Si \(\mbox{BF} = 1\), la plausibilidad de \(H_0\) no ha cambiado tras observar los datos.
- Si \(\mbox{BF} < 1\), la plausibilidad de \(H_0\) ha disminuido tras observar los datos, es decir, los datos aportan más evidencia a favor de \(H_1\) que de \(H_0\).
- Si \(\mbox{BF} > 1\), la plausibilidad de \(H_0\) ha aumentado tras observar los datos, es decir, los datos aportan más evidencia a favor de \(H_0\) que de \(H_1\).
Ejemplo 5.6 En el ejemplo de la prevalencia de la hipertensión, el factor de Bayes a favor de que la prevalencia sea mayor que el 30 % se calcula con
tension_post |>
  spread_draws(p) |>
  summarise(odds_prior = (1 - pbeta(0.3, 4, 6)) / pbeta(0.3, 4, 6),
            odds_post = mean(p > 0.3) / mean(p <= 0.3),
            BF = odds_post / odds_prior) |>
kable(digits = 1)| odds_prior | odds_post | BF |
|---|---|---|
| 2.7 | 16.7 | 6.2 |
En este caso, el factor de Bayes es de aproximadamente 6,2. Es decir, los datos multiplican por 6,2 las odds a favor de que la prevalencia supere el 30 %, lo que indica que aportan bastante más evidencia a favor de esa hipótesis que a favor de la alternativa. Como hay que tener en cuenta que la prior ya daba una probabilidad alta a ese suceso (0,73), este factor debe leerse junto con las odds a posteriori.
Ejercicio 5.3 En el ejemplo de la incidencia de la tuberculosis, calcula el factor de Bayes a favor de que la incidencia sea mayor que 15 casos por cada 100.000 habitantes y año, es decir, de \(H_1: \lambda > 15\) frente a \(H_0: \lambda \leq 15\).
Solución
tuberculosis_post |>
  spread_draws(lambda) |>
  summarise(odds_prior = (1 - pgamma(15, 27.5, 2.5)) / pgamma(15, 27.5, 2.5),
            odds_post = mean(lambda > 15) / mean(lambda <= 15),
            BF = odds_post / odds_prior) |>
kable(digits = 2)| odds_prior | odds_post | BF |
|---|---|---|
| 0.04 | 0.27 | 6.89 |
5.3 Predicciones
5.3.1 Predicciones en estadística frecuentista
En estadística frecuentista, las predicciones suelen ser puntuales: se obtiene un único valor como predicción para una nueva observación de la variable de interés. Este valor suele ser una medida de tendencia central de la distribución de la variable, determinada por los parámetros estimados a partir de la muestra.
- Media: valor esperado de la variable. Es la medida de tendencia central más informativa, pero también la más sensible a los datos atípicos.
- Mediana: valor que deja el mismo número de observaciones por debajo y por encima de él. Es más robusta que la media porque no se ve afectada por los datos atípicos.
- Moda: valor más frecuente. Puede ser útil para variables categóricas o discretas, pero es poco informativa para variables continuas.
5.3.2 Predicciones en estadística bayesiana
Para realizar predicciones en estadística bayesiana hay que tener en cuenta no solo la incertidumbre sobre la variable que queremos predecir, sino también la incertidumbre sobre los parámetros que describen su distribución. En general, hay dos fuentes de variabilidad:
- Variabilidad del muestreo: la variabilidad que se produce al tomar una muestra aleatoria de la población. Por ejemplo, el número de personas con hipertensión en una muestra de 10 personas sigue una distribución binomial \(B(10, p)\) cuando conocemos \(p\).
- Variabilidad de los parámetros: la variabilidad que se produce al estimar los parámetros de la distribución. Por ejemplo, \(p\) no se conoce con exactitud y se describe mediante su distribución a posteriori.
5.3.3 Distribución predictiva posterior
Ambas fuentes de variabilidad deben combinarse. Si \(\tilde{X}\) representa la variable a predecir, la probabilidad de obtener una predicción \(\tilde X=\tilde x\) es la verosimilitud \(f(\tilde x|\theta)\) ponderada por la probabilidad de cada valor de \(\theta\) según la distribución a posteriori \(f(\theta|x)\).
Definición 5.5 (Distribución predictiva posterior) Dada una variable aleatoria \(\tilde{X}\) cuya distribución depende de un parámetro \(\theta\), y la distribución a posteriori \(f(\theta|x)\) del parámetro una vez observados los datos \(x\), la distribución predictiva posterior de \(\tilde{X}\) es
\[ P(\tilde{X} = \tilde x|x) = \int_{\Theta} f(\tilde x|\theta) f(\theta|x) \, d\theta, \]
donde \(f(\tilde x|\theta)\) es la función de verosimilitud de la nueva observación \(\tilde x\) dado el parámetro \(\theta\).
Esta distribución nos da una predicción completa, que refleja todos los valores posibles de la nueva observación y su probabilidad.
5.3.4 Simulación de la distribución predictiva posterior
Para simular la distribución predictiva posterior basta con simular una muestra de valores de \(\theta\) a partir de la distribución a posteriori \(f(\theta|x)\) y, para cada uno de esos valores, simular un valor de \(\tilde{X}\) a partir de la verosimilitud \(f(\tilde x|\theta)\).
Ejemplo 5.7 En el ejemplo de la prevalencia de la hipertensión, simulamos la distribución predictiva posterior del número de personas con hipertensión en una nueva muestra de 10 personas:
tension_pred <- tension_post |>
  spread_draws(p) |>  # Extraemos las muestras de la distribución a posteriori de p
  # Generamos una predicción para cada valor de p obtenido en la muestra (20000 en total)
  mutate(pred = rbinom(n(), size = 10, prob = p))  |>
  select(p, pred)
head(tension_pred, 5) |>  # Mostramos las 5 primeras predicciones
kable(digits = 3)| p | pred |
|---|---|
| 0.309 | 3 |
| 0.375 | 5 |
| 0.315 | 6 |
| 0.420 | 6 |
| 0.330 | 3 |
Solo se muestran las 5 primeras de las 20000 predicciones obtenidas por simulación.
Podemos dibujar un diagrama de barras con la distribución predictiva posterior:
tension_pred |>
  ggplot(aes(x = pred, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "Número de personas con hipertensión en 10", y = "Frecuencia relativa") +
  theme_gray()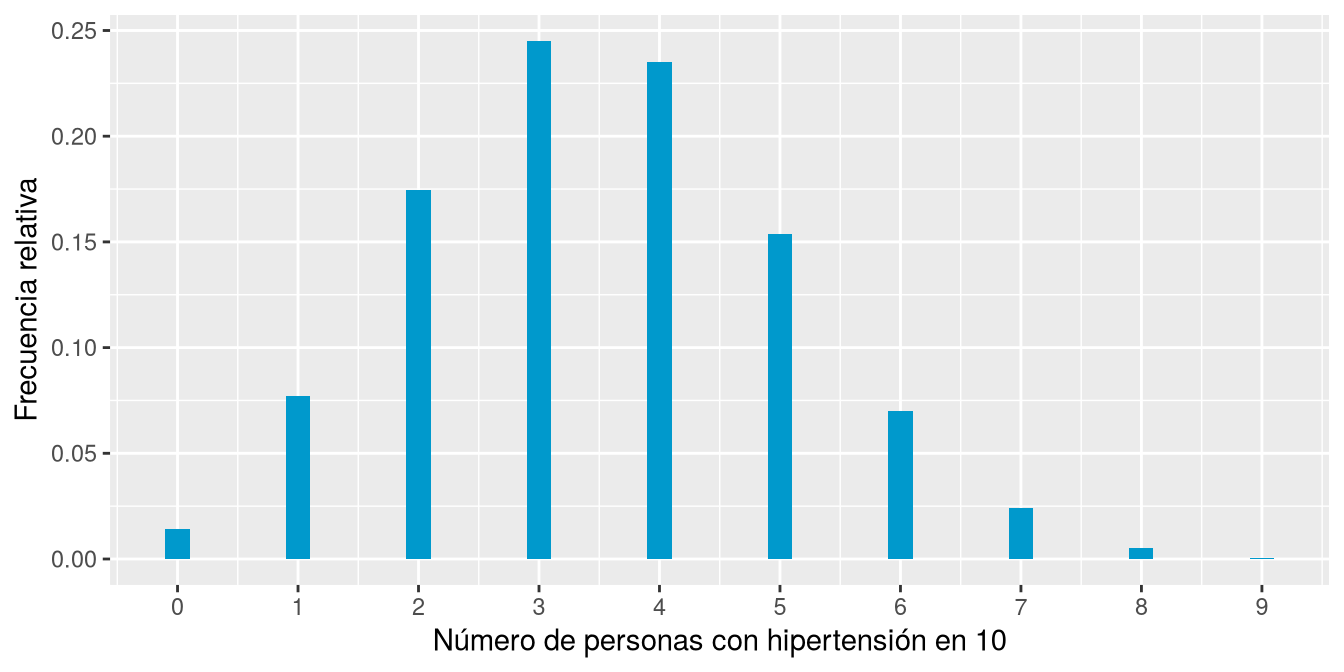
5.3.5 Resumen de la distribución predictiva posterior
La predicción que obtenemos no es un valor puntual, sino toda una distribución que refleja la incertidumbre sobre los valores posibles. Si necesitamos un valor puntual, podemos calcular cualquier medida de tendencia central sobre esta distribución, aunque es preferible dar un intervalo de credibilidad para la predicción.
Ejemplo 5.8 Continuando con el ejemplo anterior, calculamos la media, la desviación típica y el intervalo de credibilidad del 90 % de la distribución predictiva posterior:
tension_pred |>
  summarise(mean = mean(pred),
            sd = sd(pred),
            li = quantile(pred, 0.05),
            ls = quantile(pred, 0.95)) |>
kable(digits = 2)| mean | sd | li | ls |
|---|---|---|---|
| 3.51 | 1.54 | 1 | 6 |
Ejercicio 5.4 Dibuja la distribución predictiva posterior del número de casos de tuberculosis en una nueva muestra de 10.000 personas del ejemplo anterior, y resúmela con la media, la desviación típica y el intervalo de credibilidad del 95 %.
Solución
Una muestra de 10.000 personas equivale a 0,1 unidades de 100.000 habitantes, así que el número de casos se simula con una Poisson de media \(0{,}1\lambda\).
tuberculosis_pred <- tuberculosis_post |>
  spread_draws(lambda) |>  # Extraemos las muestras de la distribución a posteriori de lambda
  # Generamos una predicción para cada valor de lambda (20000 en total)
  mutate(pred = rpois(n(), lambda = lambda / 10))  |>
  select(lambda, pred)
tuberculosis_pred |>
  ggplot(aes(x = pred, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "Número de casos de tuberculosis en 10.000 personas", y = "Frecuencia relativa") +
  theme_gray()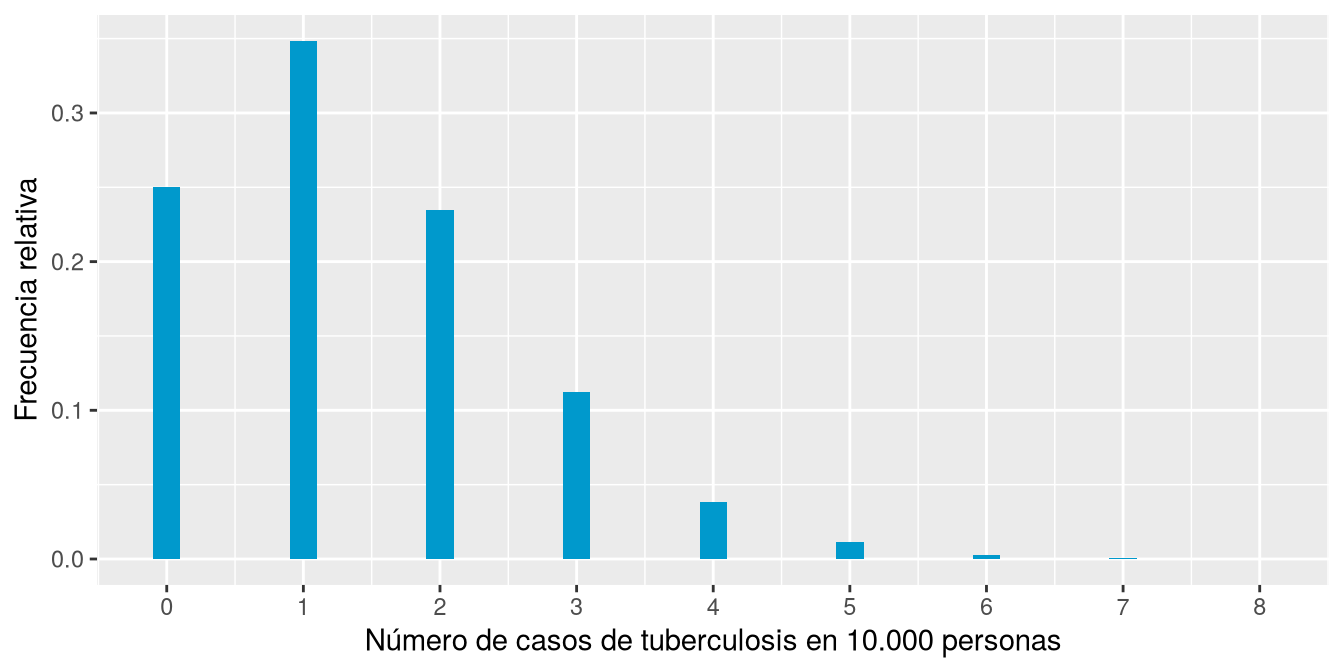
tuberculosis_pred |>
  summarise(mean = mean(pred),
            sd = sd(pred),
            li = quantile(pred, 0.025),
            ls = quantile(pred, 0.975)) |>
kable(digits = 2)| mean | sd | li | ls |
|---|---|---|---|
| 1.39 | 1.19 | 0 | 4 |
5.4 Referencias del capítulo
- Gelman, A., Carlin, J.B., Stern, H.S., Dunson, D.B., Vehtari, A., y Rubin, D.B. (2013). Bayesian Data Analysis, 3.ª ed. CRC Press. Capítulos 2 y 6.
- Kruschke, J.K. (2015). Doing Bayesian Data Analysis, 2.ª ed. Academic Press. Capítulos 11-12.