La regla de Bayes es el núcleo de la estadística bayesiana. Permite actualizar la probabilidad de una hipótesis a partir de la evidencia observada. En este capítulo se presenta el teorema de Bayes sobre sistemas completos de sucesos, se introducen los conceptos de distribución a priori, función de verosimilitud y distribución a posteriori, y se simula el proceso de actualización con R. Al final se estudian las distribuciones conjugadas, que simplifican mucho el cálculo de la posterior.
4.1 Sistema completo de sucesos
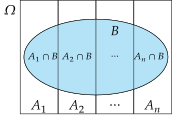
Definición 4.1 (Sistema completo de sucesos) Una colección de sucesos \(A_1,A_2,\ldots,A_n\) de un mismo espacio muestral \(\Omega\) es un sistema completo si cumple las siguientes condiciones:
La unión de todos ellos es el espacio muestral: \(A_1\cup \cdots\cup A_n =\Omega\).
Son incompatibles dos a dos: \(A_i\cap A_j = \emptyset\) para todo \(i\neq j\).
En realidad, un sistema completo de sucesos es una partición del espacio muestral de acuerdo con algún atributo, como el sexo o el grupo sanguíneo.
4.2 Teorema de la probabilidad total
Conocer las probabilidades de un determinado suceso en cada una de las partes de un sistema completo puede ser útil para calcular su probabilidad global.
Teorema 4.1 (Probabilidad total) Dado un sistema completo de sucesos \(A_1,\ldots,A_n\) de un espacio muestral \(\Omega\) y un suceso \(B\) de ese mismo espacio muestral, la probabilidad de \(B\) se puede calcular mediante la fórmula
\[P(B) = \sum_{i=1}^n P(A_i\cap B) = \sum_{i=1}^n P(A_i)P(B|A_i).\]
Teorema de la probabilidad total.
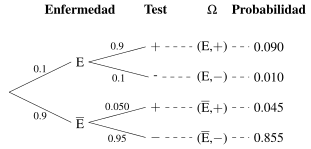
Ejemplo 4.1 Un test diagnóstico para una enfermedad \(E\) tiene una sensibilidad del 90 % y una especificidad del 95 %, es decir,
Es decir, alrededor del 13,5 % de los resultados del test serán positivos.
En el fondo se trata de una media ponderada de probabilidades.
4.3 Teorema de Bayes
Los sucesos de un sistema completo \(A_1,\ldots,A_n\) también pueden verse como las distintas hipótesis ante un determinado hecho \(B\). En estas condiciones resulta útil poder calcular las probabilidades a posteriori \(P(A_i|B)\) de cada una de las hipótesis.
Teorema 4.2 (Teorema de Bayes) Dado un sistema completo de sucesos \(A_1,\ldots,A_n\) y un suceso \(B\) de un mismo espacio muestral \(\Omega\), la probabilidad de cada suceso \(A_i\) condicionada por \(B\) puede calcularse con la fórmula
Ejemplo 4.2 En el ejemplo anterior, una pregunta más interesante es qué diagnosticar a una persona que ha dado positivo en el test. Podemos interpretar \(E\) y \(\overline{E}\) como las dos posibles hipótesis ante el resultado positivo del test.
Probabilidades a priori (sin información sobre el resultado del test)
Sin información, el diagnóstico sería que la persona no tiene la enfermedad.
Sin embargo, si al realizar el test a una persona se obtiene un resultado positivo, esa información condiciona las hipótesis. Para decidir entre ellas hay que calcular sus probabilidades a posteriori, \(P(E|+)\) y \(P(\overline{E}|+)\):
Con un resultado positivo, la probabilidad de tener la enfermedad ha aumentado de 0,10 a 0,667, y el diagnóstico pasa a ser que la persona tiene la enfermedad.
Ejercicio 4.1 Se dispone de dos test, \(A\) y \(B\), para diagnosticar una enfermedad con una prevalencia del 1 % en la población. El test \(A\) tiene una sensibilidad del 98 % y una especificidad del 80 %, mientras que el test \(B\) tiene una sensibilidad del 75 % y una especificidad del 99 %.
¿Cuál de los dos test funcionaría mejor como test de cribado?
Si aplicamos el test de cribado a una persona y da positivo, ¿cuál es la probabilidad de que esté enferma? ¿Qué diagnosticaríamos?
Si aplicamos a una persona el test de cribado y, después, el otro test, y ambos dan positivo, ¿cuál es la probabilidad de que esté enferma? ¿Qué diagnosticaríamos?
Solución
Para cribado se prioriza una alta sensibilidad, es decir, detectar a todos los enfermos minimizando los falsos negativos. Por tanto, el test \(A\) es mejor para cribado. Su baja especificidad (80 %) produce falsos positivos, pero estos se filtran con una prueba confirmatoria posterior.
Aplicando el teorema de Bayes al resultado positivo del test \(A\):
Como \(P(E|+_A,+_B) \approx 0{,}79 > 0{,}5\), diagnosticaríamos enfermedad.
4.4 Regla de Bayes
En terminología bayesiana, si \(H\) representa una hipótesis y \(D\) los datos observados, el teorema de Bayes se puede expresar como una regla de actualización de la probabilidad de la hipótesis \(H\) a la luz de la evidencia \(D\):
\[
\underbrace{P(H|D)}_{\text{Probabilidad a posteriori}} = \frac{\overbrace{P(H)}^{\text{Probabilidad a priori}}\times \overbrace{P(D|H)}^{\text{Verosimilitud}}}{\underbrace{P(D)}_{\text{Evidencia marginal}}}
\]
El denominador \(P(D)\) actúa como normalizador: garantiza que las probabilidades a posteriori de todas las hipótesis sumen 1.
4.5 Función de verosimilitud
En la regla de Bayes, la probabilidad \(P(D|H)\) se conoce como verosimilitud de la hipótesis \(H\) dada la evidencia \(D\).
Cuando tenemos varias hipótesis, la verosimilitud de cada una de ellas se puede comparar con la de las demás para determinar cuál es la más compatible con los datos observados.
Definición 4.2 (Función de verosimilitud) Dado un sistema completo de sucesos con hipótesis \(H_1, H_2, \ldots, H_n\) y un suceso \(D\) que representa la evidencia observada, la función de verosimilitud asigna a cada hipótesis \(H_i\) la probabilidad de observar la evidencia \(D\) si esa hipótesis fuera cierta:
\[
L(H_i|D) = P(D|H_i).
\]
Importante
Los valores de la función de verosimilitud son probabilidades condicionadas, pero la variable de la función de verosimilitud es el condicionante, es decir, la hipótesis \(H_i\), y no la evidencia \(D\):
\[
L(x|D) = P(D|x).
\]
Ejemplo 4.3 Consideremos de nuevo el test diagnóstico con sensibilidad del 90 % y especificidad del 95 %. Dada la evidencia de que el resultado del test ha sido positivo, la función de verosimilitud de las dos hipótesis \(E\) y \(\overline{E}\) es
En este caso, la hipótesis \(E\) es mucho más compatible con la evidencia \(+\) que la hipótesis \(\overline{E}\).
4.5.1 Interpretación de la función de verosimilitud
La función de verosimilitud se puede interpretar como una medida de la compatibilidad de cada hipótesis con los datos observados: cuanto mayor sea la verosimilitud de una hipótesis dada la evidencia, más plausible será la hipótesis.
Es importante destacar que la función de verosimilitud no es una función de probabilidad: la suma de las verosimilitudes de todas las hipótesis no tiene por qué ser igual a 1.
Ejemplo 4.4 La siguiente tabla recoge la probabilidad a priori y la función de verosimilitud de las hipótesis \(E\) y \(\overline{E}\) dada la evidencia \(+\) en el ejemplo del test diagnóstico.
Hipótesis
Probabilidad a priori \(P(H)\)
Función de verosimilitud \(L(H\mid +)\)
\(E\)
0,1
0,9
\(\overline{E}\)
0,9
0,05
4.6 Probabilidad a posteriori
Si disponemos de la probabilidad a priori de cada hipótesis y de su función de verosimilitud dada la evidencia, podemos calcular la probabilidad a posteriori de cada hipótesis con la regla de Bayes:
La probabilidad del denominador \(P(D)\) es un factor común para todas las hipótesis, por lo que la probabilidad a posteriori de cada hipótesis es proporcional al producto de su probabilidad a priori por su verosimilitud:
\[
P(H_i|D) \propto P(H_i)\times P(D|H_i).
\]
Ejemplo 4.5 En el ejemplo del test diagnóstico, dado que el test ha resultado positivo, obtenemos las siguientes plausibilidades a posteriori:
Hipótesis
Probabilidad a priori \(P(H)\)
Verosimilitud \(L(H\mid +)\)
Plausibilidad a posteriori \(P(H)\times L(H\mid +)\)
\(E\)
0,1
0,9
0,090
\(\overline{E}\)
0,9
0,05
0,045
La suma de las plausibilidades a posteriori no es igual a 1, por lo que no se pueden interpretar como probabilidades. Sin embargo, sí podemos compararlas: la hipótesis \(E\) es el doble de plausible que la hipótesis \(\overline{E}\) dada la evidencia de que el test ha resultado positivo.
¿Cómo podemos transformar las plausibilidades a posteriori en probabilidades a posteriori? Normalizándolas: dividiendo cada una de ellas por la suma de todas las plausibilidades.
Hipótesis
Plausibilidad a posteriori
Probabilidad a posteriori \(P(H\mid +)\)
\(E\)
0,090
0,090/(0,090+0,045) = 0,667
\(\overline{E}\)
0,045
0,045/(0,090+0,045) = 0,333
4.7 Simulación de la regla de Bayes
Podemos simular el procedimiento de actualización de la probabilidad de una hipótesis a la luz de la evidencia que realiza la regla de Bayes. Para ello necesitamos tomar muestras aleatorias de:
La distribución a priori de la hipótesis \(H\).
La distribución conjunta de la hipótesis \(H\) y la evidencia \(D\), teniendo en cuenta la función de verosimilitud \(L(H|D)\).
Al filtrar después la muestra conjunta por la evidencia observada, obtenemos una muestra de la distribución a posteriori.
4.7.1 Muestreo de la distribución a priori
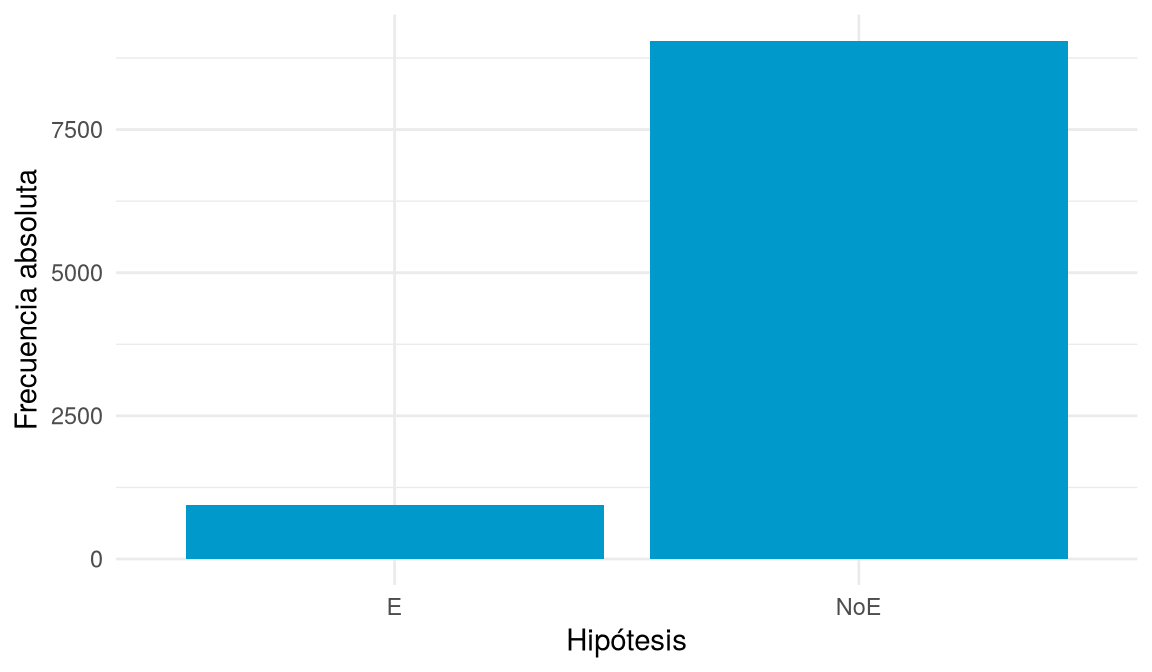
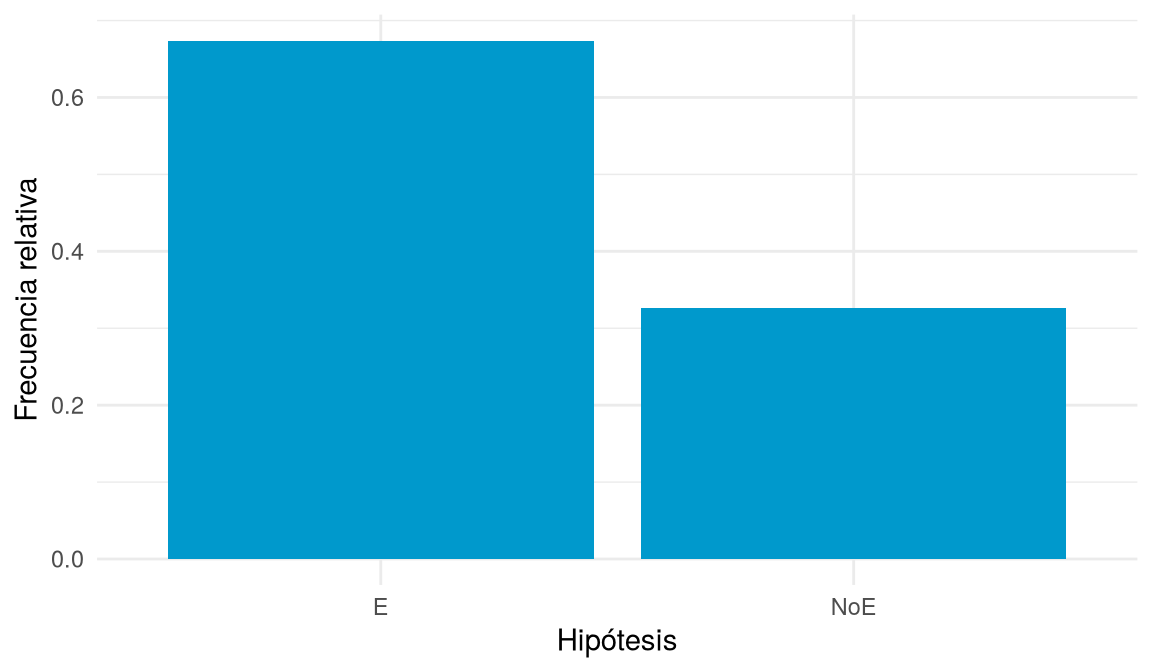
Ejercicio 4.2 Obtener una muestra aleatoria de tamaño \(n=10000\) de la distribución a priori de la hipótesis \(H\), con probabilidades \(P(E)=0{,}1\) y \(P(\overline{E})=0{,}9\), y representar gráficamente la distribución de frecuencias muestral.
Solución
df_H =tibble(hipótesis =c("E", "NoE")) # Hipótesisprior <-c(0.1, 0.9) # P(E) y P(No E)set.seed(123) # Para reproducibilidadn <-10000# Tamaño de la muestra# Muestreo de la distribución a priorimuestra_prior <-slice_sample(df_H, n = n, weight_by = prior, replace =TRUE)# Diagrama de barras de la distribución de frecuenciasggplot(muestra_prior, aes(x = hipótesis)) +stat_count(fill = myblue) +labs(x ="Hipótesis", y ="Frecuencia absoluta") +theme_minimal()
Figura 4.1: Distribución de frecuencias de una muestra de la distribución a priori.
4.7.2 Muestreo de la distribución conjunta
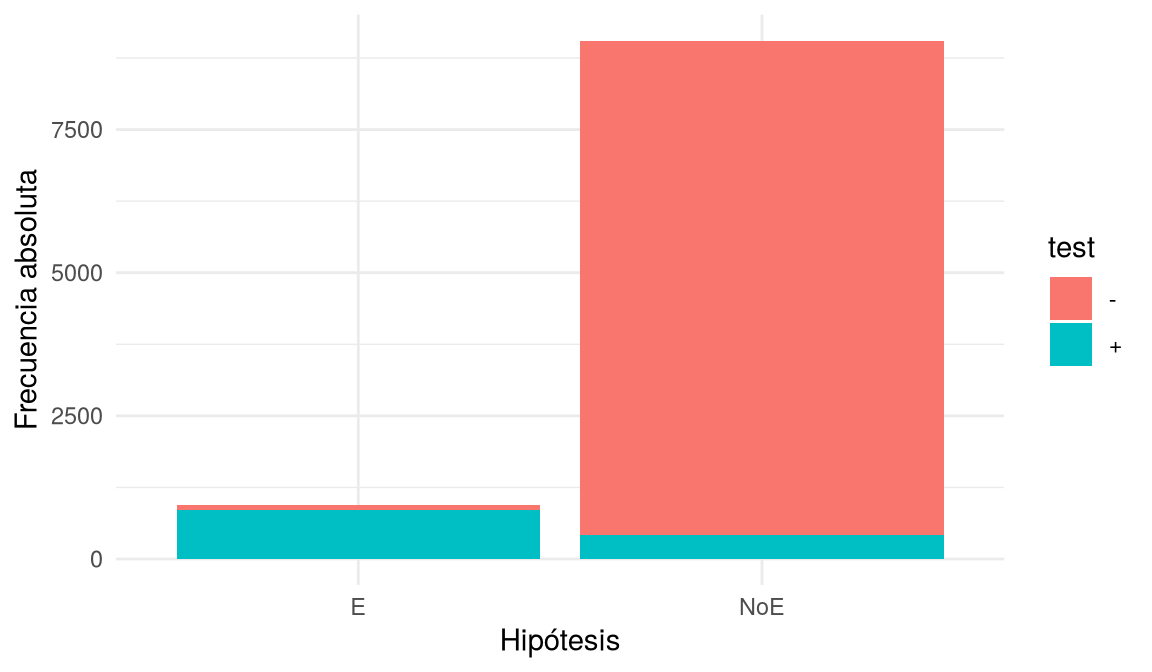
Para simular la distribución conjunta de la hipótesis y el resultado del test, generamos para cada individuo de la muestra un resultado del test según la función de verosimilitud: \(P(+|E)=0{,}9\) y \(P(+|\overline E)=0{,}05\).
# Muestreo de la función de verosimilitud (resultado del test)muestra_prior <- muestra_prior |>mutate(test =ifelse(runif(n()) <ifelse(hipótesis =="E", 0.9, 0.05), "+", "-"))# Diagrama de barras de la distribución de frecuencias del testggplot(muestra_prior, aes(x = hipótesis, fill = test)) +stat_count(position ="stack") +labs(x ="Hipótesis", y ="Frecuencia absoluta") +theme_minimal()
Figura 4.2: Distribución de frecuencias conjunta de la hipótesis y el resultado del test.
4.7.3 Muestreo de la distribución a posteriori
Una vez tenemos la distribución conjunta, podemos obtener una muestra de la distribución a posteriori filtrando los casos en los que el resultado del test ha sido positivo.
# Filtrar casos con test positivomuestra_posterior <- muestra_prior |>filter(test =="+")# Diagrama de barras de la distribución de frecuencias de la muestra a posterioriggplot(muestra_posterior, aes(x = hipótesis, y =after_stat(prop), group =1)) +stat_count(fill = myblue) +labs(x ="Hipótesis", y ="Frecuencia relativa") +theme_minimal()
Figura 4.3: Distribución de frecuencias de una muestra de la distribución a posteriori.
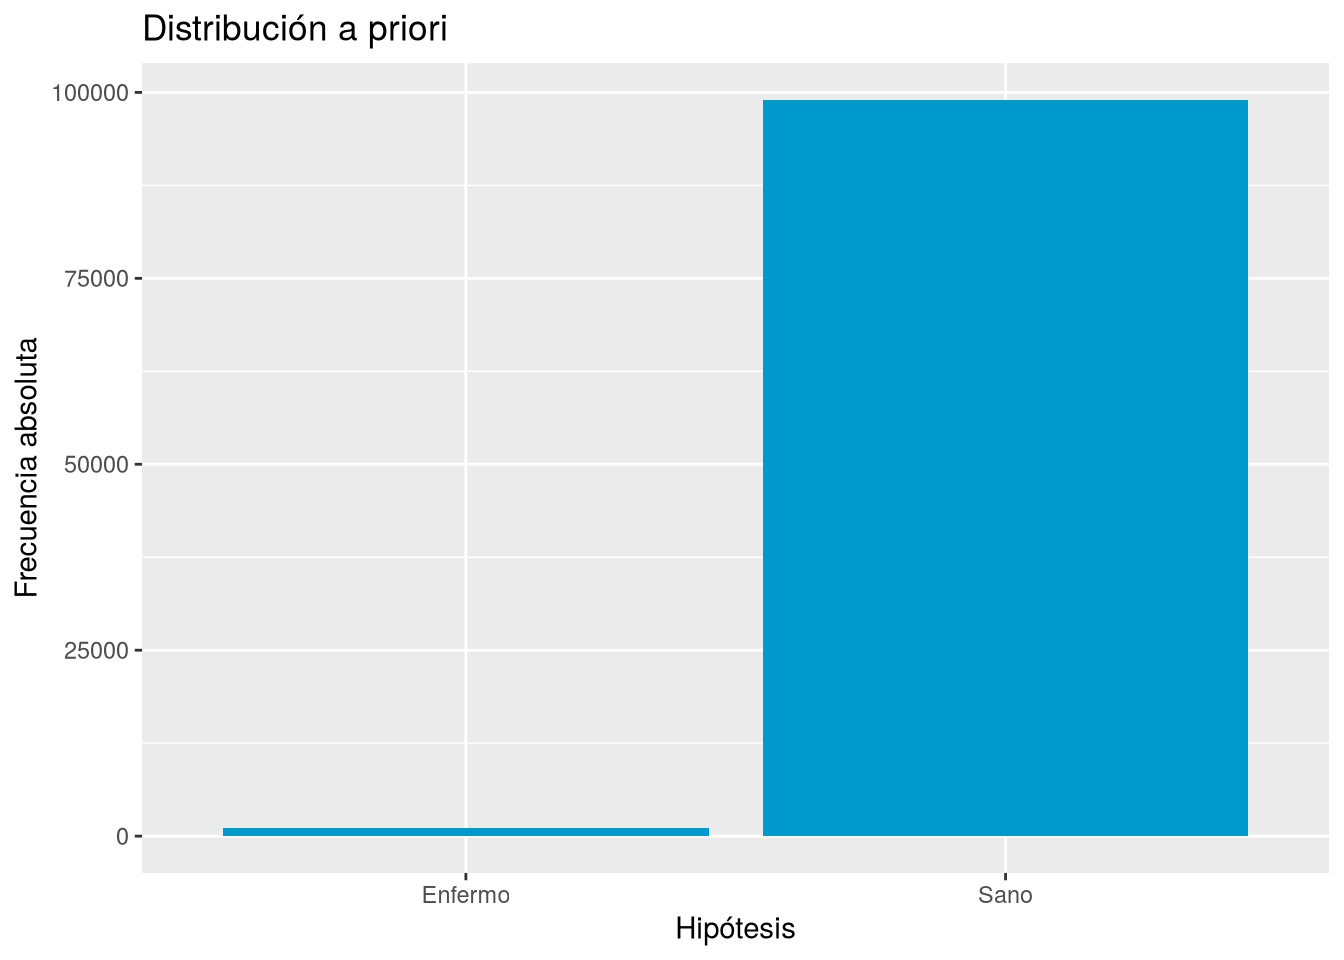
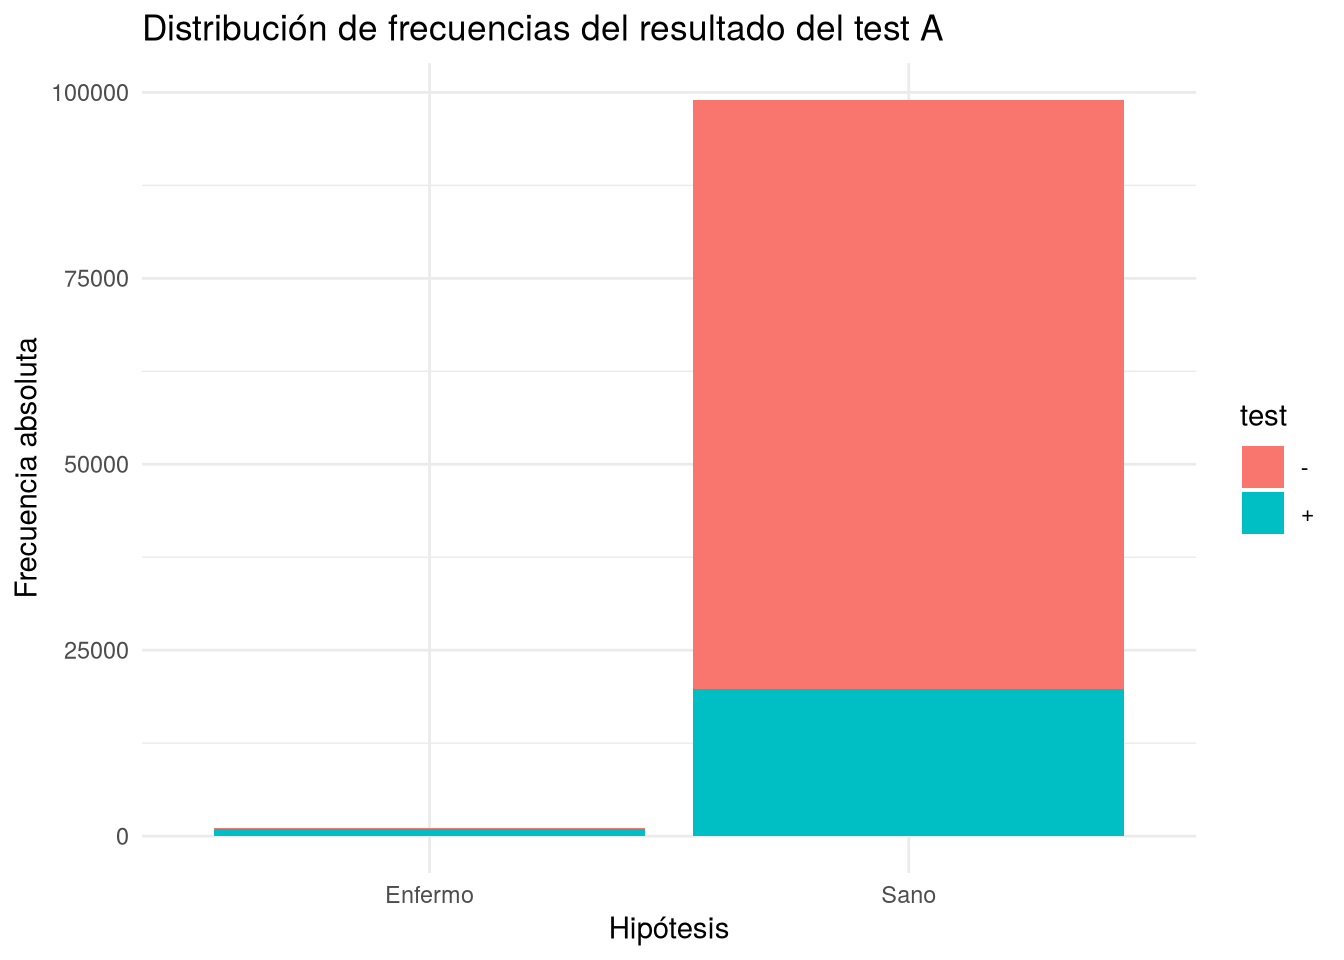
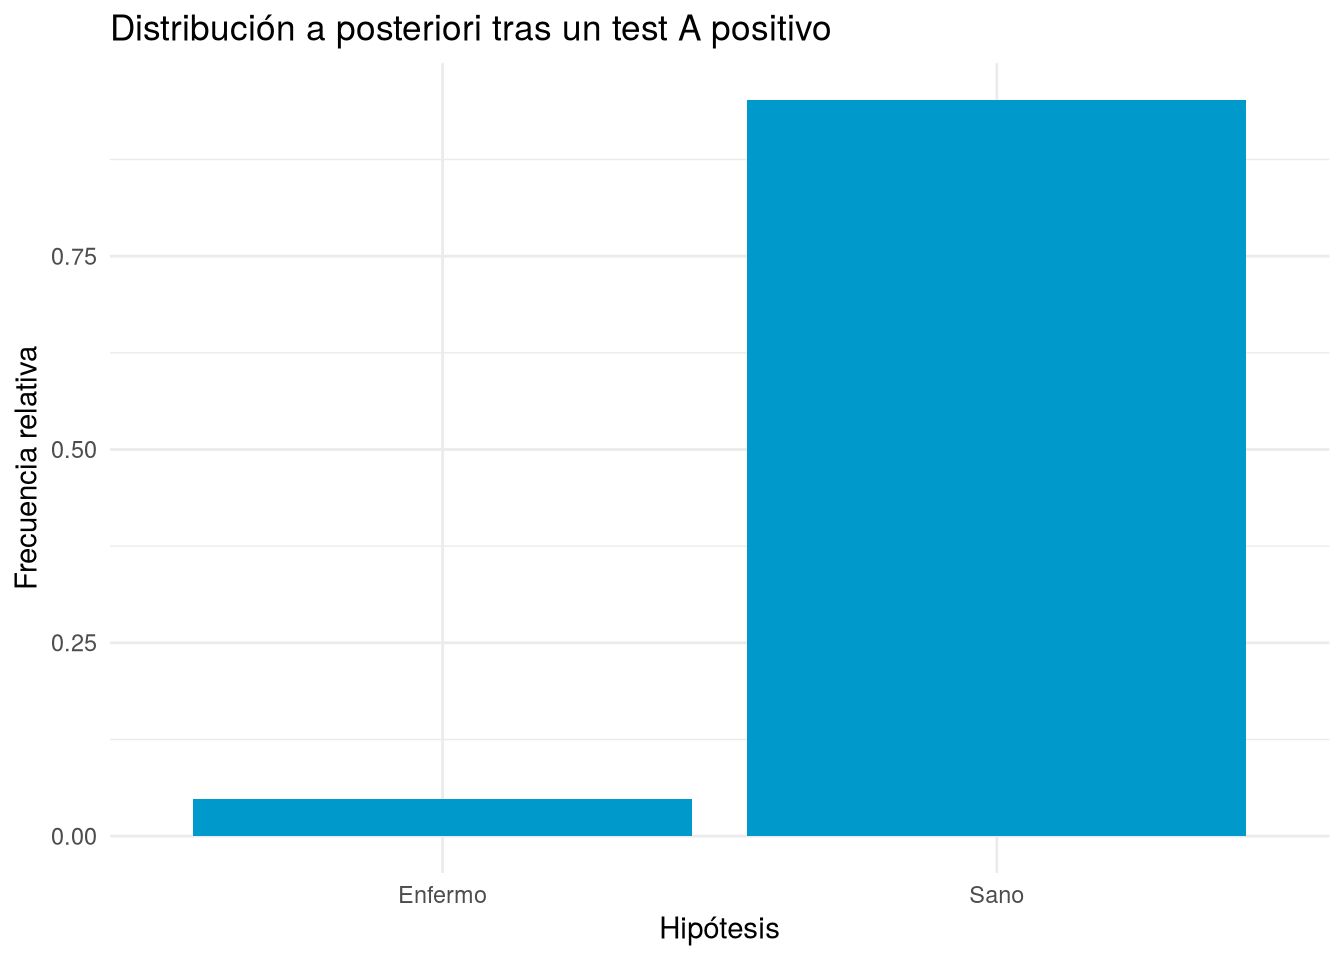
Ejercicio 4.3 Repetimos la simulación con 100000 individuos. La prevalencia de la enfermedad es del 1 % (prior \(P(E)=0{,}01\)), el test \(A\) tiene sensibilidad \(0{,}98\) y especificidad \(0{,}80\), y el test \(B\) tiene sensibilidad \(0{,}75\) y especificidad \(0{,}99\).
Obtener una muestra aleatoria de tamaño 100000 de la distribución a priori de la hipótesis y representarla gráficamente.
Obtener una muestra aleatoria de tamaño 100000 de la distribución conjunta de las hipótesis y el resultado del test \(A\) y representarla gráficamente.
Obtener una muestra aleatoria de la distribución a posteriori de las hipótesis dada la evidencia de que el test \(A\) ha resultado positivo y representarla gráficamente.
Obtener una muestra aleatoria de la distribución conjunta de las hipótesis y el resultado del test \(B\) y representarla gráficamente.
Obtener una muestra aleatoria de la distribución a posteriori de las hipótesis dada la evidencia de que el test \(B\) ha resultado positivo y representarla gráficamente.
Solución
df_H =tibble(hipótesis =c("Enfermo", "Sano")) # Hipótesisprior <-c(0.01, 0.99) # P(Enfermo) y P(Sano)set.seed(123) # Para reproducibilidadn <-100000# Tamaño de la muestra# Muestreo de la distribución a priorimuestra_prior <-slice_sample(df_H, n = n, weight_by = prior, replace =TRUE)muestra_prior |>ggplot(aes(x = hipótesis)) +stat_count(fill = myblue) +labs(title ="Distribución a priori", x ="Hipótesis", y ="Frecuencia absoluta")
# Muestreo de la distribución conjunta con el test Amuestra_prior <- muestra_prior |>mutate(test =ifelse(runif(n()) <ifelse(hipótesis =="Enfermo", 0.98, 0.2), "+", "-"))ggplot(muestra_prior, aes(x = hipótesis, fill = test)) +stat_count(position ="stack") +labs(title ="Distribución de frecuencias del resultado del test A",x ="Hipótesis", y ="Frecuencia absoluta") +theme_minimal()
# Filtrar casos con test A positivomuestra_posterior <- muestra_prior |>filter(test =="+")ggplot(muestra_posterior, aes(x = hipótesis, y =after_stat(prop), group =1)) +stat_count(fill = myblue) +labs(title ="Distribución a posteriori tras un test A positivo",x ="Hipótesis", y ="Frecuencia relativa") +theme_minimal()
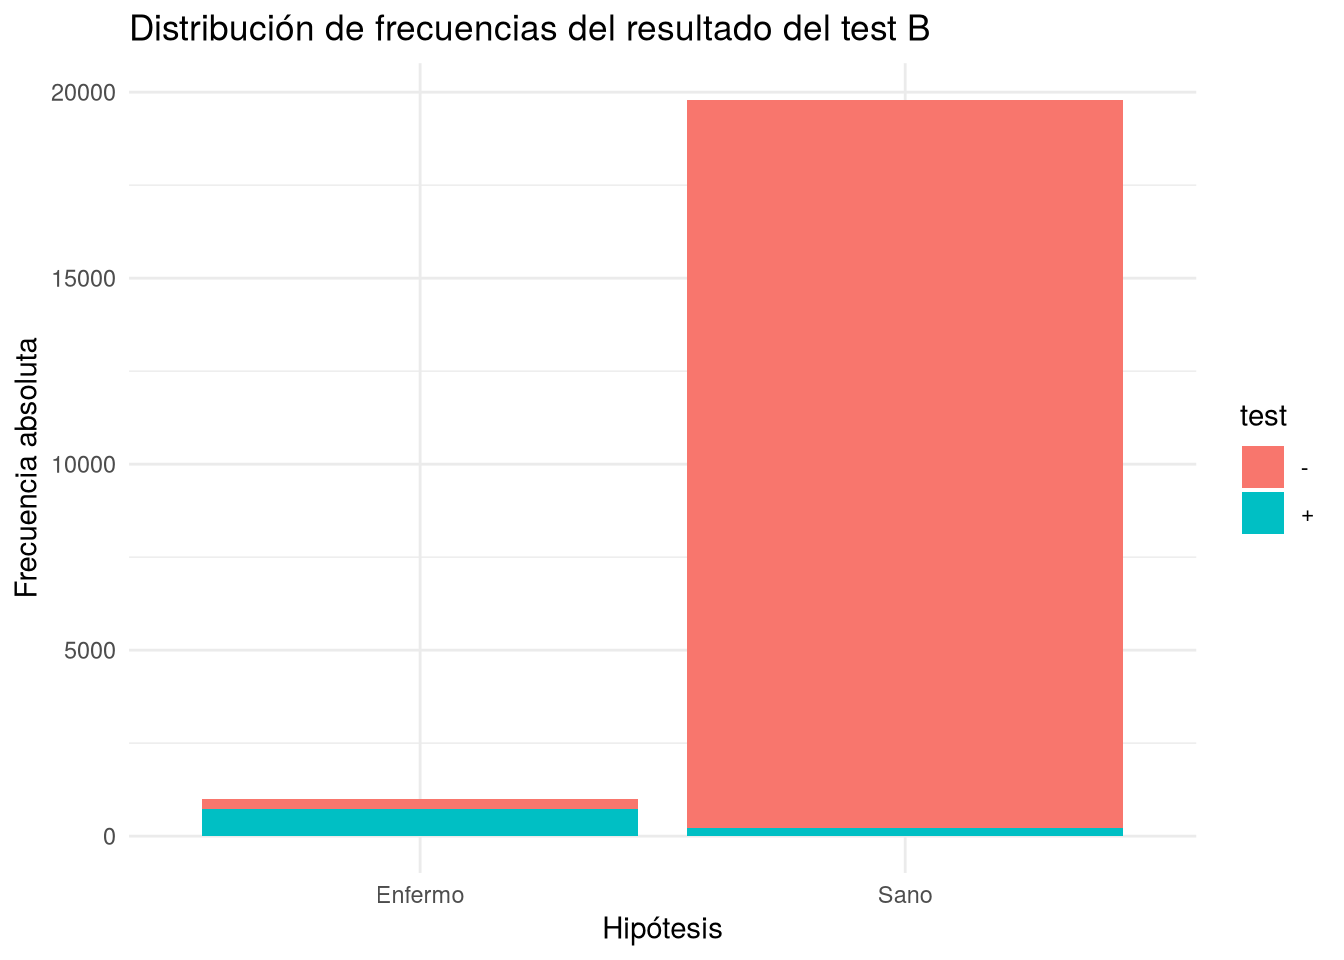
# Muestreo de la distribución conjunta con el test B sobre los positivos de Amuestra_prior2 <- muestra_posterior |>mutate(test =ifelse(runif(n()) <ifelse(hipótesis =="Enfermo", 0.75, 0.01), "+", "-"))ggplot(muestra_prior2, aes(x = hipótesis, fill = test)) +stat_count(position ="stack") +labs(title ="Distribución de frecuencias del resultado del test B",x ="Hipótesis", y ="Frecuencia absoluta") +theme_minimal()
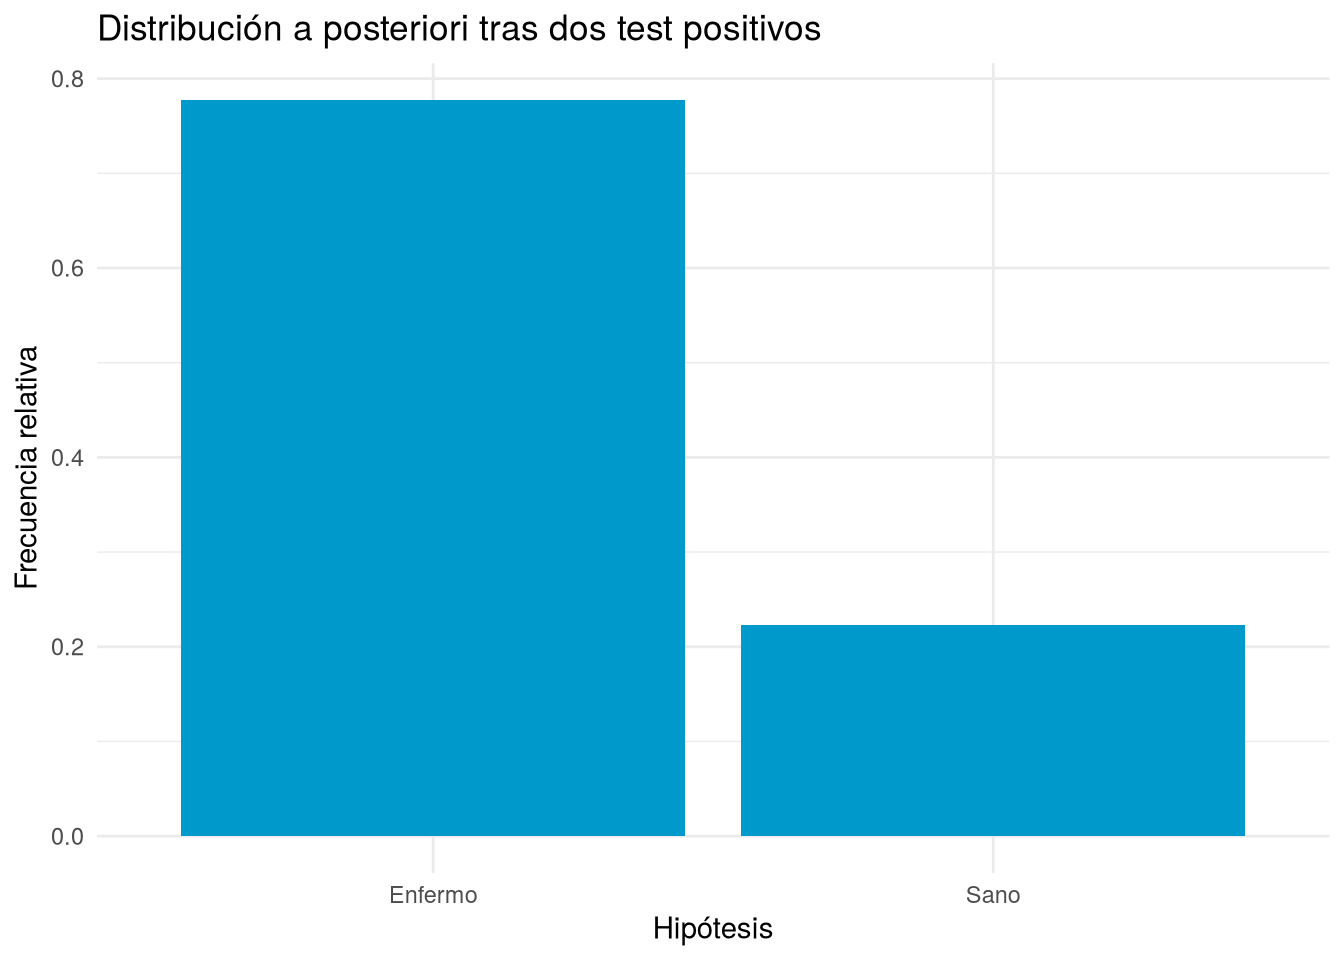
# Filtrar casos con test B positivomuestra_posterior <- muestra_prior2 |>filter(test =="+")ggplot(muestra_posterior, aes(x = hipótesis, y =after_stat(prop), group =1)) +stat_count(fill = myblue) +labs(title ="Distribución a posteriori tras dos test positivos",x ="Hipótesis", y ="Frecuencia relativa") +theme_minimal()
4.8 Distribuciones conjugadas
Hemos visto que, para obtener la distribución de probabilidad a posteriori de una hipótesis dada la evidencia, hay que combinar la distribución a priori de la hipótesis con la función de verosimilitud dada la evidencia, mediante la regla de Bayes.
Existen familias de distribuciones de probabilidad que, al combinarse con determinadas verosimilitudes, mantienen su forma funcional. Estas familias se denominan distribuciones conjugadas y son de gran utilidad en la inferencia bayesiana, porque la posterior se obtiene en forma cerrada sin necesidad de calcular la integral del denominador. Las parejas más comunes son:
Beta-Binomial.
Beta-Geométrica.
Gamma-Poisson.
Gamma-Exponencial.
Normal-Normal.
4.8.1 Distribución conjugada Beta-Binomial
Si \(p\sim \mbox{Beta}(\alpha, \beta)\) y \(X\sim B(n, p)\), entonces la distribución a posteriori de \(p\) dado \(X=k\) es también una distribución beta:
Ejemplo 4.6 Supongamos que queremos estimar la proporción de fumadores en nuestra ciudad y que tenemos una distribución a priori de \(p\) dada por una distribución beta con parámetros \(\alpha=2\) y \(\beta=5\), es decir, \(p\sim \mbox{Beta}(2, 5)\). Si tomamos una muestra aleatoria de \(n=30\) personas y observamos que \(k=10\) de ellas son fumadoras, la distribución a posteriori de \(p\) dado \(X=10\) es
Si \(\lambda \sim \mbox{Gamma}(\alpha, \beta)\) y \(X\sim \mbox{P}(\lambda)\), entonces la distribución a posteriori de \(\lambda\) dado \(X=k\) es también una distribución gamma:
Si se toman \(n\) muestras independientes de la misma distribución \(P(\lambda)\), la distribución a posteriori de \(\lambda\) dado \(X_1=x_1,\ldots,X_n=x_n\) es también una distribución gamma:
Ejemplo 4.7 Supongamos que queremos estimar la tasa de nacimientos diarios en una ciudad. Tenemos una distribución a priori de \(\lambda\) dada por una distribución gamma con parámetros \(\alpha=2\) y \(\beta=5\), es decir, \(\lambda \sim \mbox{Gamma}(2, 5)\). Si observamos que en una muestra de 5 días se han producido \(X_1=10, X_2=8, X_3=9, X_4=11, X_5=7\) nacimientos, la distribución a posteriori de \(\lambda\) es
Si \(\mu \sim N(\theta, \tau^2)\) y \(X\sim N(\mu, \sigma^2)\), entonces la distribución a posteriori de \(\mu\) dado \(X=x\) es también una distribución normal:
Si se toman \(n\) muestras independientes de la misma distribución \(N(\mu, \sigma^2)\), la distribución a posteriori de \(\mu\) dado \(X_1=x_1,\ldots,X_n=x_n\) es también normal:
Ejemplo 4.8 Supongamos que el peso perdido con una dieta sigue una distribución normal \(N(\mu, \sigma^2=4)\) y queremos estimar el peso medio \(\mu\) perdido con la dieta. Tenemos una distribución a priori para \(\mu\) dada por una normal con media \(\theta=10\) y varianza \(\tau^2=1\), es decir, \(\mu \sim N(10, 1)\). Si tomamos una muestra aleatoria de \(n=20\) personas que han seguido la dieta y observamos que el peso medio perdido es \(\bar{x}=8\), la distribución a posteriori de \(\mu\) es
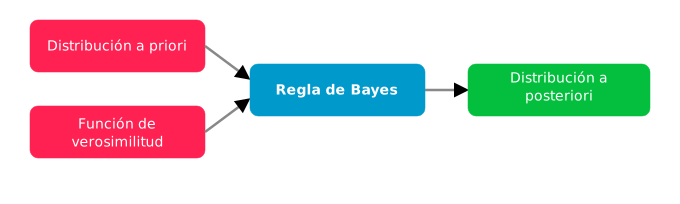
Un modelo bayesiano es un modelo estadístico que incorpora la incertidumbre sobre los parámetros desconocidos mediante distribuciones de probabilidad a priori, y que utiliza la regla de Bayes para actualizar estas distribuciones a posteriori a medida que se obtiene nueva información a través de los datos observados.
Los modelos bayesianos pueden considerarse modelos de aprendizaje automático, porque aprenden distribuciones con la experiencia que se va adquiriendo a partir de los datos observados.
4.9.1 Elementos de un modelo bayesiano
Para definir un modelo bayesiano es necesario especificar:
El espacio de las hipótesis o parámetros desconocidos.
La distribución de probabilidad a priori de las hipótesis o parámetros desconocidos, que refleja la incertidumbre inicial sobre ellos antes de observar los datos.
La distribución de probabilidad de los datos observados para cada hipótesis o valor de los parámetros desconocidos, que viene dada por la función de verosimilitud.
Esquema de un modelo bayesiano.
4.9.2 Distribuciones a priori discretas y continuas
Dependiendo de la naturaleza de las hipótesis o parámetros desconocidos, el espacio de hipótesis puede ser discreto o continuo, lo que da lugar a dos tipos de distribuciones a priori:
Distribuciones a priori discretas. Se utilizan cuando el espacio de hipótesis es discreto, es decir, cuando los parámetros toman un número finito o contable de valores, como en el caso del test diagnóstico con las hipótesis \(E\) y \(\overline{E}\).
Distribuciones a priori continuas. Se utilizan cuando el espacio de hipótesis es continuo, es decir, cuando los parámetros pueden tomar cualquier valor dentro de un intervalo, como en la estimación de la media o de una proporción de una población.
4.9.3 Distribuciones de los datos condicionadas por las hipótesis
Del mismo modo, según la naturaleza de los datos observados, la función de verosimilitud puede modelarse mediante distribuciones de probabilidad discretas o continuas:
Distribuciones de probabilidad discretas. Se utilizan cuando los datos son discretos, como el número de éxitos en una serie de ensayos independientes.
Distribuciones de probabilidad continuas. Se utilizan cuando los datos son continuos, como la altura o el peso de una persona.
4.9.4 Tipos de modelos bayesianos
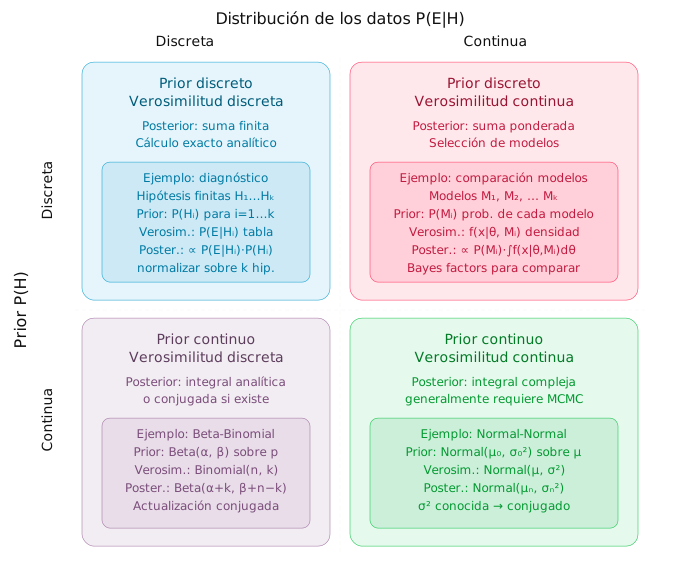
Según el tipo de la distribución a priori y de la distribución de los datos que se usa para calcular la función de verosimilitud, tenemos distintos tipos de modelos bayesianos.
Taxonomía de modelos bayesianos.
Prior discreto y verosimilitud discreta. Las parejas más habituales son la uniforme discreta con la binomial o la de Poisson, y las priors definidas por un experto con la multinomial o la categórica. Es el caso del diagnóstico médico con hipótesis finitas.
Prior discreto y verosimilitud continua. Aparece en la comparación y selección de modelos. La pareja más importante es la uniforme sobre modelos con verosimilitud normal o Weibull, para calcular factores de Bayes. El caso spike-and-slab con normal es la base de la selección bayesiana de variables en regresión.
Prior continuo y verosimilitud discreta. Aquí están los pares conjugados más importantes de la epidemiología: beta-binomial para proporciones, Dirichlet-multinomial para categorías, gamma-Poisson para conteos y beta-geométrica para el tiempo hasta el primer evento.
Prior continuo y verosimilitud continua. Es el caso más general. Los pares conjugados más importantes son normal-normal, normal-inversa-gamma y gamma-exponencial para tasas. El resto (regresión con covariables, modelos mixtos, supervivencia) no tiene una forma analítica cerrada y requiere aproximaciones por MCMC.
4.10 Modelo beta-binomial
Cuando el parámetro de interés es una proporción \(\theta\), como la proporción de fumadores en una población, y los datos observados son el número de éxitos \(X\) en una serie de \(n\) ensayos independientes, como el número de personas fumadoras en una muestra, el modelo bayesiano más utilizado es el modelo beta-binomial:
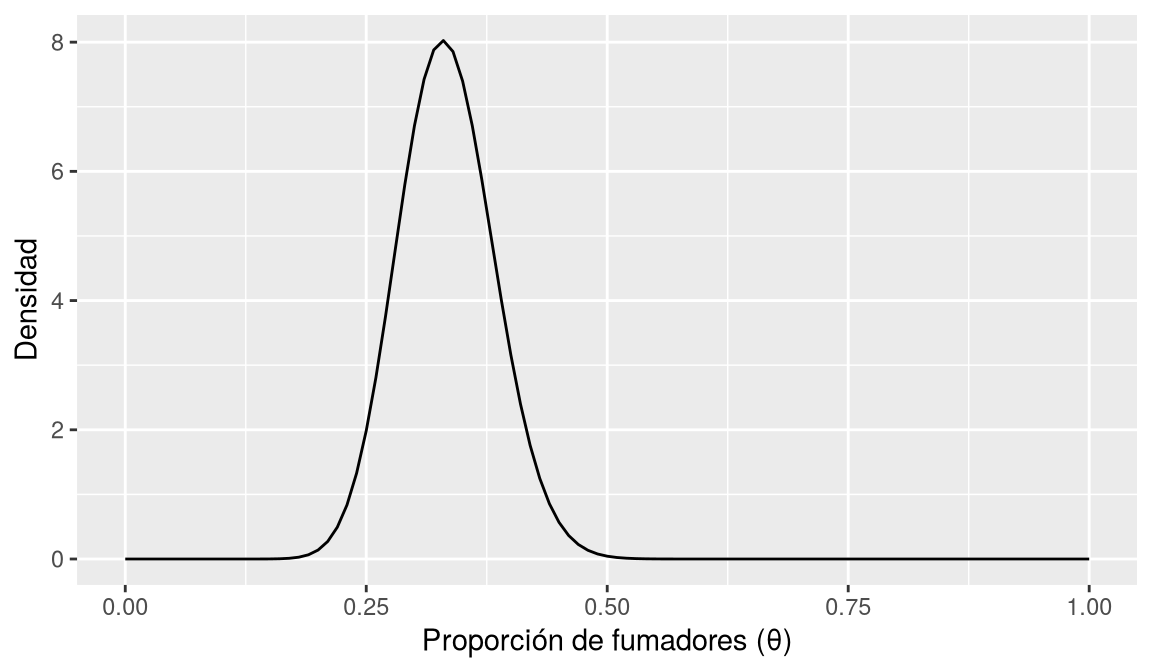
Ejercicio 4.4 Supongamos que queremos estimar la proporción de fumadores en nuestra ciudad. En varias muestras tomadas en ciudades similares, la proporción media estaba alrededor del 33 %, y la menor y la mayor proporción observadas fueron del 19 % y del 48 %, respectivamente.
¿Qué distribución beta podríamos utilizar para modelizar la distribución a priori?
Tip
Puedes usar la aplicación distribuciones para probar distintas distribuciones beta y encontrar la que mejor se ajuste a la información.
Solución
Una distribución \(\mbox{Beta}(30, 60)\) tiene media \(30/90 \approx 0{,}33\) y se concentra en el rango de proporciones observado.
library(bayesrules)plot_beta(alpha =30, beta =60) +labs(x ="Proporción de fumadores (θ)", y ="Densidad")
Figura 4.4: Distribución a priori \(\text{Beta}(30, 60)\) de la proporción de fumadores.
Ejercicio 4.5 Tras realizar un nuevo sondeo en nuestra ciudad, hemos observado que en una muestra de 100 personas, 20 son fumadoras.
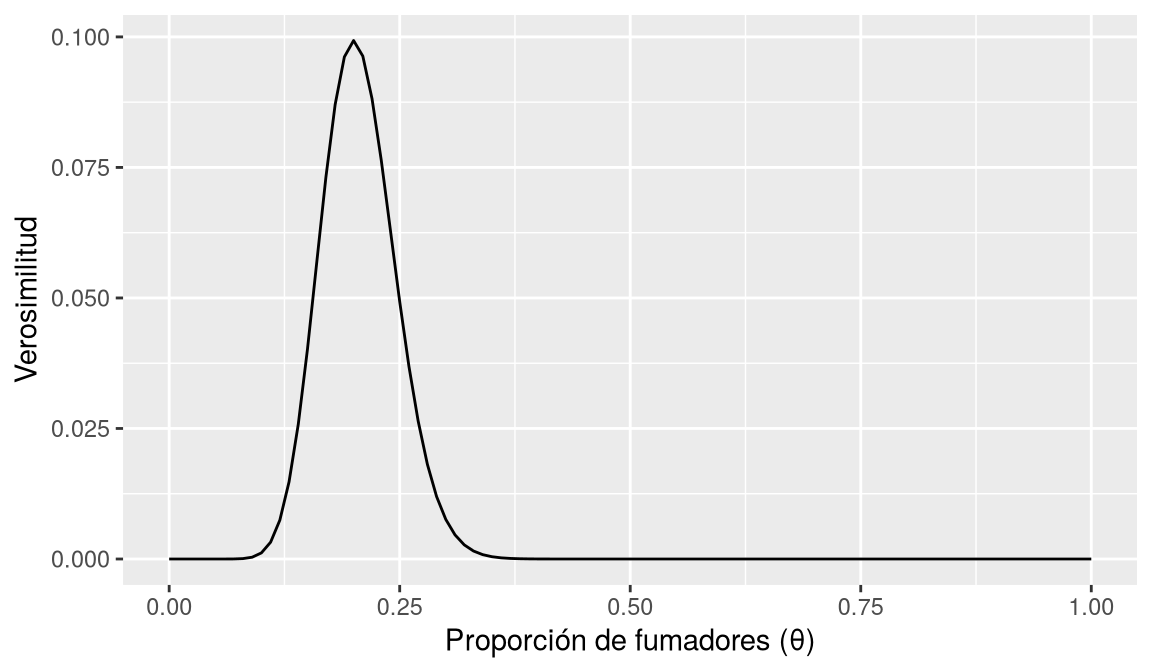
¿Cuál es la función de verosimilitud para la proporción de fumadores en la ciudad, \(\theta\)?
Solución
Llamemos \(Y\) al número de personas fumadoras en una muestra de tamaño \(n=100\). Suponiendo que la proporción de personas fumadoras en la ciudad es \(\theta\), \(Y\) sigue una distribución binomial con parámetros \(n=100\) y \(\theta\):
Sin embargo, la constante normalizadora \(P(Y=20)\) es difícil de calcular, porque requiere acumular las probabilidades \(f(\theta)L(\theta|Y=20)\) para cualquier \(\theta\). Como \(\theta\) es una variable continua, esta suma se convierte en la integral
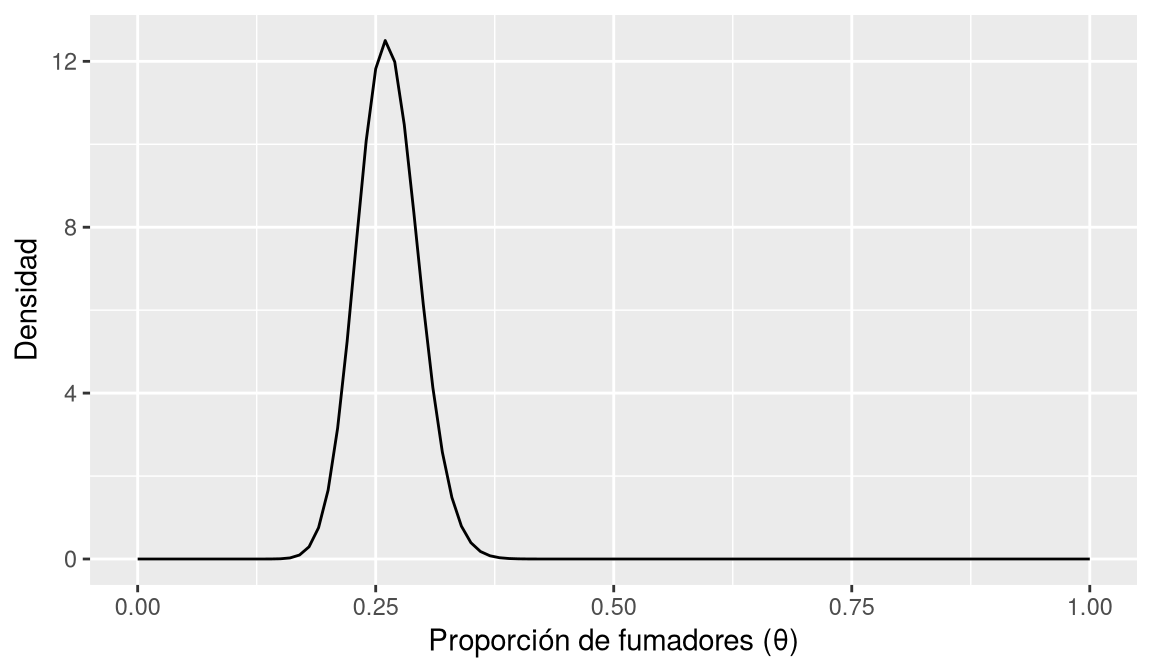
Afortunadamente, gracias a la conjugación beta-binomial, sabemos que la distribución a posteriori de \(\theta\) dado \(Y=20\) es también una distribución beta, con parámetros \(\alpha=30+20=50\) y \(\beta=60+100-20=140\), es decir, \(\theta|Y=20 \sim \mbox{Beta}(50, 140)\).
plot_beta(alpha =50, beta =140) +labs(x ="Proporción de fumadores (θ)", y ="Densidad")
Figura 4.6: Distribución a posteriori \(\text{Beta}(50, 140)\) de la proporción de fumadores dado \(Y=20\).
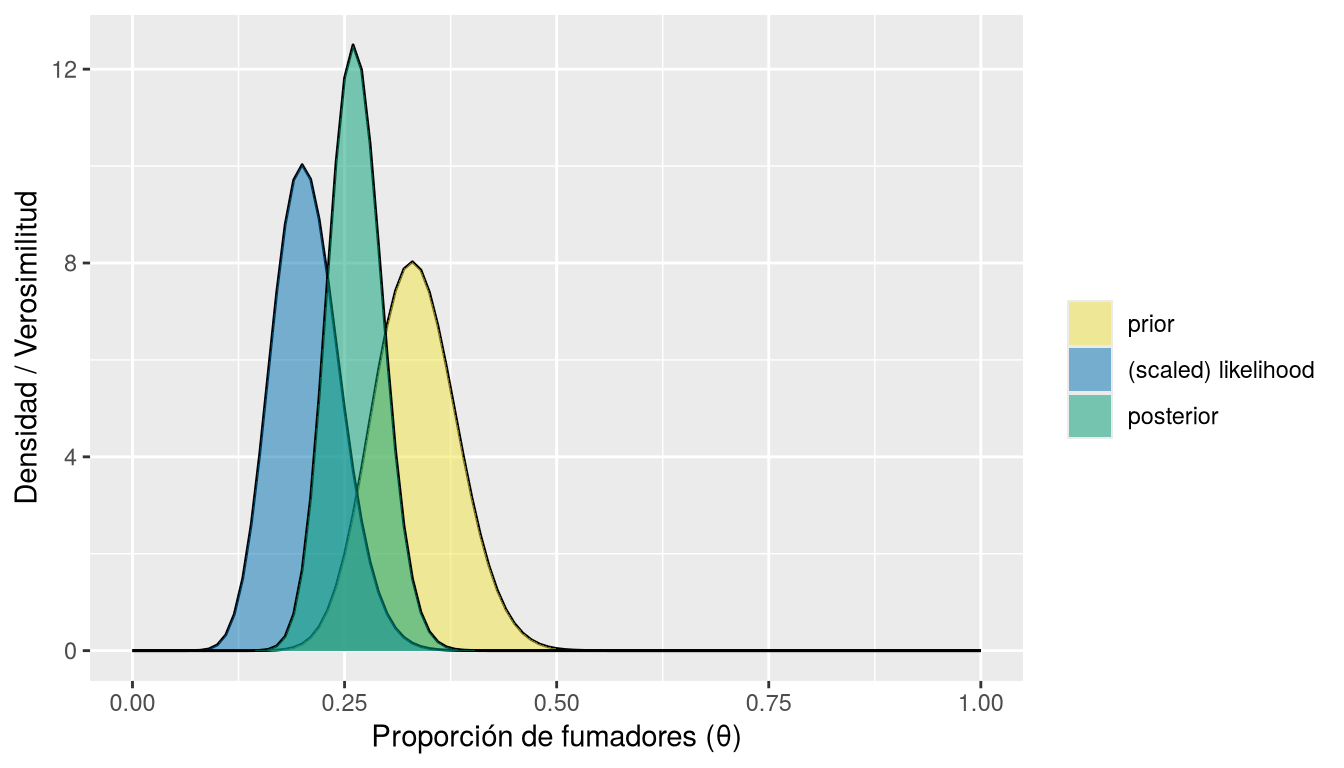
Podemos dibujar las tres distribuciones, a priori, verosimilitud y a posteriori, en la misma gráfica con la función plot_beta_binomial() del paquete bayesrules.
Notaplot_beta_binomial()
Dibuja la distribución beta a priori, la distribución binomial de la función de verosimilitud y la distribución beta a posteriori dado el número de éxitos observado en la muestra.
Parámetros:
alpha: parámetro \(\alpha\) de la distribución beta a priori.
beta: parámetro \(\beta\) de la distribución beta a priori.
y: número de éxitos observados en la muestra.
n: tamaño de la muestra.
plot_beta_binomial(alpha =30, beta =60, y =20, n =100) +labs(x ="Proporción de fumadores (θ)", y ="Densidad / Verosimilitud")
Figura 4.7: Distribución a priori, función de verosimilitud y distribución a posteriori del modelo beta-binomial.
4.11 Simulación de la distribución a posteriori
Cuando no es posible determinar analíticamente la distribución a posteriori, como ocurre con modelos bayesianos con distribuciones no conjugadas, puede simularse mediante técnicas de muestreo. Las técnicas más habituales, por orden de aparición, son:
Muestreo de rejilla (grid sampling).
Cadenas de Markov Monte Carlo (MCMC).
Monte Carlo Hamiltoniano (HMC).
4.11.1 Simulación mediante muestreo de rejilla
La técnica de muestreo de rejilla es la más sencilla y consiste en:
Definir una rejilla de valores posibles para la hipótesis o parámetro desconocido.
Calcular la función de verosimilitud para cada uno de estos valores.
Multiplicarla por la probabilidad a priori correspondiente a cada valor.
Normalizar el resultado para obtener una distribución a posteriori aproximada.
Ejemplo 4.9 Partiendo de la distribución a priori \(\theta \sim \mbox{Beta}(30, 60)\) y de la función de verosimilitud \(L(\theta|Y=20) = \binom{100}{20} \theta^{20} (1-\theta)^{80}\), el siguiente código simula la distribución a posteriori de \(\theta\) dado \(Y=20\) mediante muestreo de rejilla.
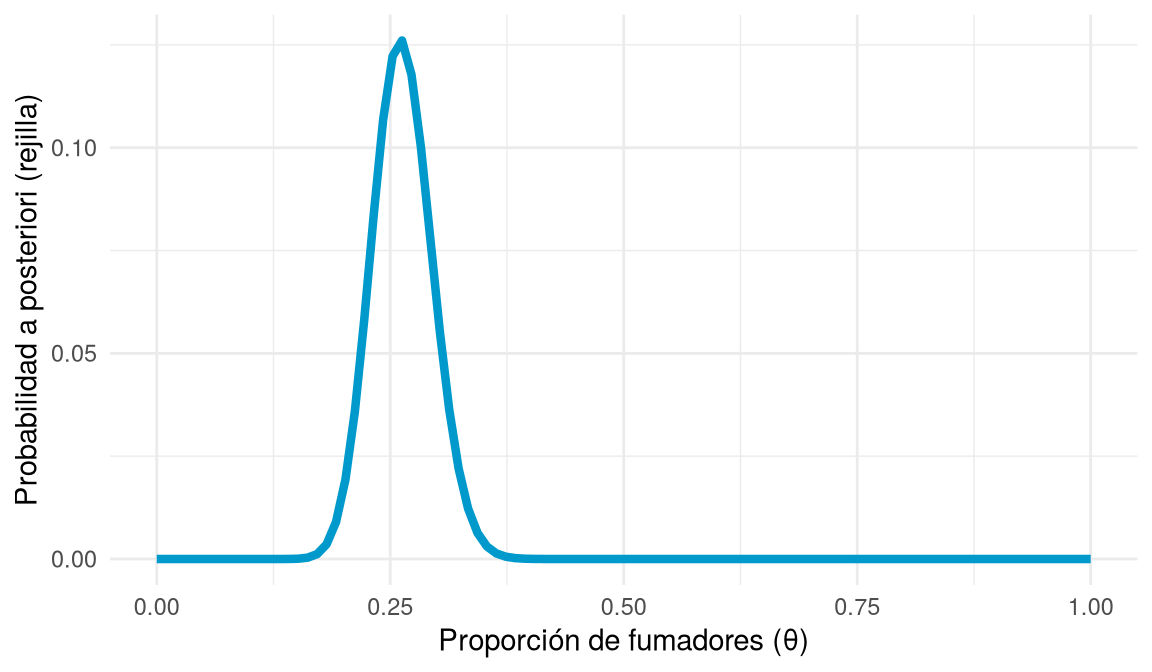
# Rejilla de 100 posibles valores de θ entre 0 y 1rejilla <-seq(0, 1, length.out =100)# Función de verosimilitud para cada valor de θverosimilitud <-dbinom(20, size =100, prob = rejilla)# Probabilidad a priori para cada valor de θprior <-dbeta(rejilla, shape1 =30, shape2 =60)# Plausibilidad a posteriori para cada valor de θposterior <- prior * verosimilitud# Normalizamos la plausibilidad a posteriori para obtener una distribución de probabilidaddf_posterior <-tibble(θ = rejilla, posterior = posterior /sum(posterior))# Gráfica de la distribución a posterioriggplot(df_posterior, aes(x = θ, y = posterior)) +geom_line(color = myblue, linewidth =1.5) +labs(x ="Proporción de fumadores (θ)", y ="Probabilidad a posteriori (rejilla)") +theme_minimal()
Figura 4.8: Distribución a posteriori de \(\theta\) dado \(Y=20\) obtenida por muestreo de rejilla.
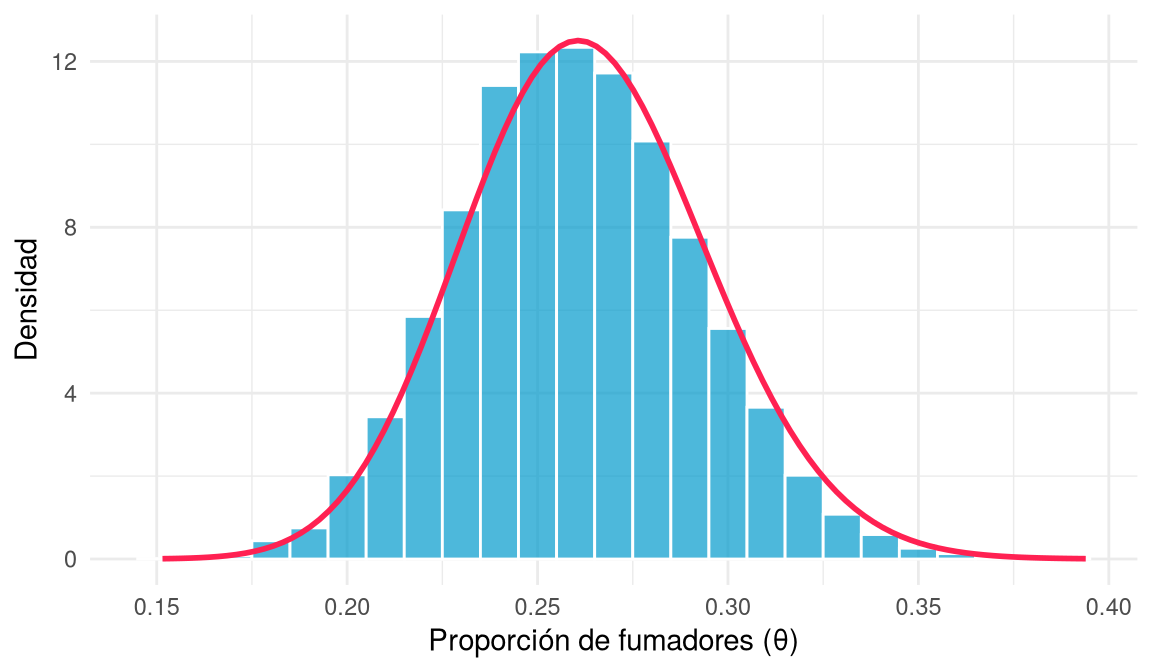
Para ver si la distribución simulada se parece a la distribución teórica \(\mbox{Beta}(50, 140)\), podemos extraer de ella una muestra aleatoria suficientemente grande y dibujar su histograma:
set.seed(123)# Muestra aleatoria de tamaño 10000muestra_posterior <-slice_sample(df_posterior, n =10000, weight_by = posterior, replace =TRUE)# Histograma de la muestra a posterioriggplot(muestra_posterior, aes(x = θ)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.01, alpha =0.7, fill = myblue, color ="white") +stat_function(fun = dbeta, args =list(50, 140), color = myred, linewidth =1) +labs(x ="Proporción de fumadores (θ)", y ="Densidad") +theme_minimal()
Figura 4.9: Histograma de una muestra de la distribución a posteriori simulada por rejilla, con la densidad teórica \(\text{Beta}(50, 140)\).
La distribución de frecuencias de la muestra simulada se ajusta bastante bien a la función de densidad de la distribución teórica \(\mbox{Beta}(50, 140)\).
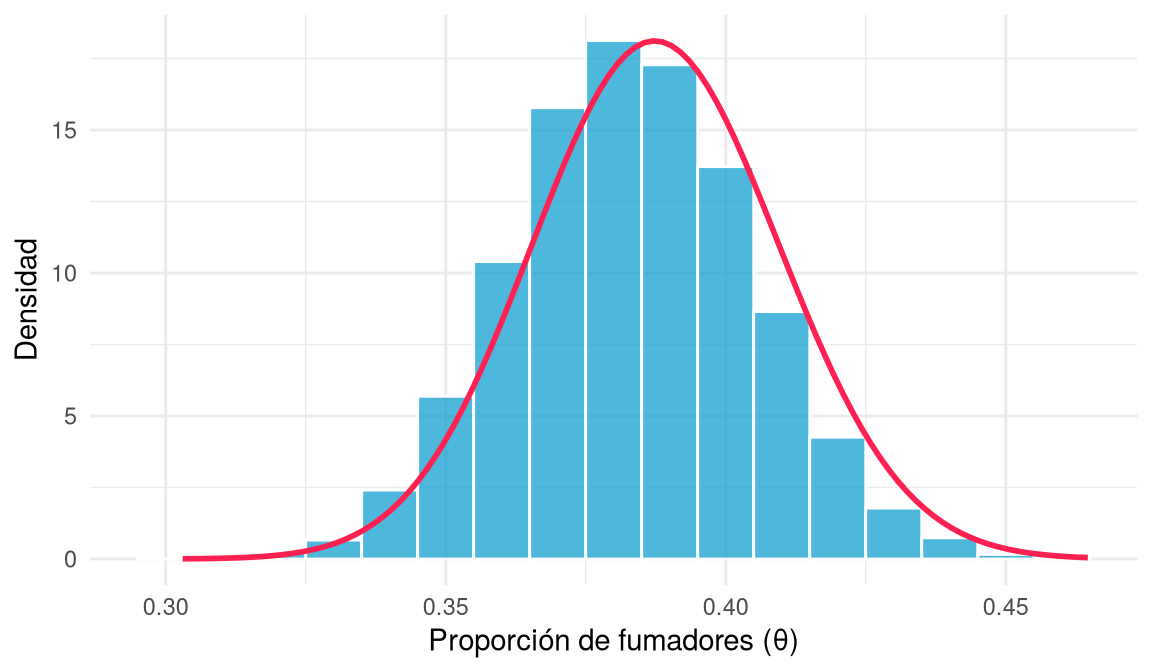
Ejercicio 4.6 Partiendo de la distribución a posteriori anterior, \(\theta\sim \mbox{Beta}(50, 140)\), simula la distribución a posteriori si se toma otra muestra de tamaño 300 en la que aparecen 140 personas fumadoras.
Solución
# Rejilla de 100 posibles valores de θ entre 0 y 1rejilla <-seq(0, 1, length.out =100)# Función de verosimilitud para cada valor de θ con la nueva muestraverosimilitud <-dbinom(140, size =300, prob = rejilla)# Probabilidad a priori para cada valor de θ (distribución a posteriori anterior)prior <-dbeta(rejilla, shape1 =50, shape2 =140)# Plausibilidad a posteriori para cada valor de θposterior <- prior * verosimilitud# Normalización de la plausibilidad a posterioridf_posterior <-tibble(θ = rejilla, posterior = posterior /sum(posterior))set.seed(123)# Muestra aleatoria de tamaño 10000muestra_posterior <-slice_sample(df_posterior, n =10000, weight_by = posterior, replace =TRUE)# Histograma de la muestra a posterioriggplot(muestra_posterior, aes(x = θ)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.01, alpha =0.7, fill = myblue, color ="white") +stat_function(fun = dbeta, args =list(50+140, 140+300-140), color = myred, linewidth =1) +labs(x ="Proporción de fumadores (θ)", y ="Densidad") +theme_minimal()
Figura 4.10: Distribución a posteriori tras la nueva muestra de 300 personas, con 140 fumadoras.
4.11.2 Modelo gamma-Poisson
Cuando el parámetro de interés es una tasa \(\lambda\), como la tasa de nacimientos diarios en una ciudad, y los datos observados son el número de eventos \(X\) en un intervalo de tiempo dado, como el número de nacimientos en un día, el modelo bayesiano más utilizado es el modelo gamma-Poisson:
Ejercicio 4.7 Supongamos que queremos estimar la tasa de infartos diarios por cada millón de habitantes. Sabemos que en varios países similares la tasa media de infartos es de 5 por cada 1000 habitantes al año, y que la menor y la mayor tasas observadas fueron de 2 y 10 por cada 1000 habitantes al año, respectivamente.
¿Qué distribución gamma podríamos utilizar para modelizar la distribución a priori?
Tip
Puedes usar la aplicación distribuciones para probar distintas distribuciones gamma y encontrar la que mejor se ajuste a la información.
Solución
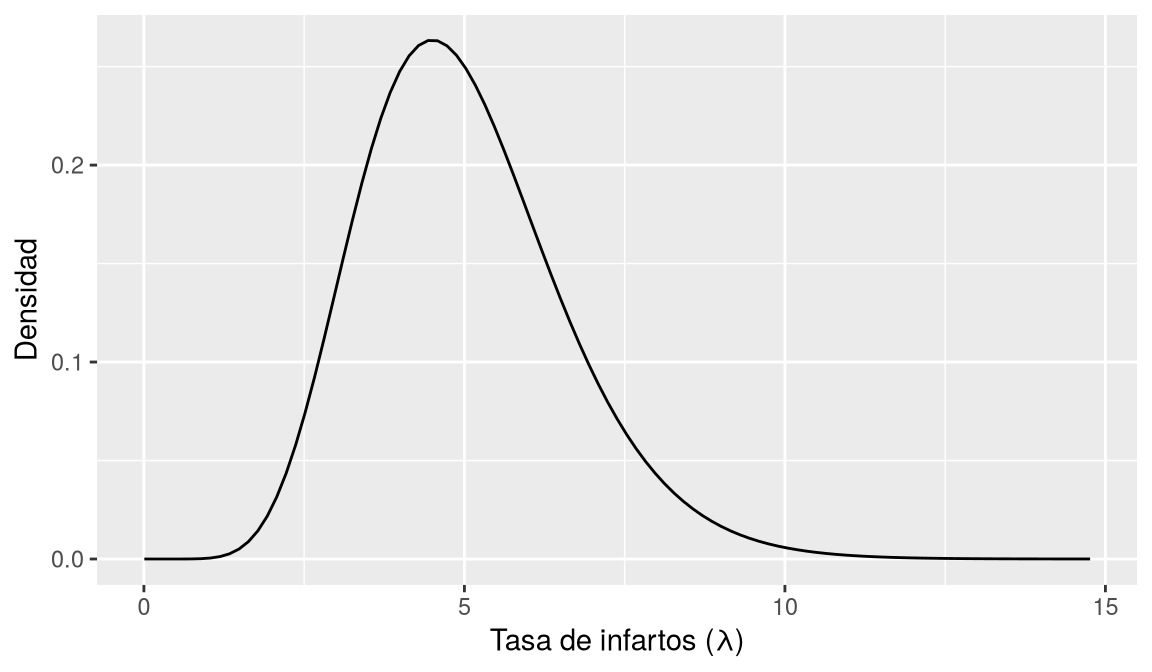
Una distribución \(\mbox{Gamma}(10, 2)\) tiene media \(10/2 = 5\) y un rango de valores compatible con la información disponible.
plot_gamma(shape =10, rate =2) +labs(x ="Tasa de infartos (λ)", y ="Densidad")
Figura 4.11: Distribución a priori \(\text{Gamma}(10, 2)\) de la tasa de infartos.
Ejercicio 4.8 Tras realizar un nuevo sondeo, hemos observado que en una muestra de 5 días se han producido \(X_1=10, X_2=8, X_3=9, X_4=11, X_5=7\) infartos.
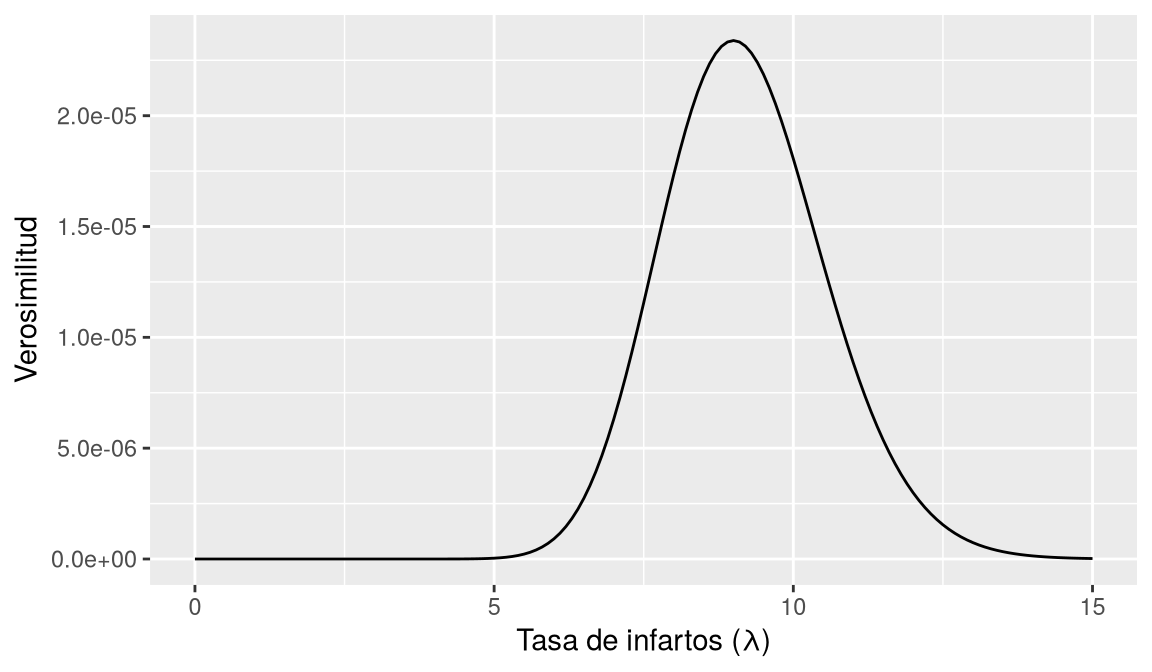
¿Cuál es la función de verosimilitud para la tasa de infartos \(\lambda\)?
Solución
Llamemos \(Y\) al número de infartos diarios. Suponiendo que la tasa de infartos diarios es \(\lambda\), el número de infartos de cada día sigue una distribución de Poisson de parámetro \(\lambda\), por lo que la función de verosimilitud para \(\lambda\) dados los cinco días observados es
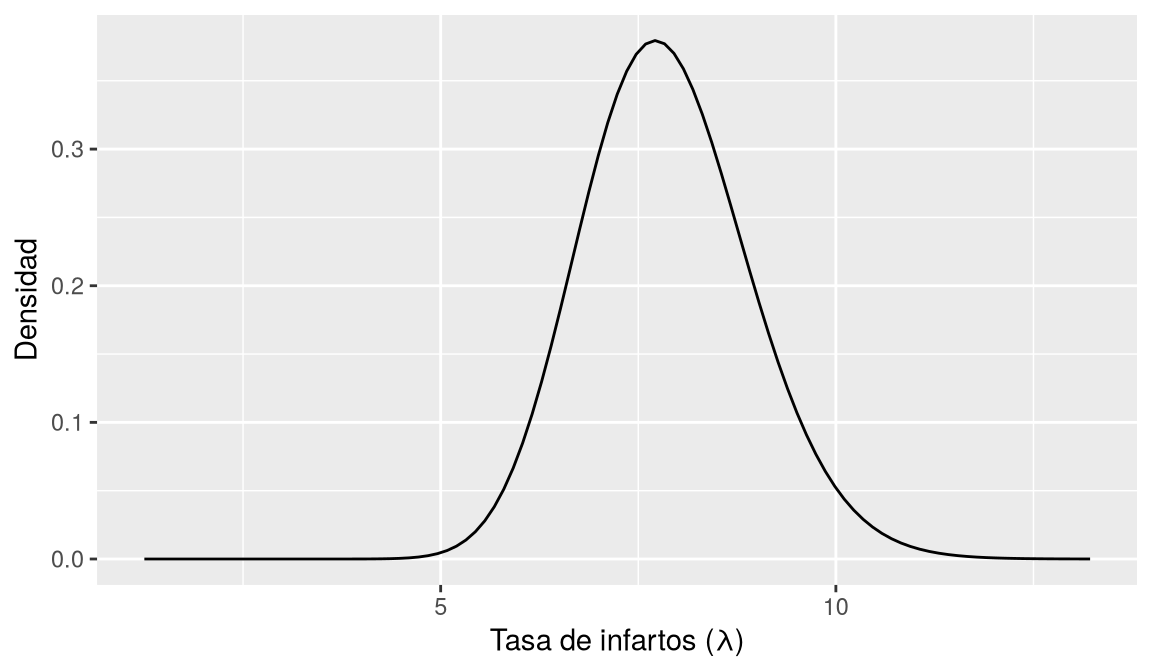
Pero, gracias a la conjugación gamma-Poisson, la distribución a posteriori de \(\lambda\) dada la muestra es también una distribución gamma con parámetros \(\alpha=10+45=55\) y \(\beta=2+5=7\), es decir, \(\lambda \sim \mbox{Gamma}(55, 7)\).
plot_gamma(shape =55, rate =7) +labs(x ="Tasa de infartos (λ)", y ="Densidad")
Figura 4.13: Distribución a posteriori \(\text{Gamma}(55, 7)\) de la tasa de infartos.
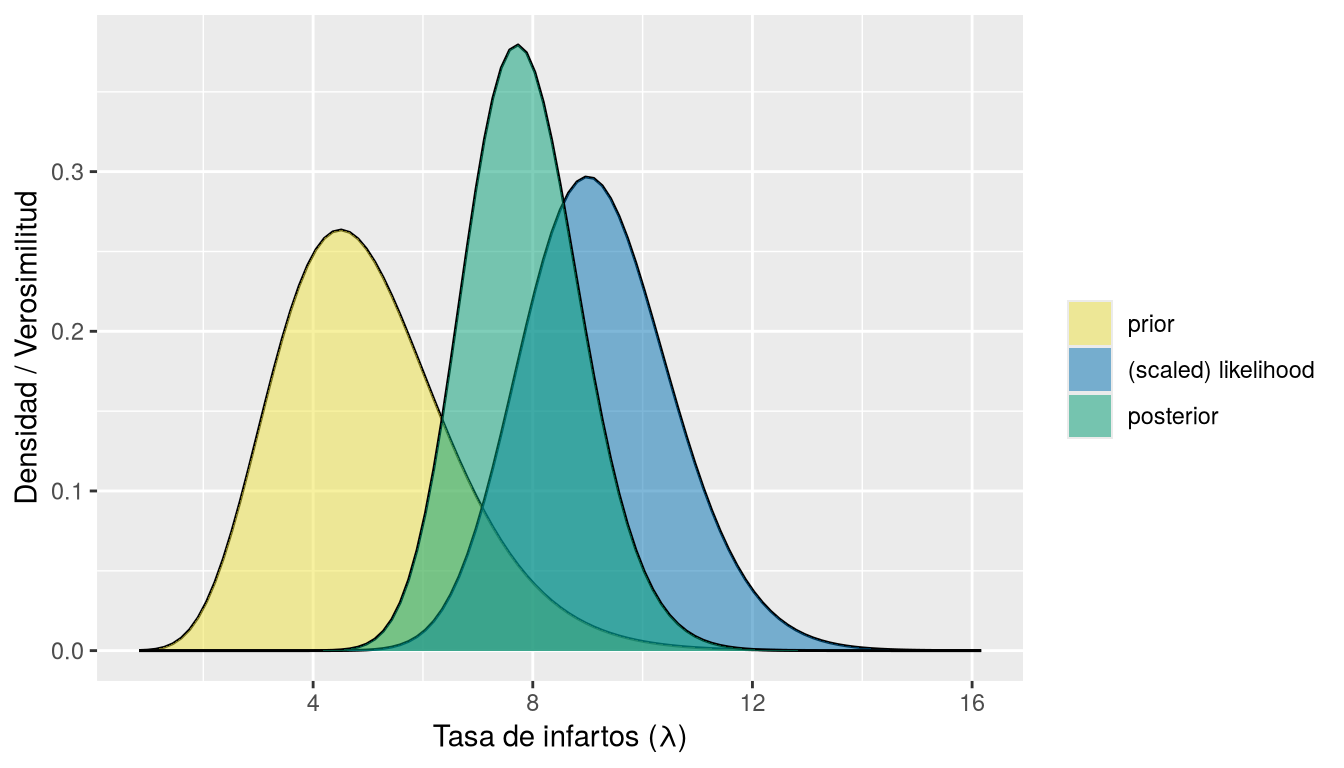
Podemos dibujar las tres distribuciones, a priori, verosimilitud y a posteriori, en la misma gráfica con la función plot_gamma_poisson() del paquete bayesrules.
Notaplot_gamma_poisson()
Dibuja la distribución gamma a priori, la distribución de Poisson de la función de verosimilitud y la distribución gamma a posteriori, dada una muestra de conteos.
Parámetros:
shape: parámetro \(\alpha\) de la distribución gamma a priori.
rate: parámetro \(\beta\) de la distribución gamma a priori.
sum_y: suma de los conteos observados en la muestra.
n: tamaño de la muestra.
plot_gamma_poisson(shape =10, rate =2, sum_y =45, n =5) +labs(x ="Tasa de infartos (λ)", y ="Densidad / Verosimilitud")
Figura 4.14: Distribución a priori, función de verosimilitud y distribución a posteriori del modelo gamma-Poisson.
4.11.2.1 Simulación de la distribución a posteriori mediante muestreo de rejilla
Ejemplo 4.10 Partiendo de la distribución a priori \(\lambda \sim \mbox{Gamma}(10, 2)\) y de la función de verosimilitud \(L(\lambda|Y=(10, 8, 9, 11, 7))\), el siguiente código simula la distribución a posteriori de \(\lambda\) mediante muestreo de rejilla.
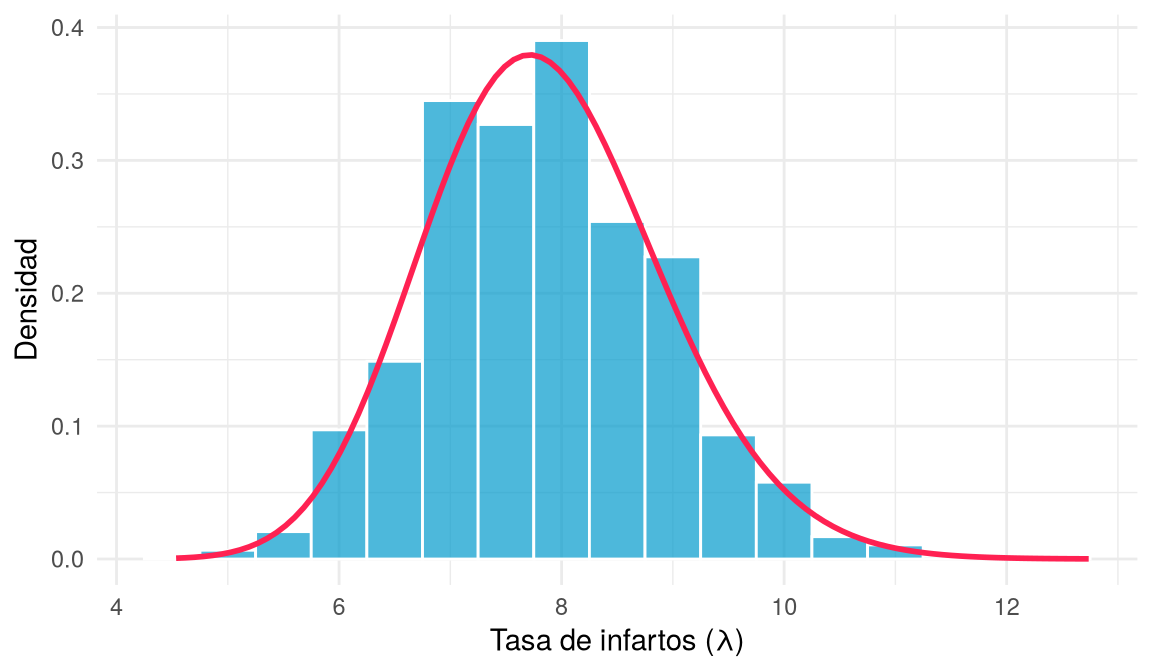
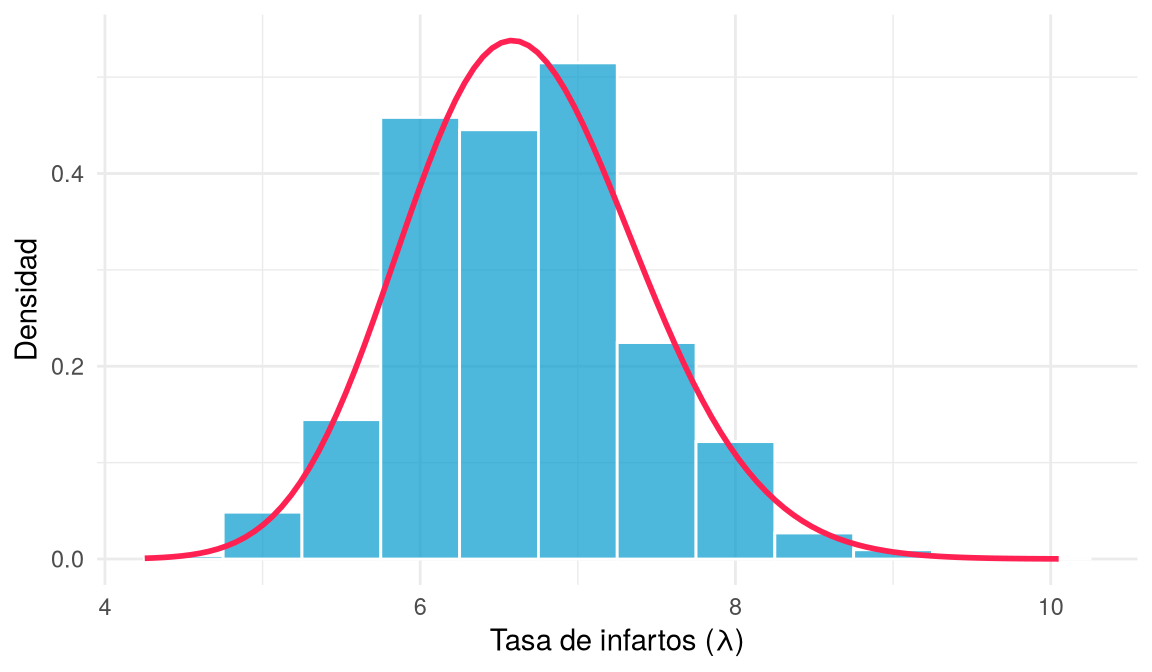
# Rejilla de 100 posibles valores de λ entre 1 y 15rejilla <-seq(1, 15, length.out =100)# Función de verosimilitud para cada valor de λverosimilitud <-sapply(rejilla, function(l) prod(dpois(c(10, 8, 9, 11, 7), lambda = l)))# Probabilidad a priori para cada valor de λprior <-dgamma(rejilla, shape =10, rate =2)# Plausibilidad a posteriori para cada valor de λposterior <- prior * verosimilitud# Normalizamos la plausibilidad a posteriori para obtener una distribución de probabilidaddf_posterior <-tibble(λ = rejilla, posterior = posterior /sum(posterior))set.seed(123)# Muestra aleatoria de tamaño 10000muestra_posterior <-slice_sample(df_posterior, n =10000, weight_by = posterior, replace =TRUE)# Histograma de la muestra a posterioriggplot(muestra_posterior, aes(x = λ)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.5, alpha =0.7, fill = myblue, color ="white") +stat_function(fun = dgamma, args =list(55, 7), color = myred, linewidth =1) +labs(x ="Tasa de infartos (λ)", y ="Densidad") +theme_minimal()
Figura 4.15: Histograma de una muestra de la distribución a posteriori de \(\lambda\) por rejilla, con la densidad teórica Gamma(55, 7).
Ejercicio 4.9 Partiendo de la distribución a posteriori anterior, \(\lambda\sim \mbox{Gamma}(55, 7)\), simula la distribución a posteriori si se toma otra muestra de tamaño 5 en la que se han producido \(X_1=5, X_2=7, X_3=4, X_4=6, X_5=3\) infartos.
Solución
# Rejilla de 100 posibles valores de λ entre 1 y 15rejilla <-seq(1, 15, length.out =100)# Función de verosimilitud para cada valor de λ con la nueva muestraverosimilitud <-sapply(rejilla, function(l) prod(dpois(c(5, 7, 4, 6, 3), lambda = l)))# Probabilidad a priori para cada valor de λ (distribución a posteriori anterior)prior <-dgamma(rejilla, shape =55, rate =7)# Plausibilidad a posteriori para cada valor de λposterior <- prior * verosimilitud# Normalización de la plausibilidad a posterioridf_posterior <-tibble(λ = rejilla, posterior = posterior /sum(posterior))set.seed(123)muestra_posterior <-slice_sample(df_posterior, n =10000, weight_by = posterior, replace =TRUE)# Histograma de la muestra a posterioriggplot(muestra_posterior, aes(x = λ)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.5, alpha =0.7, fill = myblue, color ="white") +stat_function(fun = dgamma, args =list(55+25, 7+5), color = myred, linewidth =1) +labs(x ="Tasa de infartos (λ)", y ="Densidad") +theme_minimal()
Figura 4.16: Distribución a posteriori de \(\lambda\) tras la nueva muestra de 5 días.
4.12 Independencia del orden de obtención de los datos
Una de las propiedades más importantes de la regla de Bayes es que el orden en el que se obtienen los datos no afecta a la distribución a posteriori final:
\[
f(\theta|Y_1, Y_2) = f(\theta|Y_2, Y_1).
\]
La demostración es sencilla. Si primero se observa \(Y_1\),
Cuando el parámetro de interés es una media \(\mu\), como el nivel medio de colesterol en sangre, y los datos \(X\) siguen una distribución normal con desviación típica conocida, el modelo bayesiano más utilizado es el modelo normal-normal:
Prior: \(\mu \sim N(\theta, \tau^2)\).
Verosimilitud: \(X|\mu \sim N(\mu, \sigma^2)\).
Ejercicio 4.10 Supongamos que queremos estimar el nivel medio de colesterol en sangre en una población. Sabemos que en poblaciones similares el nivel medio de colesterol está en un rango que va de 191 a 209 mg/dL.
¿Qué distribución normal podríamos utilizar para modelizar la distribución a priori?
Tip
Puedes usar la aplicación distribuciones para probar distintas distribuciones normales y encontrar la que mejor se ajuste a la información.
Solución
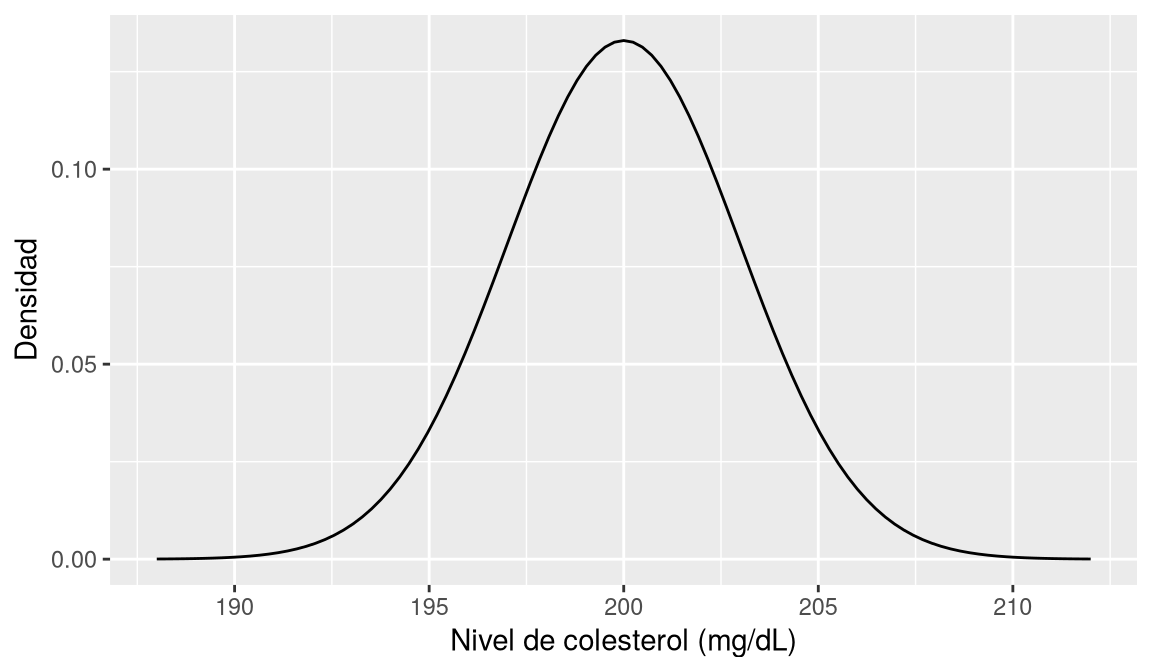
Una distribución \(N(200, 3^2)\) tiene media 200 y desviación típica 3, de modo que aproximadamente el 95 % de su masa cae entre 194 y 206 mg/dL, dentro del rango de la información disponible.
library(bayesrules)plot_normal(mean =200, sd =3) +labs(x ="Nivel de colesterol (mg/dL)", y ="Densidad")
Figura 4.17: Distribución a priori \(N(200, 3^2)\) del nivel medio de colesterol.
Ejercicio 4.11 Tras realizar un nuevo sondeo, hemos observado que en una muestra de 10 personas el nivel de colesterol en sangre es 230, 226, 245, 228, 232, 235, 232, 244, 251 y 247 mg/dL. Suponiendo que el nivel de colesterol sigue una distribución normal con desviación típica conocida de 40 mg/dL, algo razonable en una variable biológica continua, ¿cuál es la función de verosimilitud para el nivel medio de colesterol \(\mu\)?
Solución
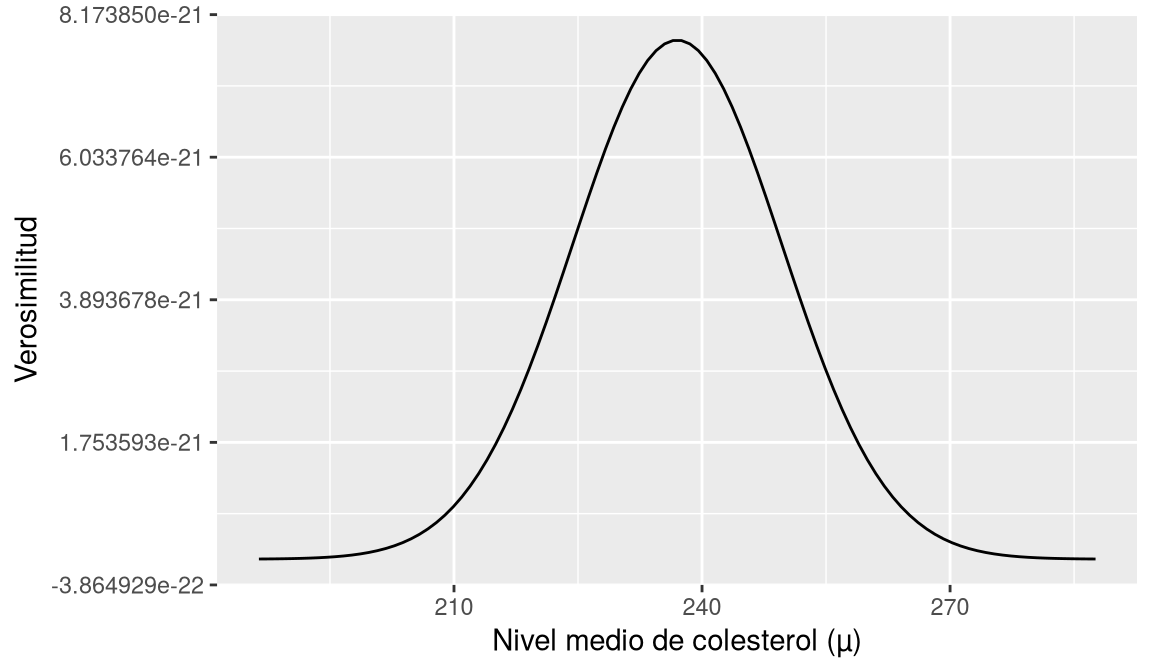
Llamemos \(Y\) al nivel de colesterol en sangre. Si \(Y\sim N(\mu, 40^2)\), la función de verosimilitud para \(\mu\) dados los valores observados \(y=(y_1,\ldots,y_n)\) es
muestra <-c(230, 226, 245, 228, 232, 235, 232, 244, 251, 247)plot_normal_likelihood(y = muestra, sigma =40) +labs(x ="Nivel medio de colesterol (μ)", y ="Verosimilitud")
Figura 4.18: Función de verosimilitud para el nivel medio de colesterol con la muestra de 10 personas.
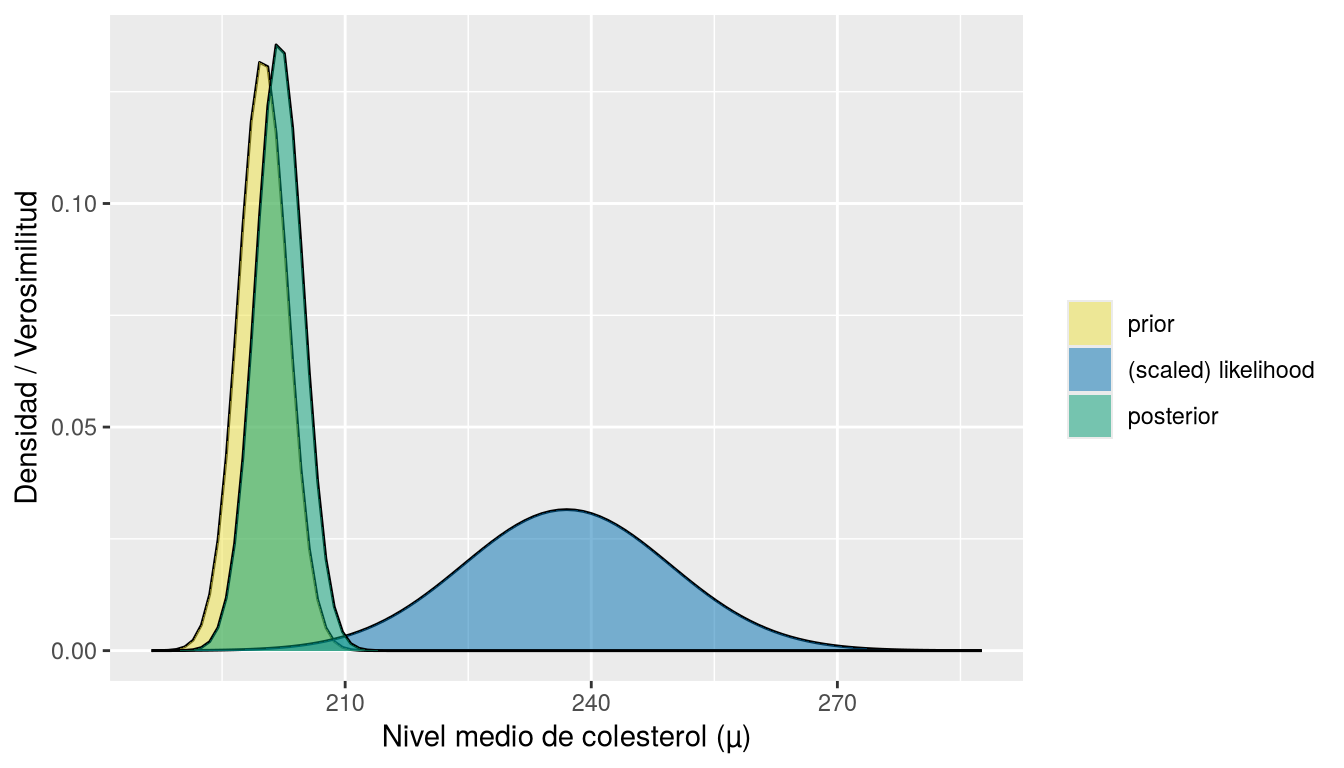
Una vez definidas la verosimilitud y la distribución a priori, la distribución a posteriori se obtiene con la regla de Bayes. La función plot_normal_normal() del paquete bayesrules dibuja las tres distribuciones en la misma gráfica:
Notaplot_normal_normal()
Dibuja la distribución normal a priori, la distribución normal de la función de verosimilitud y la distribución normal a posteriori, dada una muestra de datos.
Parámetros:
mean: media de la distribución normal a priori.
sd: desviación típica de la distribución normal a priori.
y_bar: media muestral.
n: tamaño de la muestra.
sigma: desviación típica conocida de la distribución normal de la función de verosimilitud.
media <-mean(c(230, 226, 245, 228, 232, 235, 232, 244, 251, 247))plot_normal_normal(mean =200, sd =3, y_bar = media, n =10, sigma =40) +labs(x ="Nivel medio de colesterol (μ)", y ="Densidad / Verosimilitud")
Figura 4.19: Distribución a priori, función de verosimilitud y distribución a posteriori del modelo normal-normal.
4.14 Explosión combinatoria del muestreo de rejilla
El muestreo de rejilla es sencillo, pero no es factible para modelos con muchos parámetros, porque el número de puntos de la rejilla crece exponencialmente con el número de parámetros. Con 100 puntos por parámetro:
Número de parámetros
Número total de puntos en la rejilla
1
100
2
10.000
3
1.000.000
4
100.000.000
5
10.000.000.000
Por esta razón, para modelos con muchos parámetros se utilizan técnicas de muestreo más eficientes, como MCMC o HMC.
4.15 Métodos de Monte Carlo
Los métodos de Monte Carlo generan muestras representativas de la distribución a posteriori con un coste computacional mucho menor que el muestreo de rejilla. Los dos tipos principales son:
Markov Chain Monte Carlo (MCMC). Es una familia de algoritmos que generan cadenas de Markov cuya distribución estacionaria es la distribución a posteriori deseada. Parten de un valor inicial de cada parámetro y, en cada iteración, proponen un nuevo valor aleatorio cercano al anterior, que se acepta o rechaza según una regla que garantiza que la cadena converja a la distribución a posteriori sin necesidad de conocer su constante de normalización. El algoritmo más conocido de esta familia es Metropolis-Hastings.
Hamiltonian Monte Carlo (HMC). Refina esta idea usando el gradiente de la log-posterior para proponer saltos grandes y coherentes con la geometría de la distribución, evitando el paseo aleatorio poco eficiente de algoritmos más simples. Es especialmente potente en modelos con muchos parámetros correlacionados.
4.16 El lenguaje Stan
Stan es un lenguaje de programación específico para el modelado y la inferencia bayesiana que implementa algoritmos de muestreo eficientes, como HMC.
Es un lenguaje declarativo que permite definir modelos bayesianos complejos de manera sencilla.
Compila los modelos a código C++ optimizado, por lo que genera muestras de distribuciones a posteriori multiparamétricas de forma rápida y eficiente.
Permite también analizar la convergencia y la calidad de las muestras generadas.
4.16.1 Estructura de un programa en Stan
Un programa en Stan se compone de varios bloques declarativos:
data: declara las variables observadas en los datos, sus dimensiones, tipos y rango posible de valores.
parameters: declara los parámetros del modelo que queremos estimar, sus dimensiones, tipos y rango posible de valores.
model: define la estructura del modelo bayesiano, especificando la distribución a priori de los parámetros y la función de verosimilitud de los datos dados los parámetros.
generated quantities: permite definir variables adicionales que se calculan a partir de los parámetros y los datos, como predicciones o medidas de ajuste del modelo.
Ejemplo 4.11 A continuación se muestra un programa en Stan para el modelo beta-binomial de la proporción de fumadores, con \(Y=20\) fumadoras en una muestra de 100 personas.
El paquete rstan es la interfaz de R para Stan. Permite compilar y ejecutar modelos escritos en Stan desde R, así como analizar los resultados. Los programas se escriben como una cadena de caracteres y se compilan y ejecutan con la función stan().
Notastan()
Compila un programa de Stan y simula el muestreo de la distribución a posteriori dados los datos.
model_code: cadena de caracteres con el código del programa de Stan.
data: lista con los datos que se pasan al programa.
chains: número de cadenas de Markov que se simulan.
iter: número de iteraciones de cada cadena.
seed: semilla para la generación de números aleatorios.
Ejemplo 4.12 El siguiente código define un modelo gamma-Poisson para la tasa de infartos diarios, con una distribución a priori \(\lambda \sim \mbox{Gamma}(10, 2)\) y una función de verosimilitud de Poisson. Lo compila y simula el muestreo de la distribución a posteriori.
library(rstan)# Código del programa de Stanmodelo <-"data { int<lower=0> n; // número de días int<lower=0> y[n]; // número de infartos diarios}parameters { real<lower=0> lambda; // tasa de infartos}model { y ~ poisson(lambda); // función de verosimilitud lambda ~ gamma(10, 2); // distribución a priori}"tasa_infartos_post <-stan(model_code = modelo,data =list(n =5, y =c(10, 8, 9, 11, 7)),chains =4, iter =5000*2, seed =123)
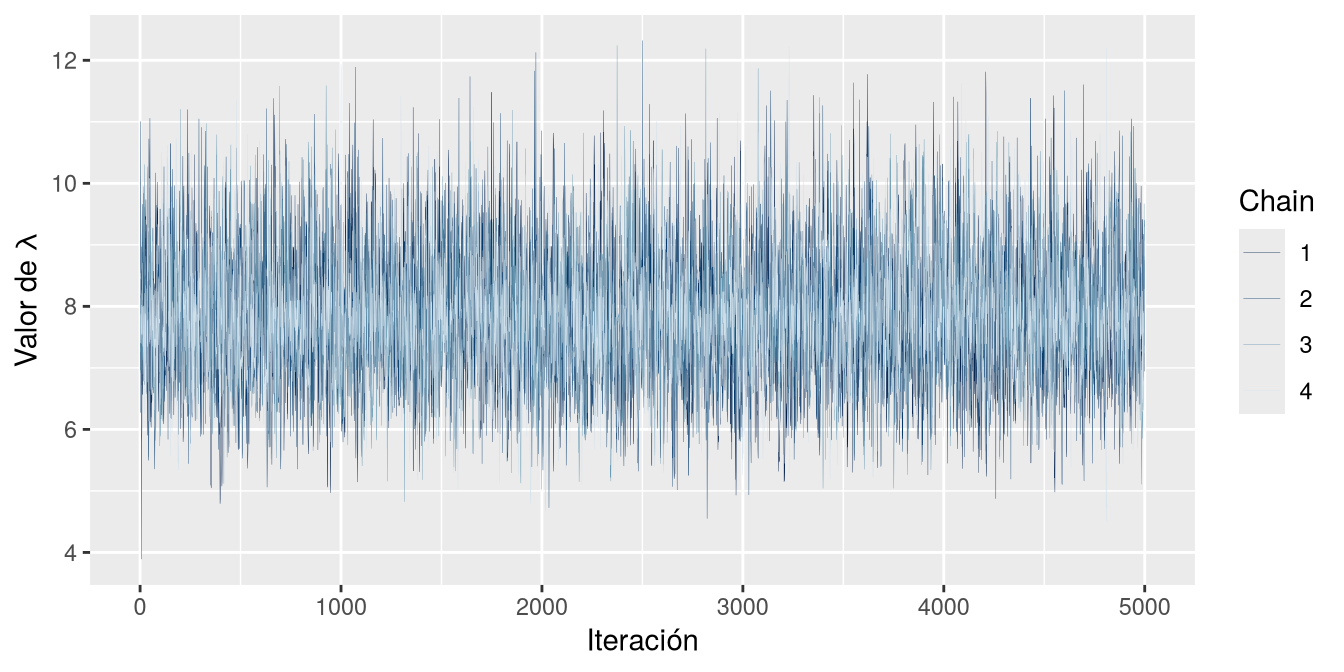
El resultado es una muestra de 4 cadenas de Markov de 5000 valores cada una, es decir, un total de 20.000 muestras de la distribución a posteriori de \(\lambda\) dado el número de infartos diarios observado.
Podemos visualizar las trazas de las cuatro cadenas con la función mcmc_trace del paquete bayesplot.
library(bayesplot)mcmc_trace(tasa_infartos_post, pars ="lambda", size =0.2) +labs(x ="Iteración", y ="Valor de λ") +theme_gray()
Figura 4.20: Trazas de las cuatro cadenas de Markov para \(\lambda\).
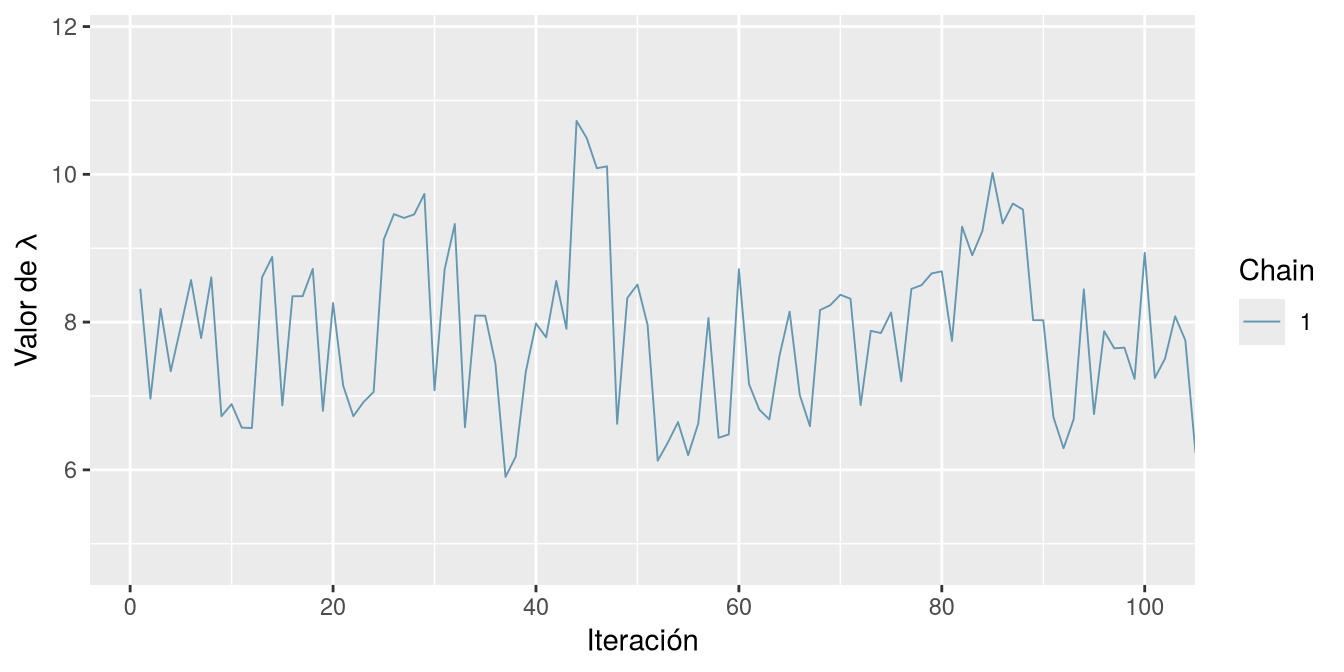
Si hacemos zoom sobre una de estas cadenas, podemos observar cómo recorre los distintos valores de la distribución a posteriori.
mcmc_trace(as.array(tasa_infartos_post)[, 1, , drop =FALSE], pars ="lambda", window =c(1, 100)) +labs(x ="Iteración", y ="Valor de λ") +theme_gray()
Figura 4.21: Zoom sobre las primeras 100 iteraciones de una de las cadenas de Markov para \(\lambda\).
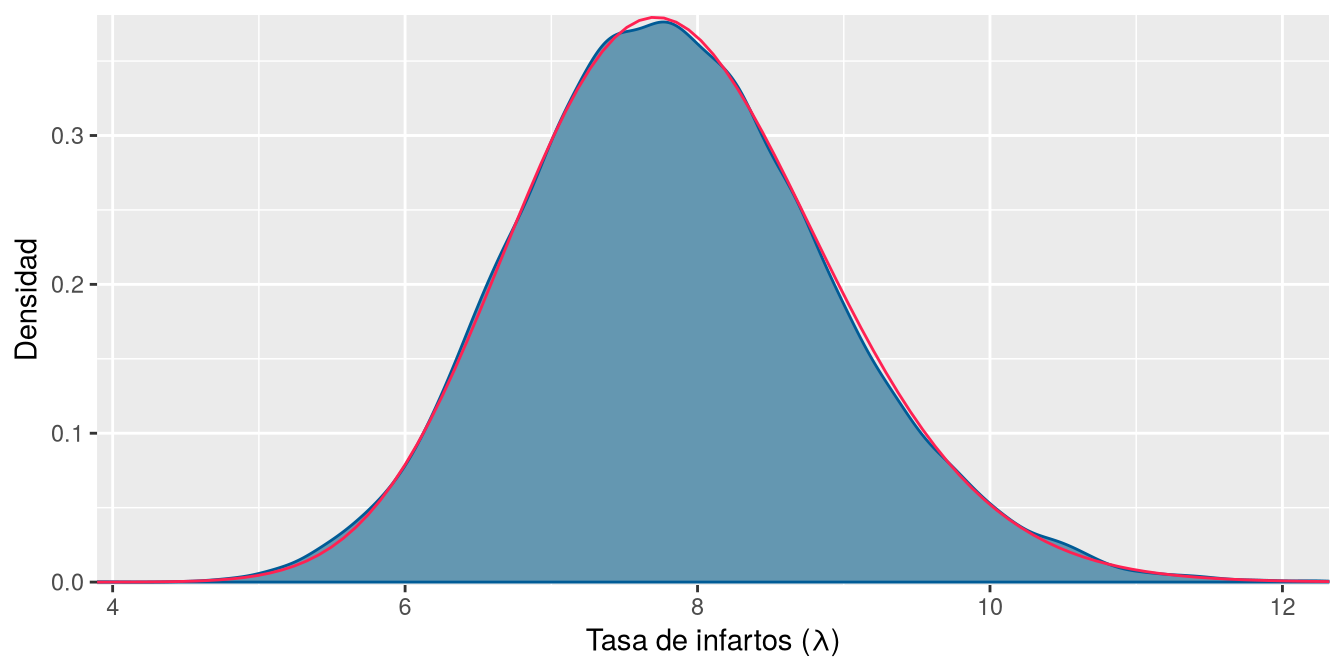
Podemos visualizar la distribución a posteriori de \(\lambda\) con la función mcmc_dens del paquete bayesplot, y compararla con la distribución teórica \(\mbox{Gamma}(55, 7)\):
mcmc_dens(tasa_infartos_post, pars ="lambda") +stat_function(fun = dgamma, args =list(55, 7), color = myred) +labs(x ="Tasa de infartos (λ)", y ="Densidad") +theme_gray()
Figura 4.22: Distribución a posteriori de \(\lambda\) simulada con Stan y densidad teórica \(\text{Gamma}(55, 7)\).
Ejercicio 4.12 Define en Stan un modelo normal-normal para el nivel medio de colesterol en sangre, con una distribución a priori \(N(200, 3^2)\) y una función de verosimilitud normal con desviación típica conocida de 40 mg/dL. Compílalo y simula el muestreo de la distribución a posteriori dada la muestra de 10 personas del ejercicio anterior.
Solución
# Código del programa de Stanmodelo <-"data { int<lower=0> n; // número de personas vector[n] y; // niveles de colesterol}parameters { real mu; // nivel medio de colesterol}model { y ~ normal(mu, 40); // función de verosimilitud mu ~ normal(200, 3); // distribución a priori}"colesterol_post <-stan(model_code = modelo,data =list(n =10, y =c(230, 226, 245, 228, 232, 235, 232, 244, 251, 247)),chains =4, iter =5000*2, seed =123)
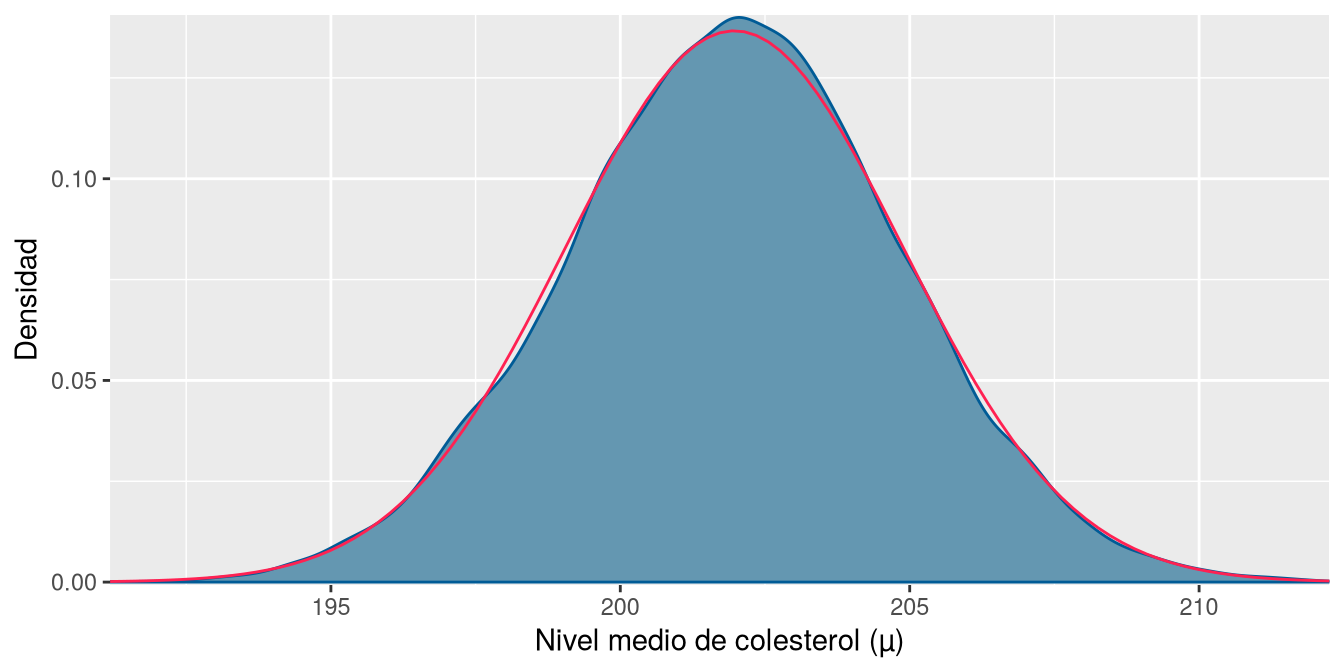
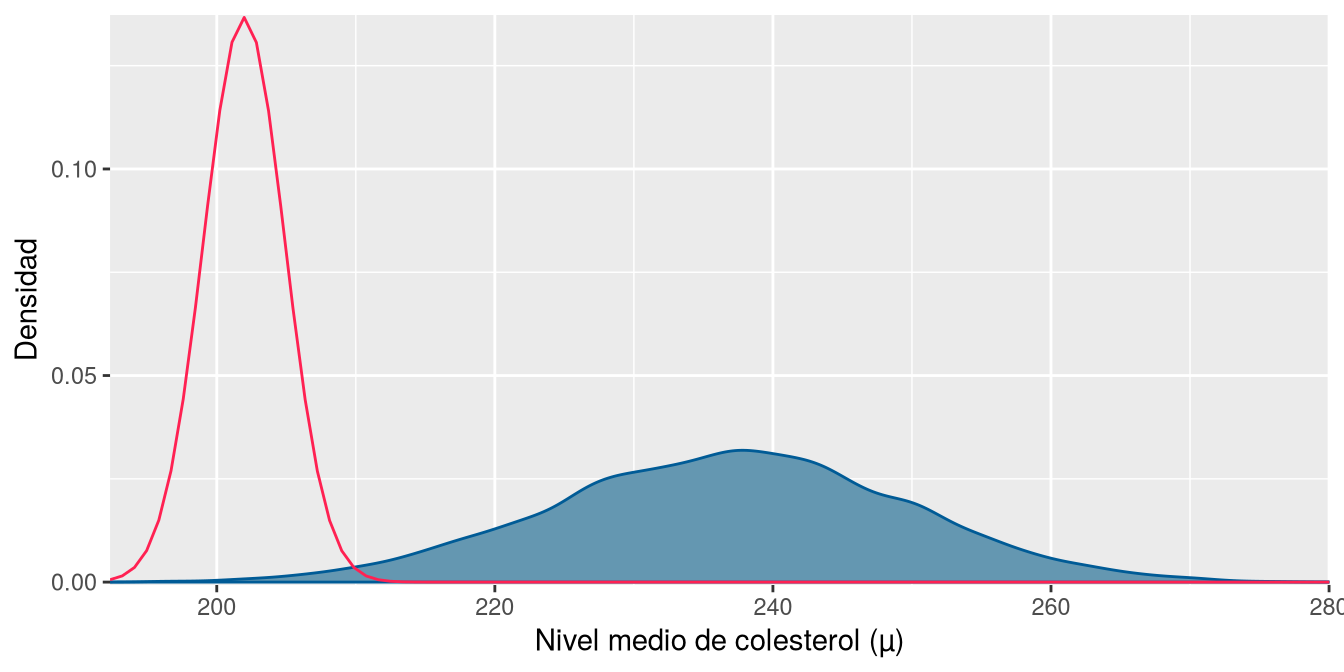
mcmc_dens(colesterol_post, pars ="mu") +stat_function(fun = dnorm, args =list(201.97, sqrt(8.52)), color = myred) +labs(x ="Nivel medio de colesterol (μ)", y ="Densidad") +theme_gray()
Figura 4.23: Distribución a posteriori de \(\mu\) simulada con Stan y densidad teórica normal de media 201,97 y varianza 8,52.
4.17 Análisis de las cadenas de Markov
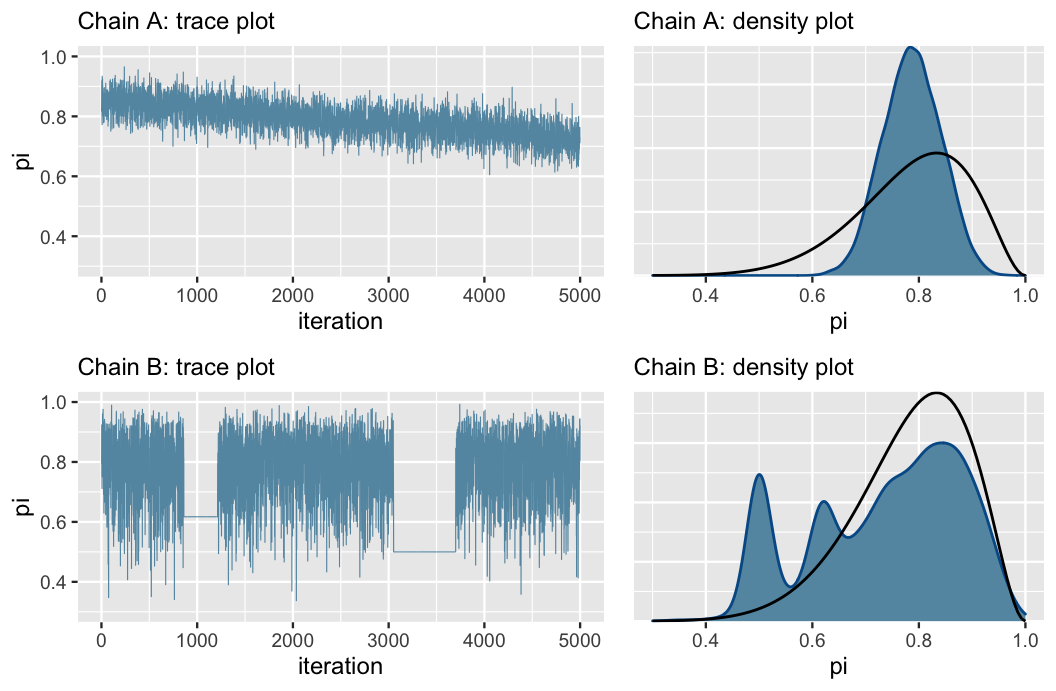
El principal problema de las muestras generadas con MCMC o HMC es que los valores de una cadena no son independientes: cada valor depende del anterior. Aunque el algoritmo busca que la muestra se ajuste a la distribución a posteriori, a veces puede fallar y generar muestras poco representativas.
Ejemplo de cadenas de Markov anómalas.
Para analizar la calidad de las muestras se utilizan, entre otras, las siguientes técnicas:
Análisis de la traza. Consiste en visualizar las trazas de las cadenas para detectar patrones anómalos, como cadenas que no convergen a la misma distribución, cadenas que no exploran toda la distribución a posteriori o cadenas atrapadas en un valor concreto.
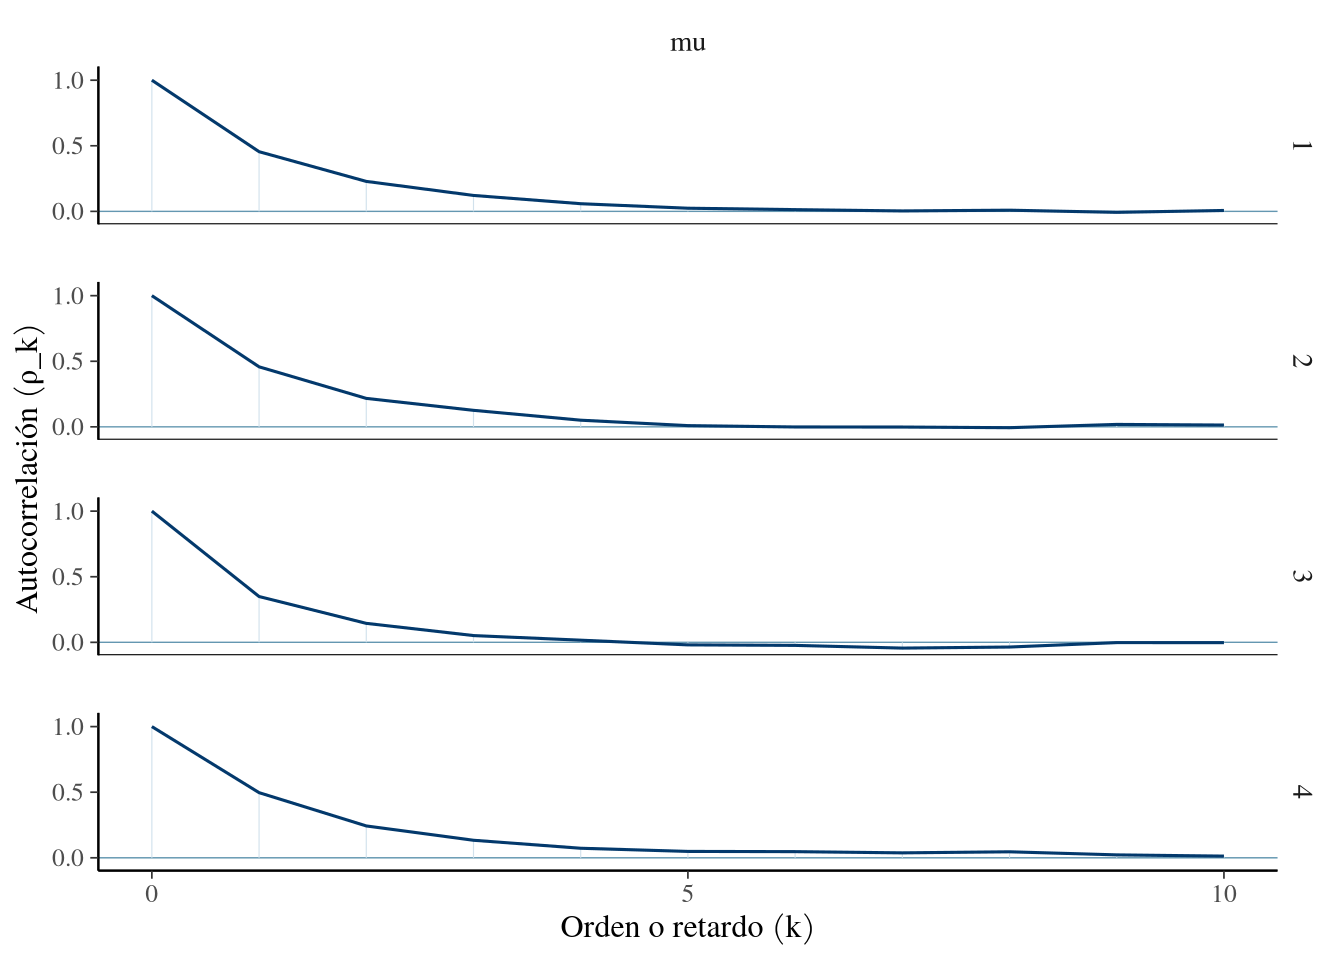
Análisis de la autocorrelación. Consiste en medir la dependencia entre valores separados por un número determinado de iteraciones.
Análisis de la eficiencia. Consiste en calcular el número efectivo de muestras independientes que equivalen a las muestras autocorrelacionadas generadas.
Análisis de la consistencia. Consiste en comparar la variabilidad entre cadenas con la variabilidad dentro de cada cadena.
4.17.1 Análisis de la traza
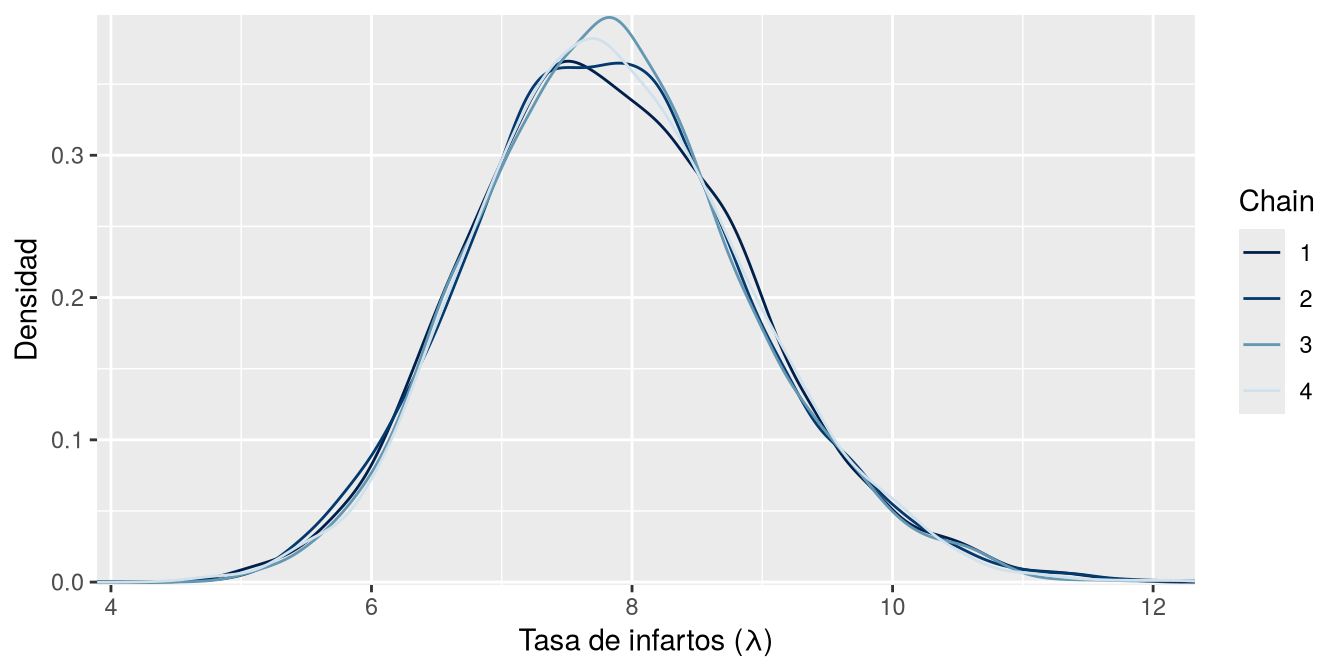
Para analizar la distribución de frecuencias de cada cadena de Markov podemos usar la función mcmc_dens_overlay del paquete bayesplot.
Notamcmc_dens_overlay()
Dibuja las distribuciones de frecuencias de cada cadena de Markov generada.
Parámetros:
fit: objeto de clase stanfit con el resultado del muestreo de la distribución a posteriori.
pars: vector de caracteres con los nombres de los parámetros que se analizan.
Ejemplo 4.13
mcmc_dens_overlay(tasa_infartos_post, pars ="lambda") +labs(x ="Tasa de infartos (λ)", y ="Densidad") +theme_gray()
Figura 4.24: Distribución de frecuencias de cada una de las cadenas de Markov para \(\lambda\).
4.17.2 Análisis de la autocorrelación
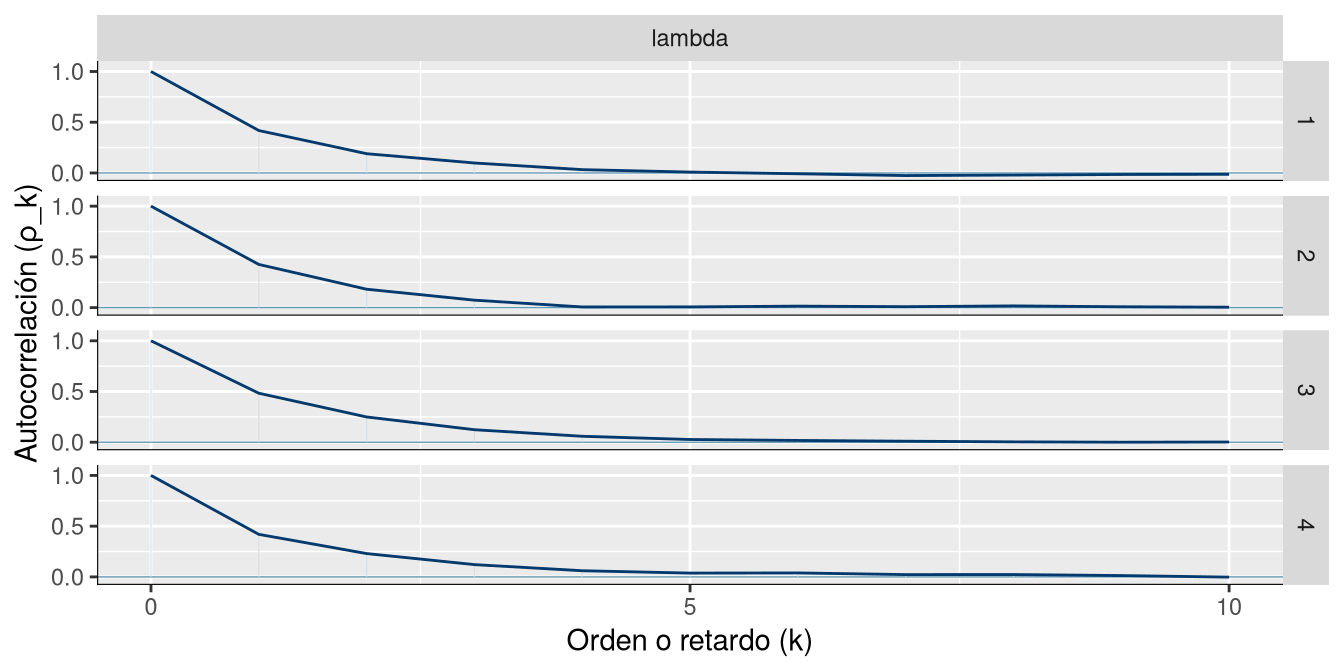
Cada valor de la cadena de Markov depende del anterior, lo que genera una cadena de dependencias \(\theta_1 \to \theta_2 \to \theta_3 \to \ldots \to \theta_n\). Es de esperar que la dependencia entre \(\theta_{i}\) y \(\theta_{i+k}\) disminuya a medida que \(k\) aumenta. Esta dependencia entre los valores de la cadena se conoce como autocorrelación.
Definición 4.3 (Autocorrelación de una cadena de Markov) Dada una cadena de Markov \(\theta_i\) con \(i=1, \ldots, n\), la autocorrelación de orden \(k\) se define como
donde \(\text{Cov}(\theta_i, \theta_{i+k})\) es la covarianza entre el valor \(\theta_i\) y el valor \(\theta_{i+k}\), y \(\text{Var}(\theta_i)\) es la varianza de los valores \(\theta_i\).
Para representar la autocorrelación de las muestras generadas podemos usar la función mcmc_acf del paquete bayesplot.
Notamcmc_acf()
Dibuja la función de autocorrelación de las muestras generadas por MCMC o HMC.
Parámetros:
fit: objeto de clase stanfit con el resultado del muestreo de la distribución a posteriori.
pars: vector de caracteres con los nombres de los parámetros que se analizan.
lags: número de retardos para calcular la autocorrelación.
Ejemplo 4.14
mcmc_acf(tasa_infartos_post, pars ="lambda", lags =10) +labs(x ="Orden o retardo (k)", y ="Autocorrelación (ρ_k)") +theme_gray()
Figura 4.25: Función de autocorrelación de las muestras de MCMC para \(\lambda\).
4.17.3 Análisis de la eficiencia
La eficiencia de una cadena de Markov se puede evaluar calculando el número efectivo de muestras independientes (ESS), es decir, el número de muestras independientes a las que equivale la cadena autocorrelada.
Podemos analizar la eficiencia de las muestras con la función neff_ratio del paquete bayesplot.
Notaneff_ratio()
Calcula la proporción entre el número efectivo de muestras independientes (ESS) y el número total de muestras generadas por MCMC o HMC.
Parámetros:
fit: objeto de clase stanfit con el resultado del muestreo de la distribución a posteriori.
pars: vector de caracteres con los nombres de los parámetros que se analizan.
Ejemplo 4.15
neff_ratio(tasa_infartos_post, pars ="lambda")
[1] 0.3731105
Cuanto más cercano a 1 sea este cociente, más eficiente es el muestreo.
4.17.4 Análisis de la consistencia
La consistencia de las muestras se puede evaluar comparando la variabilidad de los valores muestreados en todas las cadenas combinadas con la variabilidad dentro de cada cadena individual.
Definición 4.4 (Métrica \(\hat{R}\)) Dada una colección de cadenas de Markov generadas por un mismo proceso (MCMC o HMC), la métrica \(\hat{R}\) es la raíz cuadrada de la razón entre la variabilidad total de los valores muestreados en todas las cadenas combinadas y la variabilidad dentro de cada cadena individual:
Si la variabilidad entre cadenas es similar a la variabilidad dentro de cada cadena, \(\hat{R} \approx 1\), lo que indica que las cadenas han convergido a la misma distribución a posteriori y las muestras son consistentes.
Podemos calcular \(\hat{R}\) con la función rhat del paquete bayesplot.
Notarhat()
Calcula la métrica \(\hat{R}\) para evaluar la consistencia de las muestras generadas por MCMC o HMC.
Parámetros:
fit: objeto de clase stanfit con el resultado del muestreo de la distribución a posteriori.
pars: vector de caracteres con los nombres de los parámetros que se analizan.
Ejemplo 4.16
rhat(tasa_infartos_post, pars ="lambda")
[1] 1.000579
Si el valor es prácticamente 1, las cuatro cadenas de Markov generadas son consistentes entre sí.
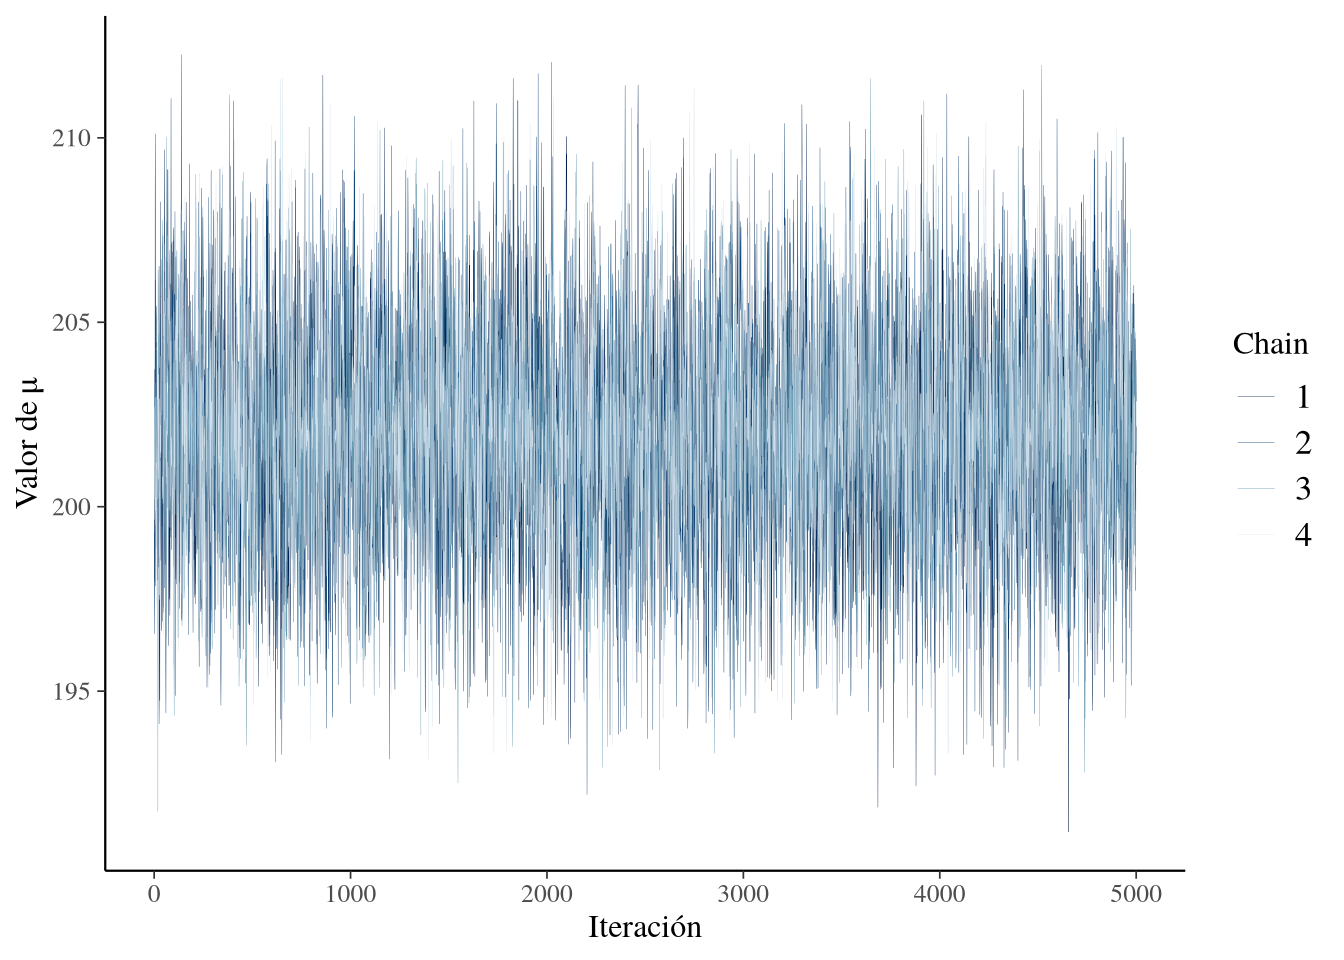
Ejercicio 4.13 Analiza la traza, la autocorrelación, la eficiencia y la consistencia de las cadenas de Markov generadas con Stan para la distribución a posteriori del nivel medio de colesterol en sangre del ejercicio anterior.
Solución
# Análisis de la trazamcmc_trace(colesterol_post, pars ="mu", size =0.2) +labs(x ="Iteración", y ="Valor de μ")
# Análisis de la autocorrelaciónmcmc_acf(colesterol_post, pars ="mu", lags =10) +labs(x ="Orden o retardo (k)", y ="Autocorrelación (ρ_k)")
# Eficiencianeff_ratio(colesterol_post, pars ="mu")
[1] 0.3672184
# Consistenciarhat(colesterol_post, pars ="mu")
[1] 1.000358
4.18 Dependencia de los resultados de la distribución a priori
Una de las críticas más comunes a la inferencia bayesiana es que los resultados pueden depender de la elección de la distribución a priori, lo que puede introducir un sesgo subjetivo en el análisis.
Los defensores de la estadística bayesiana argumentan que la elección de la distribución a priori debe basarse en el conocimiento previo disponible sobre el fenómeno estudiado, y no en una preferencia personal o arbitraria. En cualquier caso, es importante realizar un análisis de sensibilidad: evaluar cómo cambian los resultados a posteriori al cambiar la distribución a priori. Así se identifica si los resultados son robustos o si dependen en gran medida de la elección.
4.19 Distribuciones a priori poco informativas
Una forma de reducir la influencia de la distribución a priori es usar distribuciones poco informativas, que asignan una probabilidad similar a un amplio rango de valores del parámetro. Como ejemplo, consideremos la estimación del nivel medio de colesterol con una distribución a priori uniforme continua \(U(150, 300)\).
Ejemplo 4.17 Veamos cómo cambia la distribución a posteriori del nivel medio de colesterol con la muestra de 10 personas, usando una distribución a priori uniforme continua.
# Código del programa de Stanmodelo <-"data { int<lower=0> n; // número de personas vector[n] y; // niveles de colesterol}parameters { real<lower=150, upper=300> mu; // nivel medio de colesterol}model { y ~ normal(mu, 40); // función de verosimilitud mu ~ uniform(150, 300); // distribución a priori}"posterior_sim <-stan(model_code = modelo,data =list(n =10, y =c(230, 226, 245, 228, 232, 235, 232, 244, 251, 247)),chains =4, iter =5000*2, seed =123)
mcmc_dens(posterior_sim, pars ="mu") +stat_function(fun = dnorm, args =list(201.97, sqrt(8.52)), color = myred) +labs(x ="Nivel medio de colesterol (μ)", y ="Densidad") +theme_gray()
Figura 4.26: Distribución a posteriori de \(\mu\) con prior uniforme \(U(150, 300)\) y 10 observaciones.
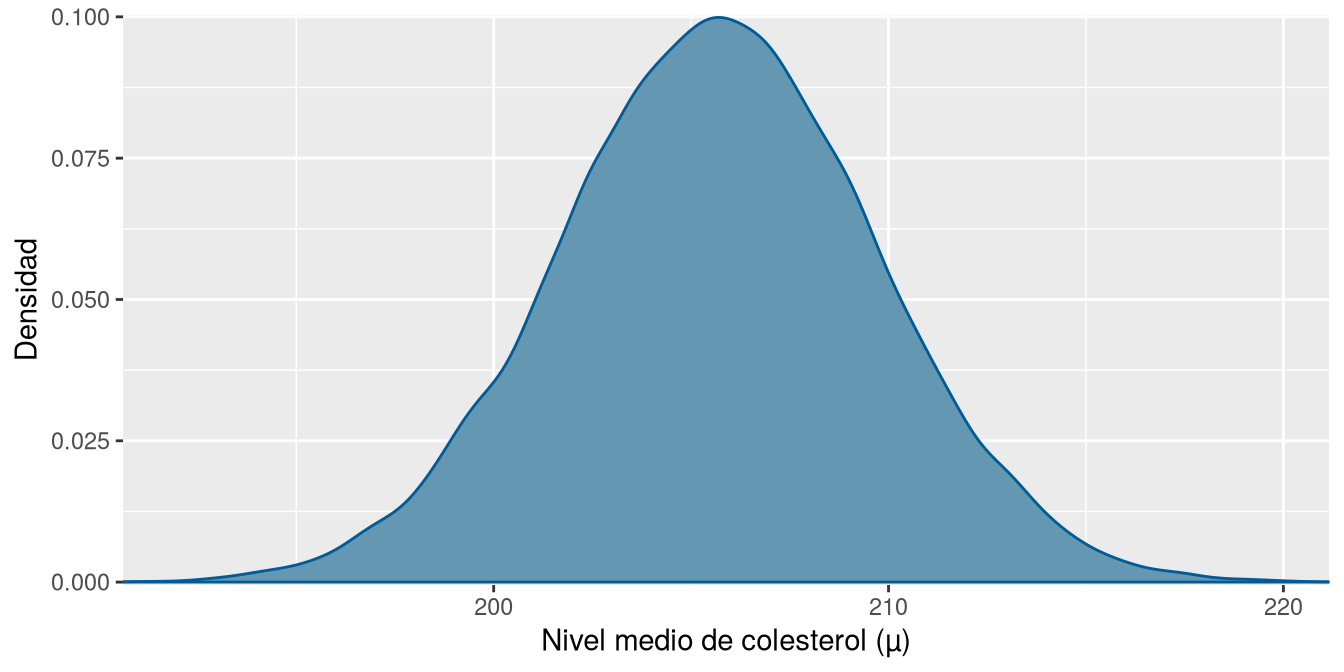
Con una muestra más grande, de 100 personas, simulada a partir de la misma distribución, la distribución a posteriori es prácticamente la misma con cualquier prior razonable:
set.seed(123)posterior_sim <-stan(model_code = modelo,data =list(n =10^2, y =rnorm(10^2, mean =202, sd =40)),chains =4, iter =5000*2, seed =123)
mcmc_dens(posterior_sim, pars ="mu") +labs(x ="Nivel medio de colesterol (μ)", y ="Densidad") +theme_gray()
Figura 4.27: Distribución a posteriori de \(\mu\) con prior uniforme \(U(150, 300)\) y 100 observaciones.
Para muestras pequeñas puede haber bastante discrepancia entre las distribuciones a posteriori generadas con distintas distribuciones a priori, pero esa diferencia se disipa a medida que tenemos más datos.
4.20 Tipos de distribuciones a priori
Cuando la muestra es pequeña, la elección de la distribución a priori es determinante. Según el grado de información que incorporan, se distinguen tres tipos:
No informativas. Asignan la misma plausibilidad a todos los valores del parámetro, incluso a valores que no tienen sentido.
Poco informativas. Asignan una probabilidad similar a un amplio rango de valores del parámetro, pero descartan los valores que no tienen sentido.
Informativas. Reflejan un conocimiento previo sólido sobre el parámetro, lo que puede mejorar la precisión de las estimaciones cuando hay poca información en los datos.
4.20.1 Distribuciones a priori no informativas
Una distribución a priori no informativa asigna la misma plausibilidad a todo el rango de valores del parámetro. El caso más extremo es el modelo uniforme impropio \(f(\theta) \propto 1\), que no es una distribución de probabilidad porque no integra 1, pero que produce distribuciones a posteriori adecuadas cuando hay datos suficientes.
¿Cuándo usarla? Cuando no tenemos información previa y los datos son abundantes.
¿Cuándo no usarla? No debería usarse con muestras pequeñas, porque la posterior puede ser inestable o producir estimaciones absurdas.
Ejemplo 4.18 Para estimar la tensión arterial sistólica media de una población se utiliza un modelo uniforme \(f(\mu) \propto 1\), que asigna la misma plausibilidad a cualquier valor de \(\mu>0\).
4.20.2 Distribuciones a priori poco informativas
Una distribución a priori poco informativa asigna una probabilidad similar a un amplio rango de valores del parámetro, pero descarta los valores que no tienen sentido. Suele utilizarse una distribución uniforme continua con el rango restringido a los valores plausibles, o una distribución normal con desviación típica grande para reflejar la incertidumbre sobre el parámetro.
¿Cuándo usarla? Cuando no tenemos información previa pero queremos evitar que la posterior sea inestable con muestras pequeñas. Es la opción más habitual cuando no hay información sólida sobre la incertidumbre del parámetro.
¿Cuándo no usarla? No debería usarse cuando tenemos información previa sólida, porque no aprovecha esa información para mejorar la precisión de las estimaciones, especialmente con pocos datos.
Ejemplo 4.19 Para estimar la tensión arterial sistólica media de una población se utiliza un modelo uniforme \(\mu \sim U(70, 200)\), que asigna la misma plausibilidad a cualquier valor de \(\mu\) entre 70 y 200 mmHg, y descarta los valores menores de 70 o mayores de 200 mmHg, que no tienen sentido en este contexto.
4.20.3 Distribuciones a priori informativas
Una distribución a priori informativa refleja un conocimiento previo sólido sobre el parámetro de interés (resultados de estudios anteriores, valores de referencia clínica u opinión de expertos). Puede mejorar la precisión de las estimaciones cuando hay poca información en los datos. Suelen elegirse distribuciones conjugadas con la distribución de los datos.
¿Cuándo usarla? Cuando existe evidencia previa sólida (metaanálisis, registros históricos, valores fisiológicos bien establecidos). Siempre debe documentarse y justificarse.
¿Cuándo no usarla? No debería usarse cuando no existe información previa sólida, porque puede introducir un sesgo subjetivo y producir estimaciones poco fiables, especialmente con pocos datos.
Ejemplo 4.20 Para estimar la tensión arterial sistólica media de una población se utiliza un modelo normal \(\mu \sim N(120, 15^2)\), que refleja el conocimiento previo sobre la tensión arterial sistólica media en poblaciones similares, con una media de 120 mmHg y una desviación típica de 15 mmHg para reflejar la incertidumbre sobre ese valor.
4.21 Distribuciones a priori recomendadas
Situación
Prior recomendado
Media poblacional
normal(valor_referencia, incertidumbre)
Desviación típica
half_t(3, 0, 1) o exponential(1)
Proporción sin información previa
beta(1, 1) o beta(0.5, 0.5)
Proporción con información previa
beta() calibrada con la media y la varianza esperadas
Coeficientes de regresión (datos estandarizados)
normal(0, 1)
Coeficientes de regresión (datos sin estandarizar)