# Data frame número de hijos
df <- tibble(
  hijos = rep(c(0,1,2,3,4),
              c(2,6,14,2,1))
)
# Tabla de frecuencias
df |>
  tabyl(hijos) |>
kable()| hijos | n | percent |
|---|---|---|
| 0 | 2 | 0.08 |
| 1 | 6 | 0.24 |
| 2 | 14 | 0.56 |
| 3 | 2 | 0.08 |
| 4 | 1 | 0.04 |
La estadística bayesiana se apoya en el cálculo de probabilidades. Este capítulo repasa los conceptos básicos que necesitaremos: frecuencias muestrales, distribuciones de frecuencias, sucesos aleatorios, las distintas definiciones de probabilidad, la probabilidad condicionada y las variables aleatorias con sus distribuciones más importantes.
Definición 2.1 (Frecuencias muestrales) Dada una muestra de tamaño \(n\) de una variable \(X\), para cada valor \(x_i\) de la variable observado en la muestra se define
\[f_i = \frac{n_i}{n}\]
Ejemplo 2.1 Si tomamos una muestra aleatoria de 10 personas en la que hay 6 mujeres, la frecuencia absoluta de mujeres es \(n_i=6\) y la frecuencia relativa es
\[ f_i= \frac{6}{10}=0{,}6. \]
Las frecuencias muestrales se organizan habitualmente en tablas de frecuencias, que muestran para cada valor observado \(x_i\) su frecuencia absoluta \(n_i\) o su frecuencia relativa \(f_i\).
Ejemplo 2.2 Número de hijos en una muestra de 25 familias.
# Data frame número de hijos
df <- tibble(
hijos = rep(c(0,1,2,3,4),
c(2,6,14,2,1))
)
# Tabla de frecuencias
df |>
tabyl(hijos) |>
kable()| hijos | n | percent |
|---|---|---|
| 0 | 2 | 0.08 |
| 1 | 6 | 0.24 |
| 2 | 14 | 0.56 |
| 3 | 2 | 0.08 |
| 4 | 1 | 0.04 |
# Diagrama de barras
df |> ggplot(aes(x = hijos)) +
  geom_bar(width = 0.2, fill = myblue) +
  theme_minimal() +
  labs(x = "Número de hijos", y = "Frecuencia absoluta")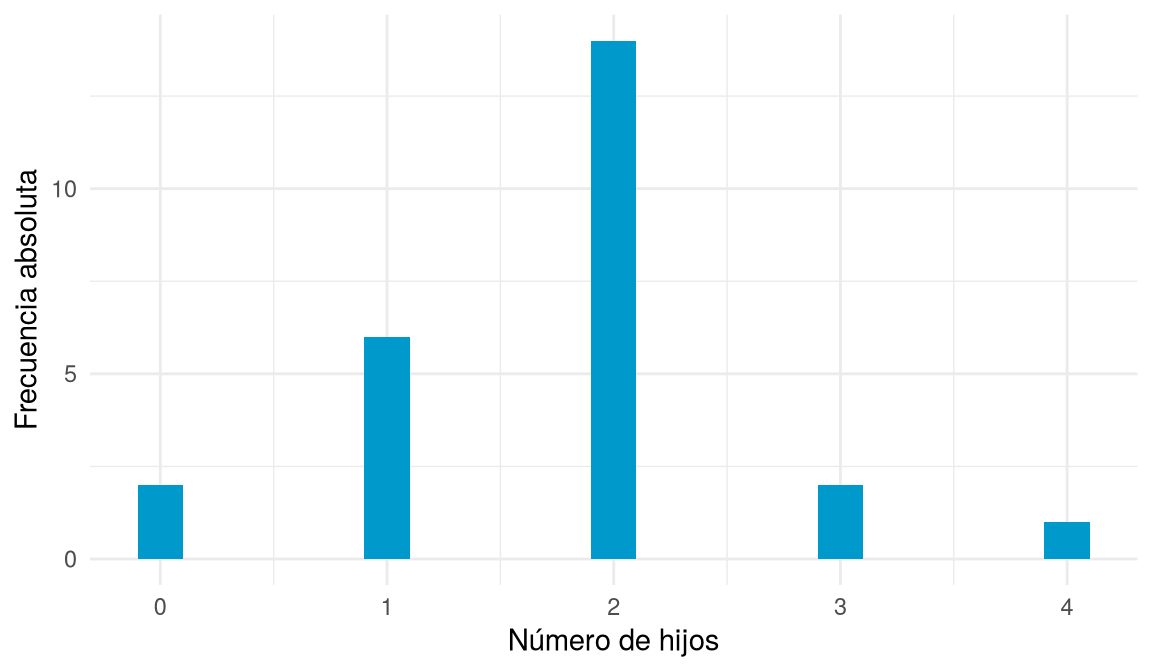
Ejemplo 2.3 Grupos sanguíneos de una muestra de 30 personas.
# Data frame grupo sanguíneo
df <- tibble(
  grupo = rep(c("0","A","B","AB"),
              c(5,14,8,3))
)
# Tabla de frecuencias
df |>
  tabyl(grupo) |>
kable()| grupo | n | percent |
|---|---|---|
| 0 | 5 | 0.1666667 |
| A | 14 | 0.4666667 |
| AB | 3 | 0.1000000 |
| B | 8 | 0.2666667 |
Ejercicio 2.1 El conjunto de datos neonatos contiene información sobre 320 recién nacidos en varios hospitales de una ciudad.
sexo.tabaco.tabaco.apgar1.apgar1.df_neonatos <- read_csv("datos/neonatos.csv", show_col_types = FALSE)
tabyl(df_neonatos, sexo) |> kable()| sexo | n | percent |
|---|---|---|
| hombre | 157 | 0.490625 |
| mujer | 163 | 0.509375 |
tabyl(df_neonatos, tabaco) |> kable()| tabaco | n | percent |
|---|---|---|
| No | 220 | 0.6875 |
| Si | 100 | 0.3125 |
df_neonatos |> ggplot(aes(x = tabaco)) +
  stat_count(width = 0.2, fill = myblue) +
  theme_minimal() +
  labs(x = "Tabaco", y = "Frecuencia absoluta")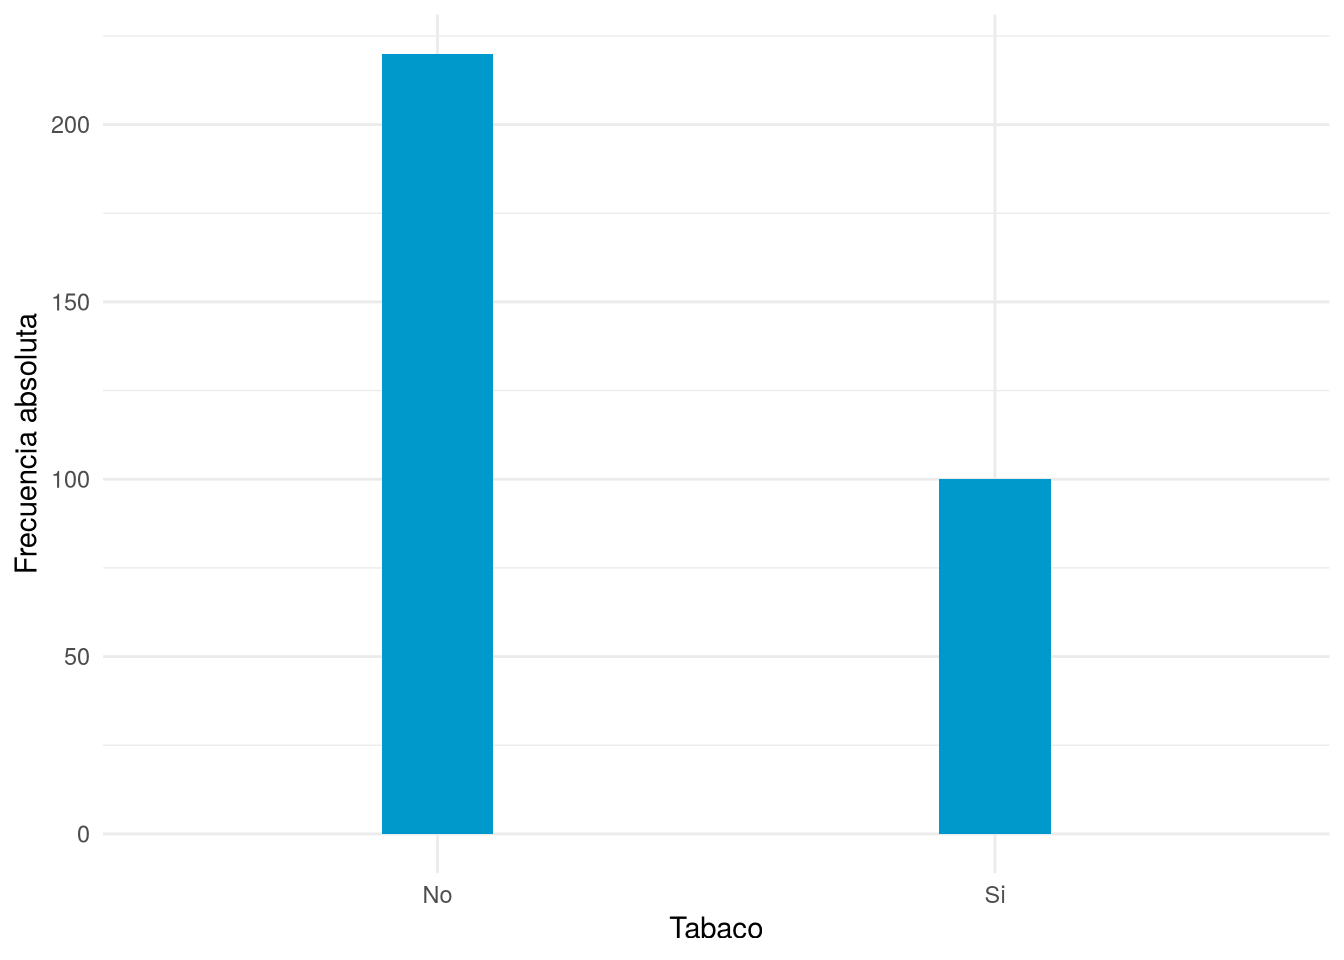
tabyl(df_neonatos, apgar1) |> kable()| apgar1 | n | percent |
|---|---|---|
| 2 | 4 | 0.012500 |
| 3 | 21 | 0.065625 |
| 4 | 38 | 0.118750 |
| 5 | 81 | 0.253125 |
| 6 | 97 | 0.303125 |
| 7 | 46 | 0.143750 |
| 8 | 28 | 0.087500 |
| 9 | 5 | 0.015625 |
df_neonatos |> ggplot(aes(x = apgar1, y = after_stat(prop))) +
  stat_count(width = 0.2, fill = myblue) +
  theme_minimal() +
  labs(x = "Apgar 1", y = "Frecuencia relativa")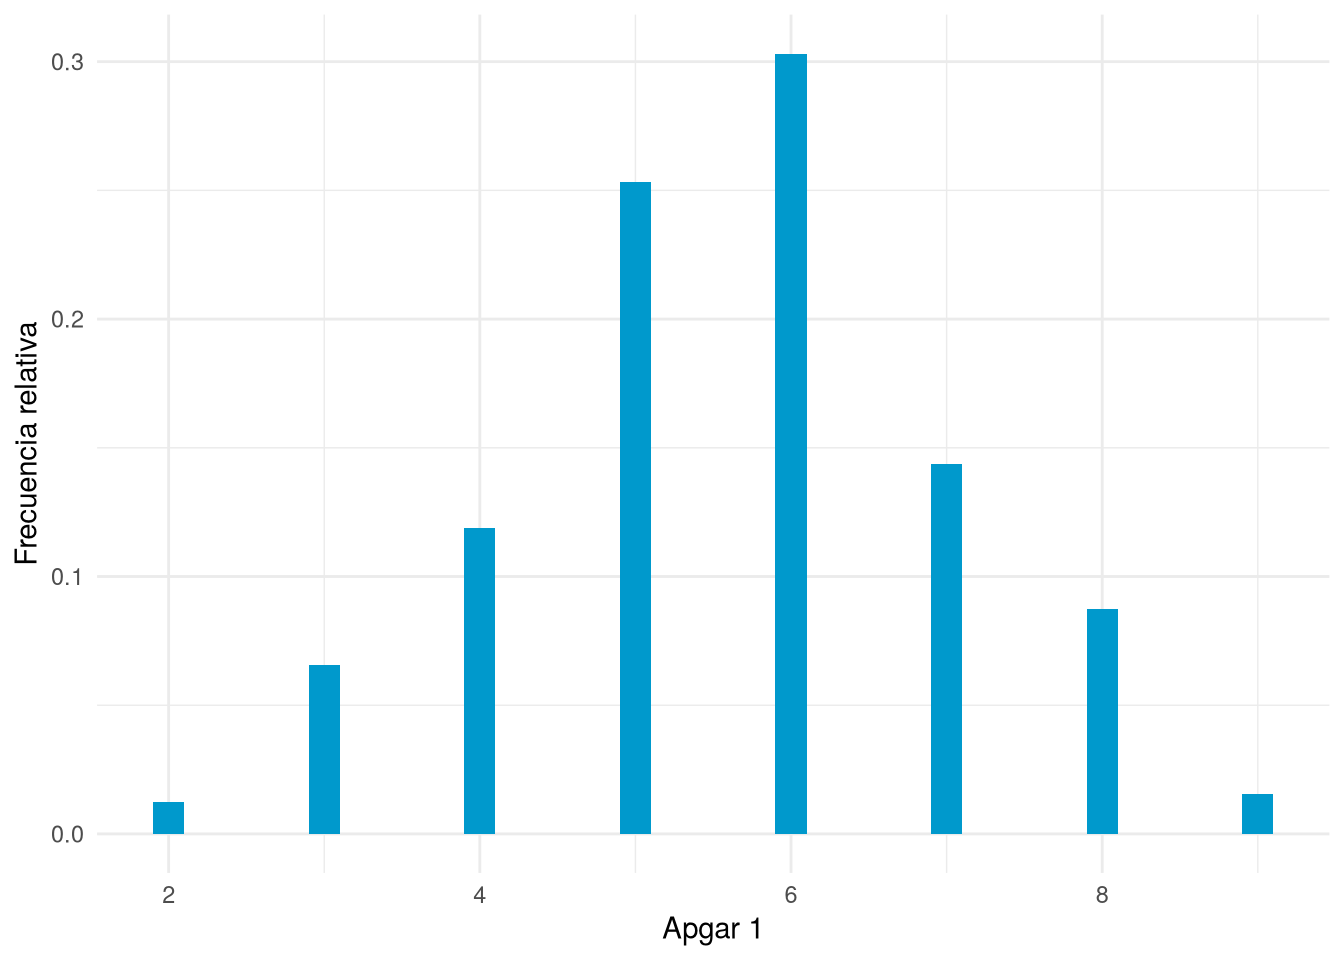
Cuando se consideran dos variables, sus frecuencias se organizan en una tabla de contingencia, que muestra para cada combinación de valores de las variables su frecuencia absoluta o relativa.
Ejemplo 2.4 Sexo y grupo sanguíneo de una muestra de 30 personas.
# Data frame sexo y grupo sanguíneo
df <- tibble(
  sexo = rep(c("Hombre","Mujer"),
             c(16,14)),
  grupo = c(rep("0",3), rep("A",8), rep("B",4), rep("AB",1),
            rep("0",2), rep("A",6), rep("B",4), rep("AB",2))
)
# Tabla bidimensional de frecuencias absolutas
df |>
  tabyl(grupo, sexo) |>
kable()| grupo | Hombre | Mujer |
|---|---|---|
| 0 | 3 | 2 |
| A | 8 | 6 |
| AB | 1 | 2 |
| B | 4 | 4 |
# Tabla bidimensional de frecuencias relativas
df |>
  tabyl(grupo, sexo) |>
  adorn_percentages("all") |>
  adorn_pct_formatting() |>
kable()| grupo | Hombre | Mujer |
|---|---|---|
| 0 | 10.0% | 6.7% |
| A | 26.7% | 20.0% |
| AB | 3.3% | 6.7% |
| B | 13.3% | 13.3% |
Sumando por filas o por columnas de una tabla de contingencia se obtienen las distribuciones marginales de cada variable, que muestran la frecuencia de cada valor de una variable sin tener en cuenta la otra.
Ejemplo 2.5
# Distribución marginal del sexo
df |>
  tabyl(grupo, sexo) |>
  adorn_totals("row") |>
kable()| grupo | Hombre | Mujer |
|---|---|---|
| 0 | 3 | 2 |
| A | 8 | 6 |
| AB | 1 | 2 |
| B | 4 | 4 |
| Total | 16 | 14 |
# Distribución marginal del grupo sanguíneo
df |>
  tabyl(grupo, sexo) |>
  adorn_totals("col") |>
kable()| grupo | Hombre | Mujer | Total |
|---|---|---|---|
| 0 | 3 | 2 | 5 |
| A | 8 | 6 | 14 |
| AB | 1 | 2 | 3 |
| B | 4 | 4 | 8 |
Ejercicio 2.2 El conjunto de datos neonatos contiene información sobre 320 recién nacidos en varios hospitales de una ciudad.
edad y tabaco. Añadir las frecuencias marginales de cada variable.tabaco y apgar1 para cada grupo de edad.df_neonatos |>
tabyl(edad, tabaco) |>
adorn_totals(c("row", "col")) |>
kable()| edad | No | Si | Total |
|---|---|---|---|
| mayor de 20 | 140 | 78 | 218 |
| menor de 20 | 80 | 22 | 102 |
| Total | 220 | 100 | 320 |
df_neonatos |>
  tabyl(tabaco, apgar1, edad) |>
  adorn_percentages("all") |>
  adorn_pct_formatting() |>
  kable()
|
|
Cada fila o columna de una tabla de contingencia es una distribución de frecuencias condicional, que muestra la frecuencia de cada valor de una variable para un valor fijo de la otra.
Ejemplo 2.6
# Distribución condicional del grupo sanguíneo para hombres
df |>
  tabyl(grupo, sexo) |>
  kable() |>
column_spec(2, color = myblue)| grupo | Hombre | Mujer |
|---|---|---|
| 0 | 3 | 2 |
| A | 8 | 6 |
| AB | 1 | 2 |
| B | 4 | 4 |
# Distribución condicional del sexo para el grupo A
df |>
  tabyl(grupo, sexo) |>
  kable() |>
row_spec(2, color = myblue)| grupo | Hombre | Mujer |
|---|---|---|
| 0 | 3 | 2 |
| A | 8 | 6 |
| AB | 1 | 2 |
| B | 4 | 4 |
El siguiente código permite obtener la distribución de los grupos sanguíneos de las mujeres, y el que le sigue, las distribuciones condicionales para todas las categorías del sexo.
# Filtramos las mujeres
filter(df, sexo == "Mujer") |>
  tabyl(grupo) |>
kable()| grupo | n | percent |
|---|---|---|
| 0 | 2 | 0.1428571 |
| A | 6 | 0.4285714 |
| AB | 2 | 0.1428571 |
| B | 4 | 0.2857143 |
df |>
  split(~sexo) |>
  map(~tabyl(.x, grupo)) |>
  kable()
|
|
Ejercicio 2.3 El conjunto de datos neonatos contiene información sobre 320 recién nacidos en varios hospitales de una ciudad.
tabaco para cada grupo de edad.apgar1 para cada grupo de tabaco.apgar1 para hijos de madres fumadoras de menos de 20 años.df_neonatos |>
split(~edad) |>
map(~tabyl(.x, tabaco)) |>
kable()
|
|
df_neonatos |>
  split(~tabaco) |>
  map(~tabyl(.x, apgar1)) |>
  kable()
|
|
filter(df_neonatos, tabaco == "Si", edad  == "menor de 20") |>
  tabyl(apgar1) |>
kable()| apgar1 | n | percent |
|---|---|---|
| 2 | 1 | 0.0454545 |
| 3 | 8 | 0.3636364 |
| 4 | 6 | 0.2727273 |
| 5 | 3 | 0.1363636 |
| 6 | 3 | 0.1363636 |
| 7 | 1 | 0.0454545 |
Definición 2.2 (Experimento aleatorio) Un experimento aleatorio es un experimento que cumple dos condiciones:
En algunos contextos se añade la condición de que el experimento sea reproducible bajo las mismas condiciones, aunque esto no siempre es posible. Podemos repetir el lanzamiento de una moneda en las mismas condiciones, pero no podemos repetir el nacimiento de un niño en las mismas condiciones.
Definición 2.3 (Espacio muestral) Al conjunto \(\Omega\) de todos los posibles resultados de un experimento aleatorio se le llama espacio muestral.
Ejemplo 2.7 Algunos ejemplos de espacios muestrales son:
Ejemplo 2.8 El siguiente diagrama de árbol representa el espacio muestral de un experimento aleatorio en el que se observan el sexo y el grupo sanguíneo de un individuo al azar.
library(data.tree)
df <- tibble(
  sexo = rep(c("Hombre","Mujer"),
             c(14,16)),
  grupo = c(rep("0",2), rep("A",6), rep("B",4), rep("AB",2),
            rep("0",3), rep("A",8), rep("B",4), rep("AB",1))
)
df$pathString <- paste("Ω", df$sexo, df$grupo, sep = "/")
espacio <- as.Node(df)
print(espacio)
levelName
1 Ω
2 ¦--Hombre
3 ¦ ¦--0
4 ¦ ¦--A
5 ¦ ¦--B
6 ¦ °--AB
7 °--Mujer
8 ¦--0
9 ¦--A
10 ¦--B
11 °--ABSetGraphStyle(espacio, rankdir = "LR")
SetEdgeStyle(espacio, arrowhead = "vee")
SetNodeStyle(espacio,
style = "filled, rounded",
shape = "box",
fillcolor = "#89D3F3",
fontcolor = "black")
plot(espacio)Definición 2.4 (Suceso aleatorio) Un suceso aleatorio es cualquier subconjunto del espacio muestral \(\Omega\) de un experimento aleatorio.
Ejemplo 2.9 Algunos ejemplos de sucesos aleatorios son:
Puesto que los sucesos son conjuntos, mediante la teoría de conjuntos se pueden definir las siguientes operaciones entre sucesos: unión, intersección, complementario y diferencia.
Definición 2.5 (Suceso unión) Dados dos sucesos \(A,B\subseteq \Omega\), se llama suceso unión de \(A\) y \(B\), y se denota \(A\cup B\), al suceso formado por los elementos de \(A\) junto con los elementos de \(B\):
\[A\cup B = \{x\,|\, x\in A \mbox{ o } x\in B\}.\]
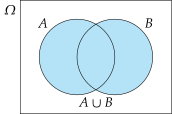
El suceso unión \(A\cup B\) ocurre siempre que ocurre \(A\) o \(B\).
Definición 2.6 (Suceso intersección) Dados dos sucesos \(A,B\subseteq \Omega\), se llama suceso intersección de \(A\) y \(B\), y se denota \(A\cap B\), al suceso formado por los elementos comunes de \(A\) y \(B\):
\[A\cap B = \{x\,|\, x\in A \mbox{ y } x\in B\}.\]
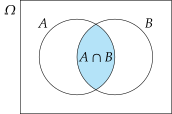
El suceso intersección \(A\cap B\) ocurre siempre que ocurren \(A\) y \(B\).
Diremos que dos sucesos son incompatibles si su intersección es vacía.
Definición 2.7 (Suceso contrario) Dado un suceso \(A\subseteq \Omega\), se llama suceso contrario o complementario de \(A\), y se denota \(\overline A\), al suceso formado por los elementos de \(\Omega\) que no pertenecen a \(A\):
\[\overline A = \{x\,|\, x\not\in A\}.\]
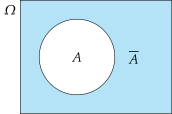
El suceso contrario \(\overline A\) ocurre siempre que no ocurre \(A\).
Definición 2.8 (Suceso diferencia) Dados dos sucesos \(A,B\subseteq \Omega\), se llama suceso diferencia de \(A\) y \(B\), y se denota \(A-B\), al suceso formado por los elementos de \(A\) que no pertenecen a \(B\):
\[A-B = \{x\,|\, x\in A \mbox{ y } x\not\in B\} = A \cap \overline B.\]
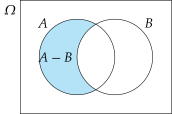
El suceso diferencia \(A-B\) ocurre siempre que ocurre \(A\) pero no ocurre \(B\).
Ejemplo 2.10 Dado el espacio muestral correspondiente al lanzamiento de un dado, \(\Omega=\{1,2,3,4,5,6\}\), y los sucesos \(A=\{2,4,6\}\) y \(B=\{1,2,3,4\}\):
Definición 2.9 (Probabilidad de Laplace) Dado un espacio muestral \(\Omega\) de un experimento aleatorio en el que todos los elementos de \(\Omega\) son equiprobables, la probabilidad de un suceso \(A\subseteq \Omega\) es el cociente entre el número de elementos de \(A\) y el número de elementos de \(\Omega\):
\[P(A) = \frac{|A|}{|\Omega|} = \frac{\mbox{nº casos favorables a } A}{\mbox{nº casos posibles}}\]
Esta definición es ampliamente utilizada, pero tiene importantes restricciones:
Estas condiciones no se cumplen en muchos experimentos aleatorios reales.
Ejemplo 2.11 Dado el espacio muestral correspondiente al lanzamiento de un dado, \(\Omega=\{1,2,3,4,5,6\}\), y el suceso \(A=\{2,4,6\}\), la probabilidad de \(A\) es
\[P(A) = \frac{|A|}{|\Omega|} = \frac{3}{6} = 0{,}5.\]
Sin embargo, si consideramos el espacio muestral correspondiente a observar el grupo sanguíneo de un individuo al azar, \(\Omega=\{0,A,B,AB\}\), no podemos usar la definición clásica para calcular la probabilidad de que tenga grupo sanguíneo \(A\),
\[P(A) \neq \frac{|A|}{|\Omega|} = \frac{1}{4} = 0{,}25,\]
porque los grupos sanguíneos no son igualmente probables en las poblaciones humanas.
Teorema 2.1 (Ley de los grandes números) Cuando un experimento aleatorio se repite un gran número de veces, las frecuencias relativas de los sucesos del experimento tienden a estabilizarse en torno a cierto número, que es precisamente su probabilidad.
Definición 2.10 (Probabilidad frecuentista) Dado un espacio muestral \(\Omega\) de un experimento aleatorio reproducible, la probabilidad de un suceso \(A\subseteq \Omega\) es la frecuencia relativa del suceso \(A\) en infinitas repeticiones del experimento:
\[P(A) = \lim_{n\rightarrow \infty}\frac{n_{A}}{n}\]
Aunque esta definición es muy útil en experimentos científicos reproducibles, tiene serios inconvenientes:
Ejemplo 2.12 Dado el espacio muestral correspondiente al lanzamiento de una moneda, \(\Omega=\{C,X\}\), si después de lanzar la moneda 100 veces obtenemos 54 caras, la probabilidad de \(C\) es aproximadamente
\[P(C) \approx \frac{n_C}{n} = \frac{54}{100} = 0{,}54.\]
Ejemplo 2.13 Si consideramos el espacio muestral correspondiente a observar el grupo sanguíneo de un individuo al azar, \(\Omega=\{0,A,B,AB\}\), y tomamos una muestra aleatoria de 1000 personas en la que 412 tienen grupo sanguíneo \(A\), la probabilidad del grupo sanguíneo \(A\) es aproximadamente
\[P(A) \approx \frac{n_A}{n} = \frac{412}{1000} = 0{,}412.\]
Definición 2.11 (Probabilidad subjetiva) Dado un espacio muestral \(\Omega\) de un experimento aleatorio, la probabilidad de un suceso \(A\subseteq \Omega\) es una medida de la confianza que un individuo tiene en que el suceso \(A\) ocurra, y se expresa mediante un número real entre 0 y 1.
Es la definición de probabilidad más usada en nuestras decisiones cotidianas, pero también tiene inconvenientes:
Ejemplo 2.14 Basándome en el tiempo de los días previos, puedo hacer la predicción de que es moderadamente probable que llueva mañana. Sin embargo, mi abuelo puede hacer esta otra predicción: me duele la rodilla, así que mañana va a llover.
Definición 2.12 (Probabilidad de Kolmogórov) Dado un espacio muestral \(\Omega\) de un experimento aleatorio, una función de probabilidad es una aplicación que asocia a cada suceso \(A\subseteq \Omega\) un número real \(P(A)\) que cumple los siguientes axiomas:
Teorema 2.2 Si \(P\) es una función de probabilidad de un espacio muestral \(\Omega\), entonces para cualesquiera sucesos \(A, B\subseteq \Omega\) se cumple:
En algunas ocasiones tenemos información sobre el experimento antes de realizarlo. Habitualmente esa información se da en forma de un suceso \(B\) del mismo espacio muestral que sabemos que ha ocurrido. En tal caso, \(B\) es un suceso condicionante, y la probabilidad de otro suceso \(A\) se expresa como
\[P(A \mid B),\]
que se lee probabilidad de \(A\) dado \(B\) o probabilidad de \(A\) bajo la condición de \(B\).
Los condicionantes suelen cambiar el espacio muestral del experimento y, por tanto, las probabilidades de sus sucesos.
Ejemplo 2.15 Supongamos que tenemos una muestra de 100 hombres y 100 mujeres con las siguientes frecuencias:
\[ \begin{array}{|c|c|c|} \hline & \mbox{No fumadores} & \mbox{Fumadores} \\ \hline \mbox{Mujeres} & 80 & 20 \\ \hline \mbox{Hombres} & 60 & 40 \\ \hline \end{array} \]
Usando la definición frecuentista de probabilidad, la probabilidad de que una persona elegida al azar sea fumadora es
\[P(\mbox{Fumadora})= \frac{60}{200}=0{,}3.\]
Sin embargo, si sabemos que la persona elegida es mujer, la muestra se reduce a la primera fila, y la probabilidad de que sea fumadora es
\[P(\mbox{Fumadora} \mid \mbox{Mujer}) = \frac{20}{100}=0{,}2.\]
Definición 2.13 (Probabilidad condicionada) Dado un espacio muestral \(\Omega\) de un experimento aleatorio y dos sucesos \(A,B\subseteq \Omega\), la probabilidad de \(A\) condicionada por \(B\) es
\[P(A \mid B) = \frac{P(A\cap B)}{P(B)},\]
siempre que \(P(B)\neq 0\).
Esta definición permite calcular probabilidades condicionadas sin tener que alterar el espacio muestral original del experimento.
Ejemplo 2.16 En el ejemplo anterior,
\[P(\mbox{Fumadora} \mid \mbox{Mujer})= \frac{P(\mbox{Fumadora}\cap \mbox{Mujer})}{P(\mbox{Mujer})} = \frac{20/200}{100/200}=\frac{20}{100}=0{,}2.\]
A partir de la definición de probabilidad condicionada se obtiene la fórmula para calcular la probabilidad de la intersección de dos sucesos:
\[P(A\cap B) = P(A)P(B \mid A) = P(B)P(A \mid B).\]
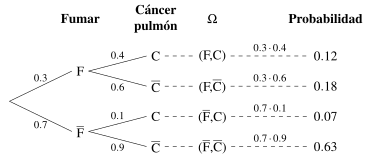
Ejemplo 2.17 En una población hay un 30 % de fumadores, y se sabe que el 40 % de los fumadores tiene cáncer de pulmón. La probabilidad de que una persona elegida al azar sea fumadora y tenga cáncer de pulmón es
\[ \begin{align*} P(\mbox{Fumadora}\cap \mbox{Cáncer}) &= P(\mbox{Fumadora})\,P(\mbox{Cáncer} \mid \mbox{Fumadora}) \\ &= 0{,}3 \times 0{,}4 = 0{,}12. \end{align*} \]
En ocasiones, la ocurrencia del suceso condicionante no cambia la probabilidad original del suceso principal.
Definición 2.14 (Sucesos independientes) Dado un espacio muestral \(\Omega\) de un experimento aleatorio, dos sucesos \(A,B\subseteq \Omega\) son independientes si la probabilidad de \(A\) no se ve alterada al condicionar por \(B\), y viceversa, es decir,
\[P(A \mid B) = P(A) \quad \mbox{y} \quad P(B \mid A)=P(B),\]
si \(P(A)\neq 0\) y \(P(B)\neq 0\).
Esto significa que la ocurrencia de un suceso no aporta información relevante para cambiar la incertidumbre sobre el otro. Cuando dos sucesos son independientes, la probabilidad de su intersección es igual al producto de sus probabilidades:
\[P(A\cap B) = P(A)P(B).\]
Ejemplo 2.18 Sea una población en la que el 30 % de las personas fuma, y en la que la incidencia del cáncer de pulmón es del 40 % en fumadores y del 10 % en no fumadores.
El espacio probabilístico del experimento aleatorio que consiste en elegir una persona al azar y medir las variables fumar y cáncer de pulmón se muestra a continuación.
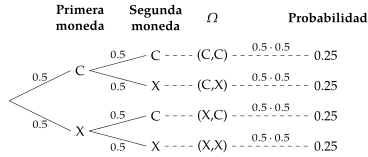
Ejemplo 2.19 El árbol de probabilidad asociado al experimento aleatorio que consiste en el lanzamiento de dos monedas se muestra a continuación.
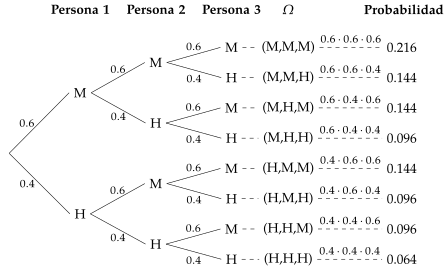
Ejemplo 2.20 Dada una población en la que hay un 40 % de hombres y un 60 % de mujeres, el experimento aleatorio que consiste en tomar una muestra aleatoria de tres personas tiene el árbol de probabilidad que se muestra a continuación.
Definición 2.15 (Variable aleatoria) Una variable aleatoria \(X\) es una función que asocia un número real a cada elemento del espacio muestral de un experimento aleatorio:
\[X:\Omega \rightarrow \mathbb{R}.\]
Al conjunto de posibles valores que puede tomar la variable se le llama rango o recorrido de la variable, y se representa por \(\mbox{Ran}(X)\).
En el fondo, una variable aleatoria es una variable cuyos valores provienen de la realización de un experimento aleatorio, y por tanto tendrá asociada una determinada distribución de probabilidad.
Ejemplo 2.21 La variable \(X\) que mide el número de personas infectadas con un virus en una muestra aleatoria de 10 personas es una variable aleatoria, cuyo rango es el conjunto de números enteros entre 0 y 10:
\[ \mbox{Ran}(X)=\{0,1,2,3,4,5,6,7,8,9,10\}. \]
Las variables aleatorias se clasifican en dos tipos:
Definición 2.16 (Función de probabilidad) La función de probabilidad de una variable aleatoria discreta \(X\) es una función \(f(x)\) que asocia a cada valor de la variable su probabilidad:
\[ f(x_i) = P(X=x_i). \]
Ejemplo 2.22 La función de probabilidad de la variable que mide el número de caras obtenidas al lanzar una moneda tres veces es
\[ \begin{array}{c|cccc} x & 0 & 1 & 2 & 3 \\ \hline f(x) & \frac{1}{8} & \frac{3}{8} & \frac{3}{8} & \frac{1}{8} \end{array} \]
La media o esperanza de \(X\) es
\[ E(X) = \sum_{i} x_i f(x_i), \]
y la varianza es
\[ Var(X) = \sum_{i} (x_i - E(X))^2 f(x_i) = \sum_{i} x_i^2 f(x_i) - E(X)^2. \]
Definición 2.17 (Distribución uniforme discreta) Se dice que una variable aleatoria discreta \(X\) sigue un modelo de distribución uniforme discreto, \(X\sim U(n)\), si su rango es \(\mbox{Ran}(X)=\{1,\ldots,n\}\) y su función de probabilidad es constante:
\[ P(X=k) = \frac{1}{n} \quad \forall k=1,\ldots,n. \]
El modelo uniforme discreto se utiliza para modelar experimentos aleatorios con un número finito de resultados equiprobables, como el lanzamiento de un dado o la selección aleatoria de un individuo de una población finita.
Ejemplo 2.23 El modelo de distribución de probabilidad del resultado de lanzar un dado equilibrado es uniforme discreto \(U(6)\).
df <- tibble(
  x = 1:6, # Rango
  p = rep(1/6, 6) # Probabilidad
)
# Diagrama de barras
ggplot(df, aes(x = x, y = p)) +
  geom_bar(stat = "identity", width = 0.2, fill = myblue) +
  scale_x_continuous(breaks = 1:6) +
  labs(x = "X", y = "Probabilidad") +
  theme_minimal()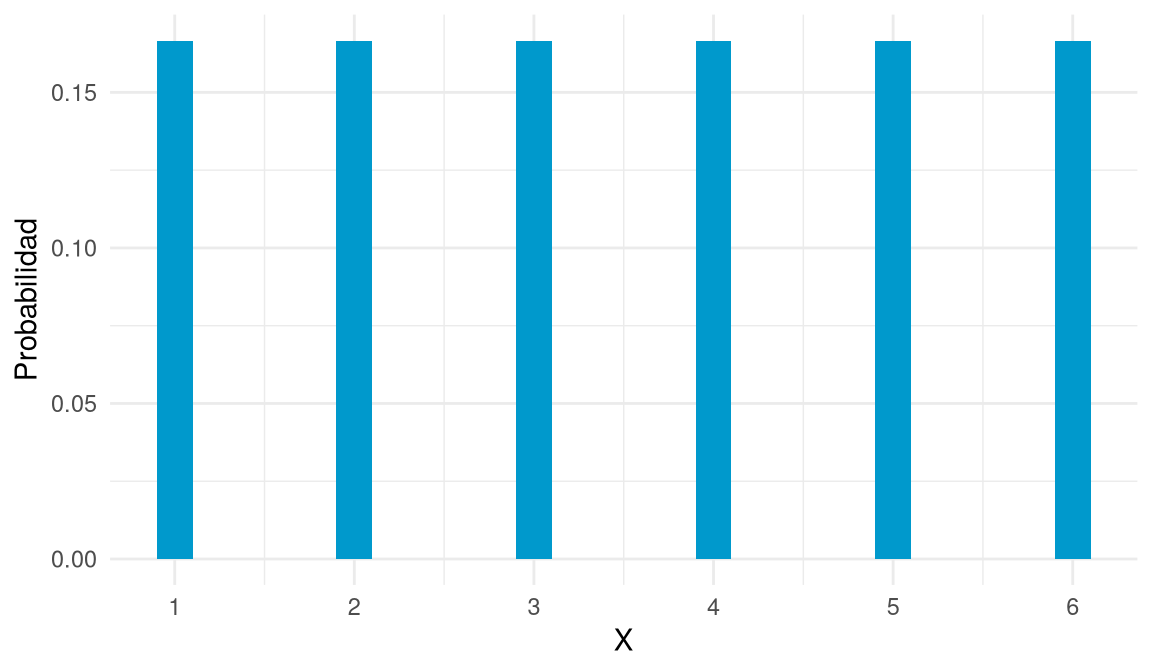
Definición 2.18 (Distribución binomial) Se dice que una variable aleatoria discreta \(X\) sigue un modelo de distribución binomial, \(X\sim B(n, p)\), si su rango es \(\mbox{Ran}(X)=\{0,1,\ldots,n\}\) y su función de probabilidad es
\[ P(X=k) = \binom{n}{k} p^k (1-p)^{n-k} \quad k=0,1,\ldots,n, \]
donde \(n\) es el número de ensayos y \(p\) la probabilidad de éxito en cada ensayo.
El modelo binomial se utiliza para modelar el número de éxitos en \(n\) ensayos independientes con dos posibles resultados (éxito/fracaso), como el número de caras al lanzar \(n\) monedas o el número de individuos enfermos en una muestra de tamaño \(n\).
Sus estadísticos son
\[ E(X) = np \quad \mbox{y} \quad Var(X) = np(1-p). \]
Ejemplo 2.24 En una población hay el mismo número de hombres que de mujeres. La variable que mide el número de mujeres en una muestra aleatoria de 10 personas sigue una distribución binomial \(B(10, 0{,}5)\).
df <- tibble(
  x = 0:10,  # Rango
  p = dbinom(0:10, size = 10, prob = 0.5) # Probabilidad
)
# Diagrama de barras
ggplot(df, aes(x = x, y = p)) +
  geom_bar(stat = "identity", width = 0.2, fill = myblue) +
  scale_x_continuous(breaks = 0:10) +
  labs(x = "Número de mujeres", y = "Probabilidad") +
  theme_minimal()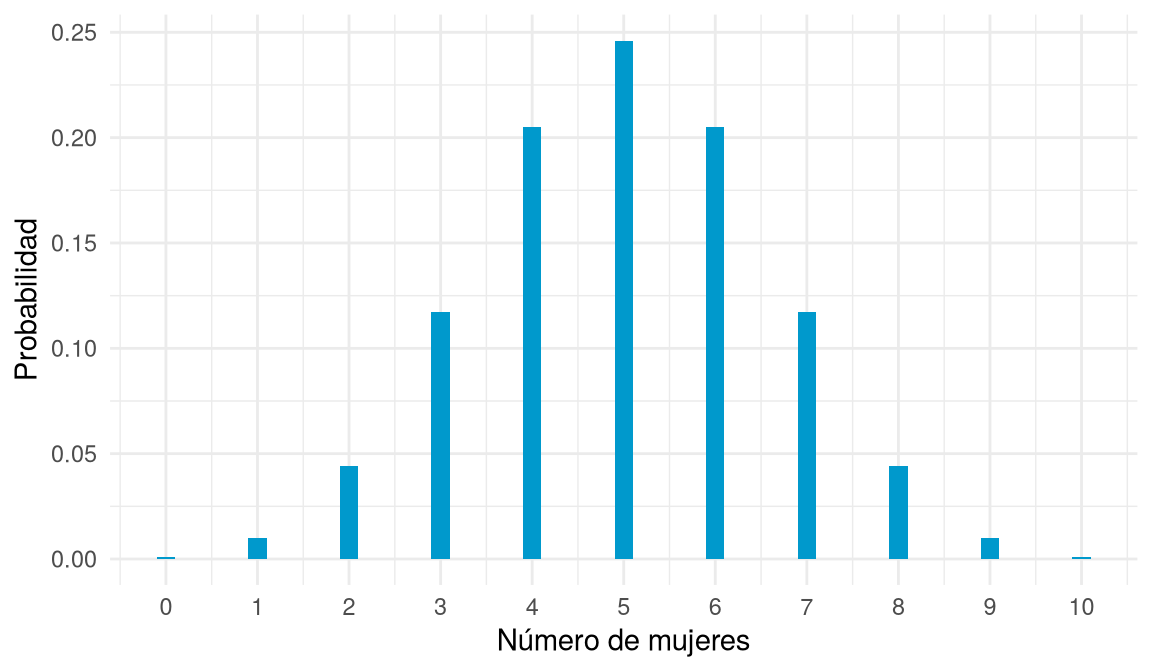
params <- expand.grid(n = c(10, 30, 100), p = c(0.1, 0.5, 0.9))
df_binom <- params |>
  rowwise() |>
  mutate(x = list(0:n), prob = list(dbinom(0:n, size = n, prob = p))) |>
  unnest(cols = c(x, prob)) |>
  mutate(
    label = factor(
      paste0("n = ", n, ", p = ", p),
      levels = paste0("n = ", rep(c(10, 30, 100), 3), ", p = ", rep(c(0.1, 0.5, 0.9), each = 3))
    )
  )

df_binom |>
  ggplot(aes(x = x, y = prob)) +
  geom_bar(stat = "identity", width = 0.5, fill = myblue) +
  facet_wrap(~ label, scales = "free", nrow = 3) +
  labs(x = "X", y = "Probabilidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))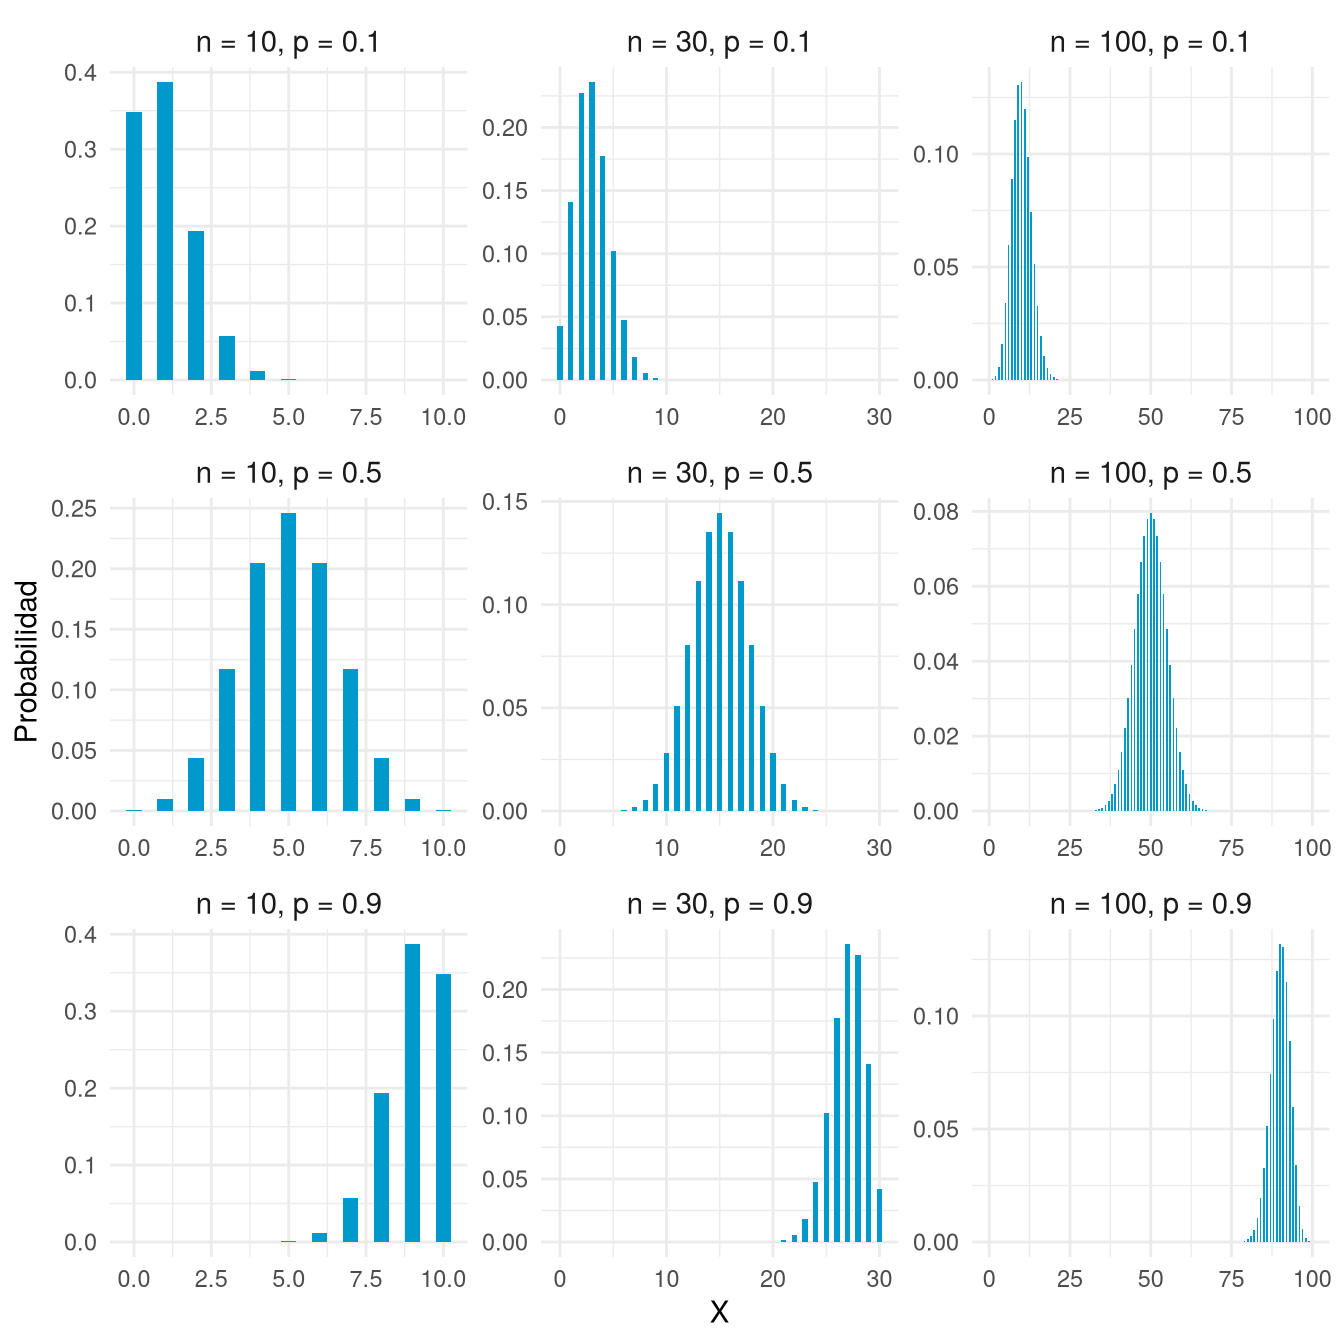
Definición 2.19 (Distribución geométrica) Se dice que una variable aleatoria discreta \(X\) sigue un modelo de distribución geométrica, \(X\sim G(p)\), si su rango es \(\mbox{Ran}(X)=\{0,1,2,\ldots\}\) y su función de probabilidad es
\[ P(X=k) = (1-p)^{k}p \quad k=0,1,2,\ldots, \]
donde \(p\) es la probabilidad de éxito en cada ensayo.
El modelo geométrico se utiliza para modelar el número de fracasos necesarios hasta obtener el primer éxito en una serie de ensayos independientes con dos posibles resultados, como el número de pacientes sanos que se examinan hasta encontrar un paciente enfermo.
Sus estadísticos son
\[ E(X) = \frac{1-p}{p} \quad \mbox{y} \quad Var(X) = \frac{1-p}{p^2}. \]
Ejemplo 2.25 En una población hay aproximadamente un 30 % de fumadores. La variable que mide el número de personas no fumadoras que hay que examinar hasta encontrar la primera persona fumadora sigue una distribución geométrica \(G(0{,}3)\).
df <- tibble(
  x = 0:14,  # Rango truncado (número de fracasos)
  p = dgeom(0:14, prob = 0.3) # Probabilidad
)
# Diagrama de barras
ggplot(df, aes(x = x, y = p)) +
  geom_bar(stat = "identity", width = 0.2, fill = myblue) +
  scale_x_continuous(breaks = 0:14) +
  labs(x = "Número de no fumadoras hasta la primera fumadora", y = "Probabilidad") +
  theme_minimal()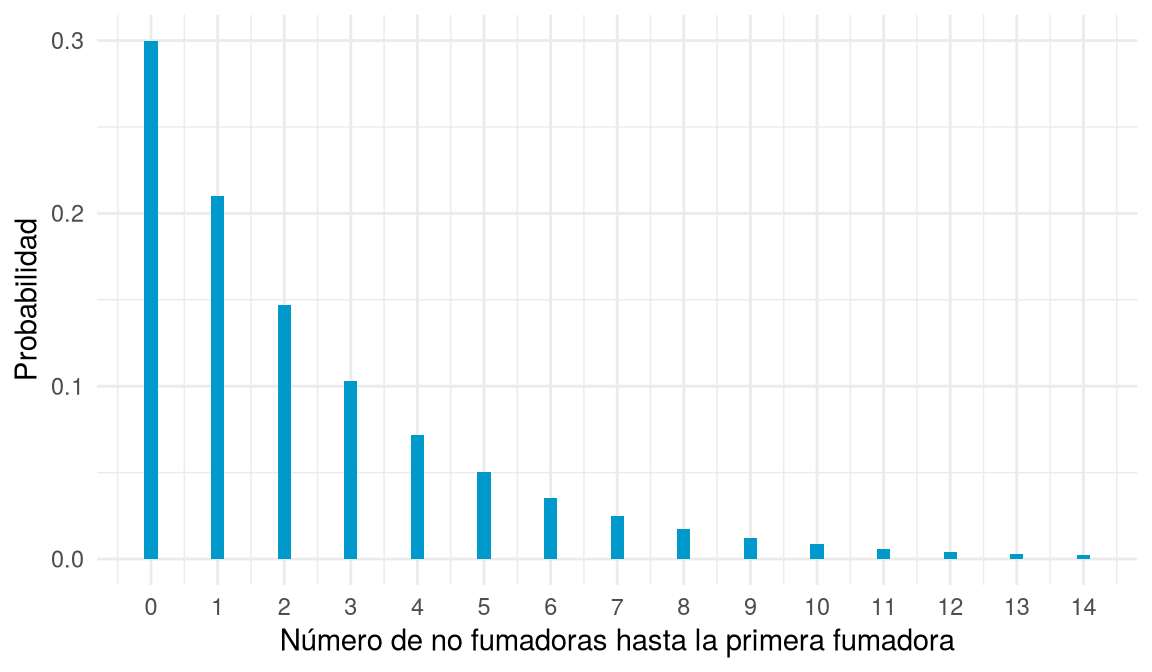
ps <- c(0.1, 0.5, 0.9)
df_geom <- tibble(p = ps) |>
  rowwise() |>
  mutate(x = list(0:14), prob = list(dgeom(0:14, prob = p))) |>
  unnest(cols = c(x, prob)) |>
  mutate(label = factor(paste0("p == ", p),
                        levels = paste0("p == ", ps)))
df_geom |>
  ggplot(aes(x = x, y = prob)) +
  geom_bar(stat = "identity", width = 0.5, fill = myblue) +
  facet_wrap(~ label, nrow = 1, labeller = label_parsed) +
  labs(x = "X", y = "Probabilidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))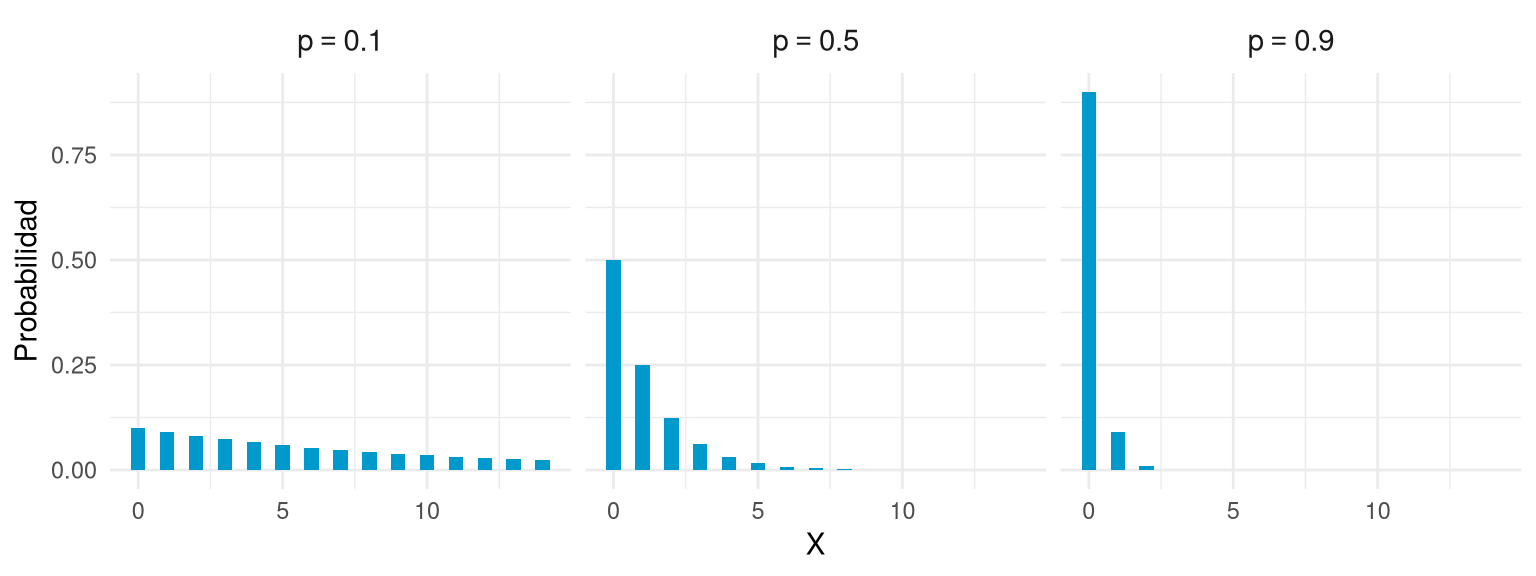
Definición 2.20 (Distribución binomial negativa) Se dice que una variable aleatoria discreta \(X\) sigue un modelo de distribución binomial negativa, \(X\sim BN(r, p)\), si su rango es \(\mbox{Ran}(X)=\{0, 1, 2, \ldots\}\) y su función de probabilidad es
\[ P(X=k) = \binom{r+k-1}{k}p^r(1-p)^{k} \quad k=0, 1, 2, \ldots, \]
donde \(r\) es el número de éxitos y \(p\) la probabilidad de éxito en cada ensayo.
El modelo binomial negativo se utiliza para modelar el número de fracasos necesarios para obtener \(r\) éxitos en una serie de ensayos independientes con dos posibles resultados, como el número de pacientes sanos que se examinan hasta encontrar el tercer paciente enfermo.
Sus estadísticos son
\[ E(X) = \frac{r(1-p)}{p} \quad \mbox{y} \quad Var(X) = \frac{r(1-p)}{p^2}. \]
Ejemplo 2.26 Se sabe que en una población hay aproximadamente un 30 % de fumadores. La variable que mide el número de personas no fumadoras hasta obtener 3 personas fumadoras sigue una distribución \(BN(3, 0{,}3)\).
df <- tibble(
  x = 0:25,  # Rango truncado (número de fracasos)
  p = dnbinom(0:25, size = 3, prob = 0.3) # Probabilidad
)
# Diagrama de barras
ggplot(df, aes(x = x, y = p)) +
  geom_bar(stat = "identity", width = 0.2, fill = myblue) +
  scale_x_continuous(breaks = seq(0, 25, by = 5)) +
  labs(x = "Número de no fumadoras hasta la tercera fumadora", y = "Probabilidad") +
  theme_minimal()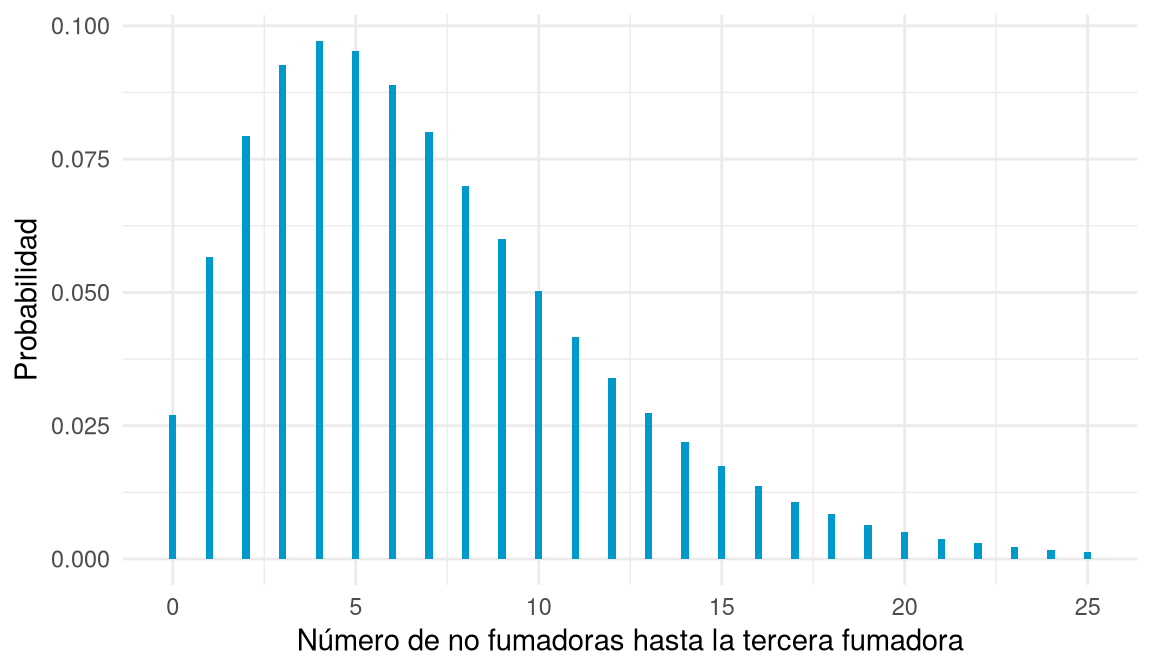
params <- expand.grid(r = c(1, 3, 5), p = c(0.2, 0.5, 0.8))
df_binom <- params |>
  rowwise() |>
  mutate(x = list(0:30), prob = list(dnbinom(0:30, size = r, prob = p))) |>
  unnest(cols = c(x, prob)) |>
  mutate(
    label = factor(
      paste0("r = ", r, ", p = ", p),
      levels = paste0("r = ", rep(c(1, 3, 5), 3), ", p = ", rep(c(0.2, 0.5, 0.8), each = 3))
    )
  )

df_binom |>
  ggplot(aes(x = x, y = prob)) +
  geom_bar(stat = "identity", width = 0.5, fill = myblue) +
  facet_wrap(~ label, scales = "free", nrow = 3) +
  labs(x = "X", y = "Probabilidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))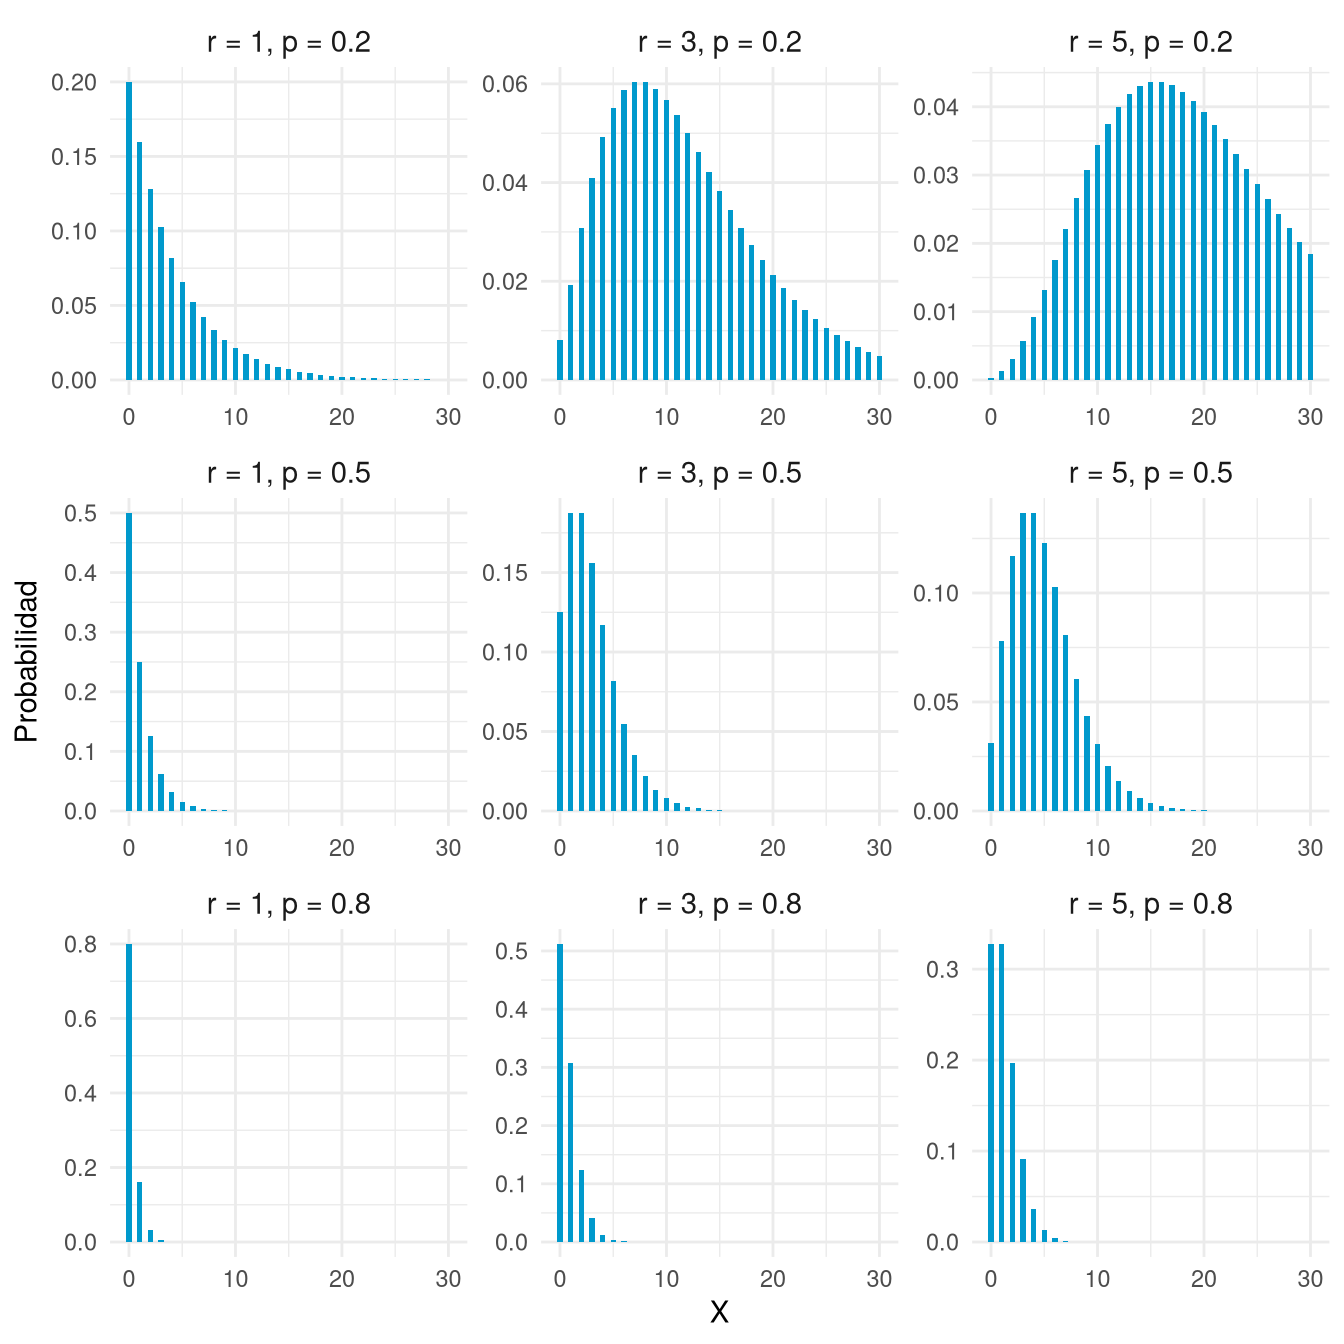
Definición 2.21 (Distribución de Poisson) Se dice que una variable aleatoria discreta \(X\) sigue un modelo de distribución de Poisson, \(X\sim P(\lambda)\), si su rango es \(\mbox{Ran}(X)=\{0,1,2,\ldots\}\) y su función de probabilidad es
\[ P(X=k) = \frac{e^{-\lambda}\lambda^k}{k!} \quad k=0,1,2,\ldots, \]
donde \(\lambda>0\) es el número medio de ocurrencias del suceso en el intervalo de referencia.
El modelo de Poisson se utiliza para modelar el número de ocurrencias de un suceso en un intervalo de tiempo o espacio fijo, como el número de llamadas que recibe una centralita en una hora o el número de mutaciones en un fragmento de ADN.
Sus estadísticos son
\[ E(X) = Var(X) = \lambda. \]
Ejemplo 2.27 En una ciudad, el número medio de nacimientos diarios es 4. Entonces, el número de nacimientos en un día sigue una distribución de Poisson \(P(4)\).
df <- tibble(
  x = 0:12,  # Rango truncado
  p = dpois(0:12, lambda = 4)  # Probabilidad
)
# Diagrama de barras
ggplot(df, aes(x = x, y = p)) +
  geom_bar(stat = "identity", width = 0.2, fill = myblue) +
  scale_x_continuous(breaks = 0:12) +
  labs(x = "Número de nacimientos", y = "Probabilidad") +
  theme_minimal()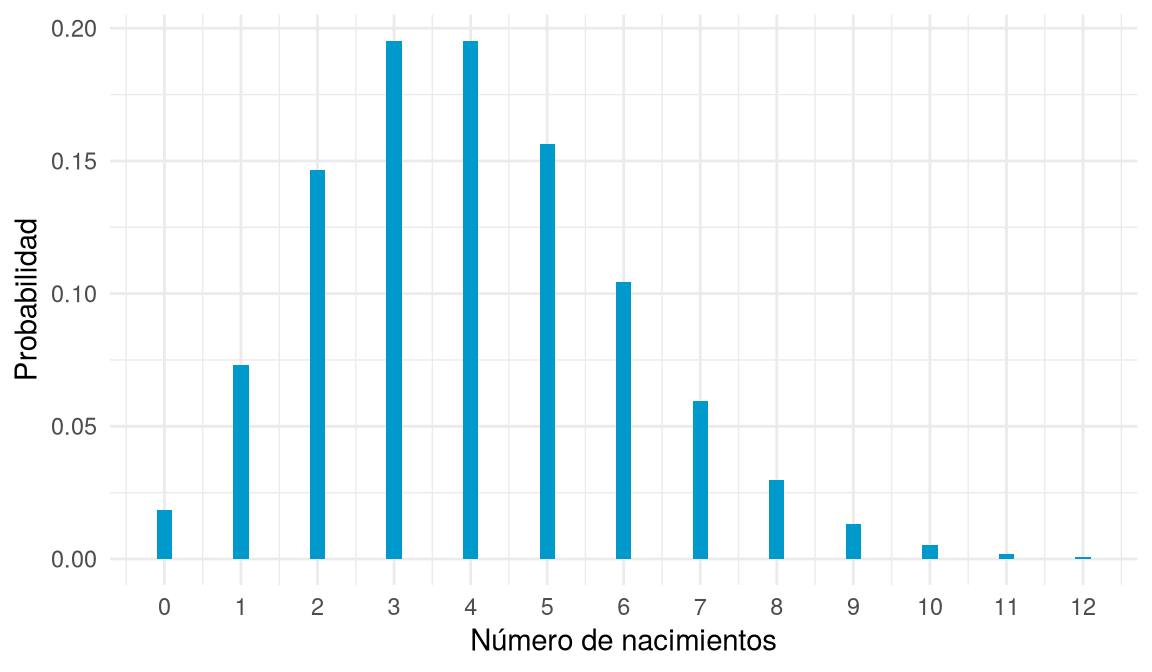
lambdas <- c(2, 10, 30)
df_pois <- tibble(lambda = lambdas) |>
  rowwise() |>
  mutate(x = list(0:qpois(0.999, lambda)), prob = list(dpois(0:qpois(0.999, lambda), lambda))) |>
  unnest(cols = c(x, prob)) |>
  mutate(
    label = factor(paste0("lambda == ", lambda),
                   levels = paste0("lambda == ", lambdas))
  )

df_pois |>
  ggplot(aes(x = x, y = prob)) +
  geom_bar(stat = "identity", width = 0.5, fill = myblue) +
  facet_wrap(~ label, nrow = 1, labeller = label_parsed) +
  labs(x = "X", y = "Probabilidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))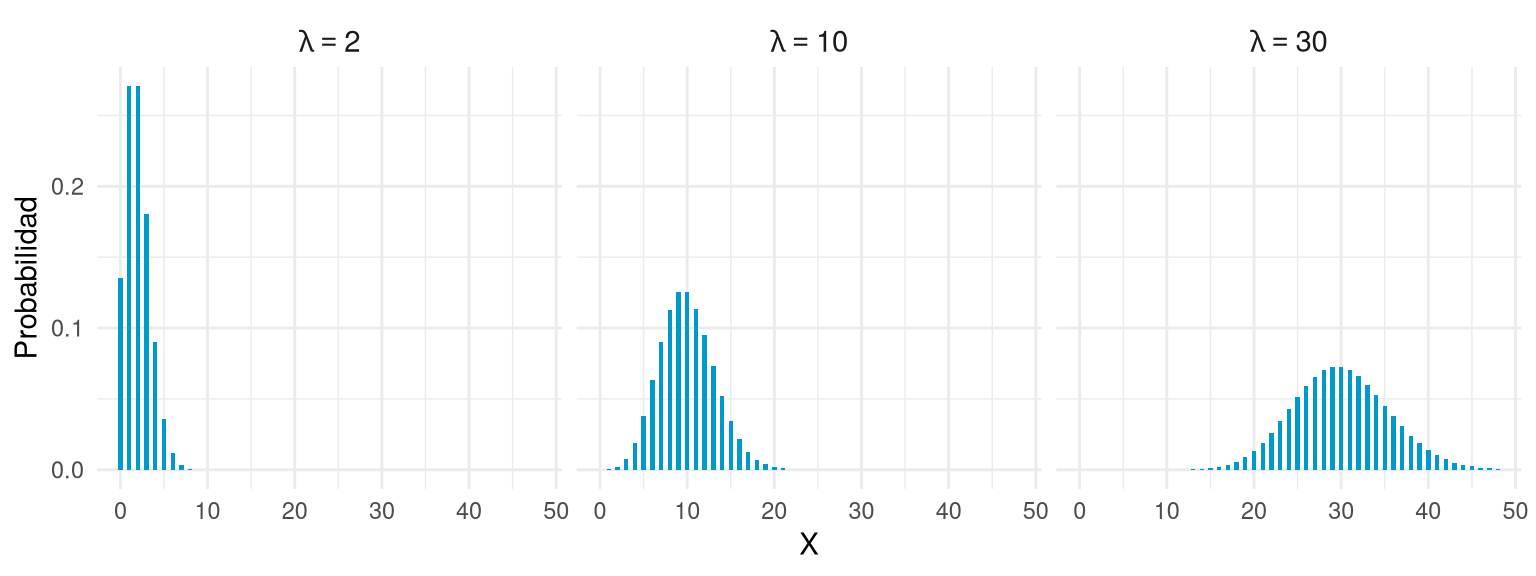
| Distribución | Parámetros | Media | Varianza | Usos habituales |
|---|---|---|---|---|
| Bernoulli(\(p\)) | \(p \in (0,1)\) | \(p\) | \(p(1-p)\) | Resultado binario individual: test positivo/negativo, vivo/muerto, enfermo/sano. |
| Binomial(\(n, p\)) | \(n \in \mathbb{N},\ p \in (0,1)\) | \(np\) | \(np(1-p)\) | Número de éxitos en \(n\) ensayos: respondedores a tratamiento, casos en cribado. |
| Geométrica(\(p\)) | \(p \in (0,1)\) | \(\dfrac{1-p}{p}\) | \(\dfrac{1-p}{p^2}\) | Fracasos hasta el primer éxito: contactos hasta contagio, consultas hasta diagnóstico. |
| Binomial negativa(\(r, p\)) | \(r > 0,\ p \in (0,1)\) | \(\dfrac{r(1-p)}{p}\) | \(\dfrac{r(1-p)}{p^2}\) | Fracasos hasta obtener \(r\) éxitos; conteos sobredispersos: recaídas, reingresos, eventos adversos con varianza mayor que la media. |
| Poisson(\(\lambda\)) | \(\lambda > 0\) | \(\lambda\) | \(\lambda\) | Conteos de eventos raros: casos semanales de enfermedad, llamadas a urgencias. |
| Hipergeométrica(\(N, K, n\)) | \(N, K, n \in \mathbb{N}\) | \(\dfrac{nK}{N}\) | \(\dfrac{nK(N-K)(N-n)}{N^2(N-1)}\) | Muestreo sin reemplazamiento: prevalencia en poblaciones pequeñas. |
Definición 2.22 (Función de densidad) La función de densidad de una variable aleatoria continua \(X\) es una función \(f(x)\) que cumple las siguientes condiciones:
Ejemplo 2.28 La función
\[ f(x) = \begin{cases} e^{-x} & x\geq 0 \\ 0 & x<0 \end{cases} \]
es una función de densidad, ya que cumple las condiciones anteriores:
La media de \(X\) es
\[ E(X) = \int_{-\infty}^{+\infty} x f(x)\,dx, \]
y la varianza,
\[ Var(X) = \int_{-\infty}^{+\infty} (x - E(X))^2 f(x)\,dx = \int_{-\infty}^{+\infty} x^2 f(x)\,dx - E(X)^2. \]
Definición 2.23 (Distribución uniforme continua) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución uniforme continuo, \(X\sim U(a, b)\), si su rango es \(\mbox{Ran}(X)=[a,b]\) y su función de densidad es constante en ese intervalo:
\[ f(x) = \frac{1}{b-a} \quad \forall x\in[a,b], \]
donde \(a\) y \(b\) son el mínimo y el máximo de los valores que puede tomar la variable, respectivamente.
El modelo uniforme continuo se utiliza para modelar experimentos aleatorios en los que todos los valores del intervalo \([a,b]\) son equiprobables, como el tiempo de espera de un autobús que pasa a intervalos fijos.
Sus estadísticos son
\[ E(X) = \frac{a+b}{2} \quad \mbox{y} \quad Var(X) = \frac{(b-a)^2}{12}. \]
Ejemplo 2.29 El tiempo de espera de un autobús que pasa cada 20 minutos sigue una distribución uniforme continua \(U(0, 20)\).
df <- tibble(x = c(0, 0, 20, 20), p = c(0, 1/20, 1/20, 0))
# Diagrama de densidad de probabilidad
ggplot(df, aes(x = x, y = p)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  labs(x = "Tiempo de espera (minutos)", y = "Densidad") +
  theme_minimal()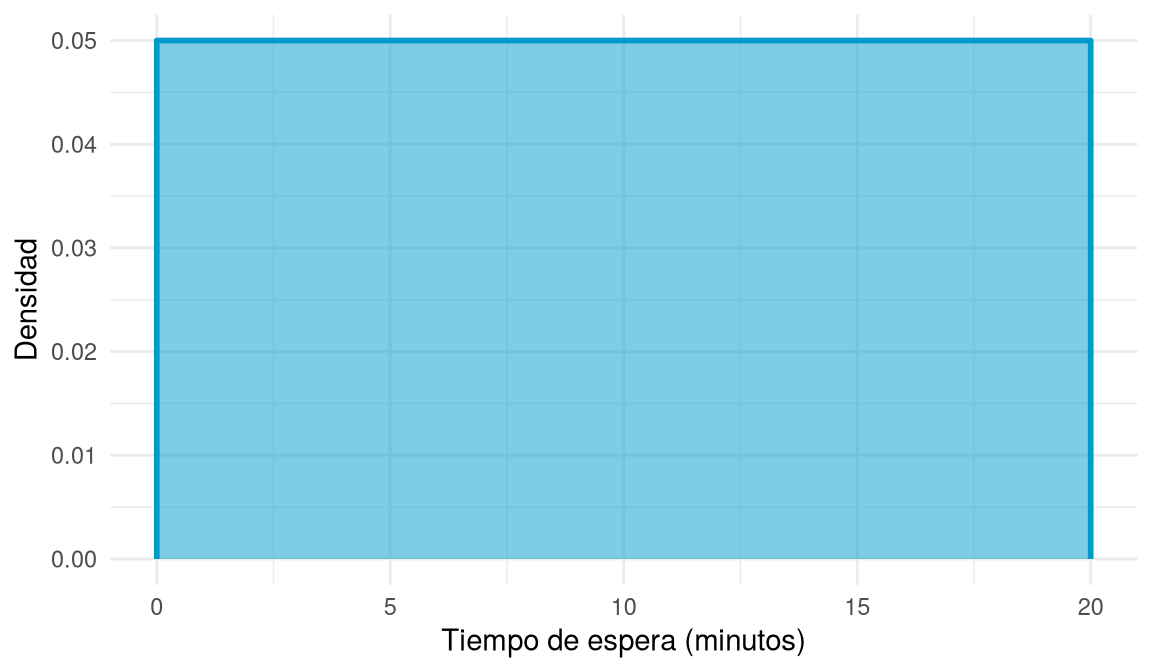
Definición 2.24 (Distribución beta) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución beta, \(X\sim \mbox{Beta}(\alpha, \beta)\), si su rango es \(\mbox{Ran}(X)=[0,1]\) y su función de densidad es
\[ f(x) = \frac{x^{\alpha-1}(1-x)^{\beta-1}}{B(\alpha,\beta)} \quad x\in[0,1], \]
donde \(\alpha, \beta>0\) son los parámetros de forma y \(B(\alpha,\beta)=\frac{\Gamma(\alpha)\Gamma(\beta)}{\Gamma(\alpha+\beta)}\) es la función beta.
El modelo beta se utiliza para modelar proporciones o probabilidades, ya que su rango está acotado en \([0,1]\). Según los valores de \(\alpha\) y \(\beta\) puede tomar formas muy variadas (simétricas, asimétricas, en forma de U, etc.). Su media y su varianza son
\[ E(X) = \frac{\alpha}{\alpha+\beta}, \qquad Var(X) = \frac{\alpha\beta}{(\alpha+\beta)^2(\alpha+\beta+1)}. \]
La función gamma es una generalización del factorial a los números reales positivos, definida como \(\Gamma(\alpha) = \int_0^{+\infty} t^{\alpha-1}e^{-t}\,dt\). Para enteros positivos cumple \(\Gamma(n) = (n-1)!\).
Ejemplo 2.30 La proporción de individuos que responden positivamente a un tratamiento puede modelarse con una distribución \(\mbox{Beta}(2, 5)\).
# Función de densidad Beta(2, 5)
df <- tibble(x = seq(0, 1, length.out = 300),
             p = dbeta(x, shape1 = 2, shape2 = 5))  # Densidad de probabilidad
# Diagrama de densidad de probabilidad
ggplot(df, aes(x = x, y = p)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  labs(x = "X", y = "Densidad") +
  theme_minimal()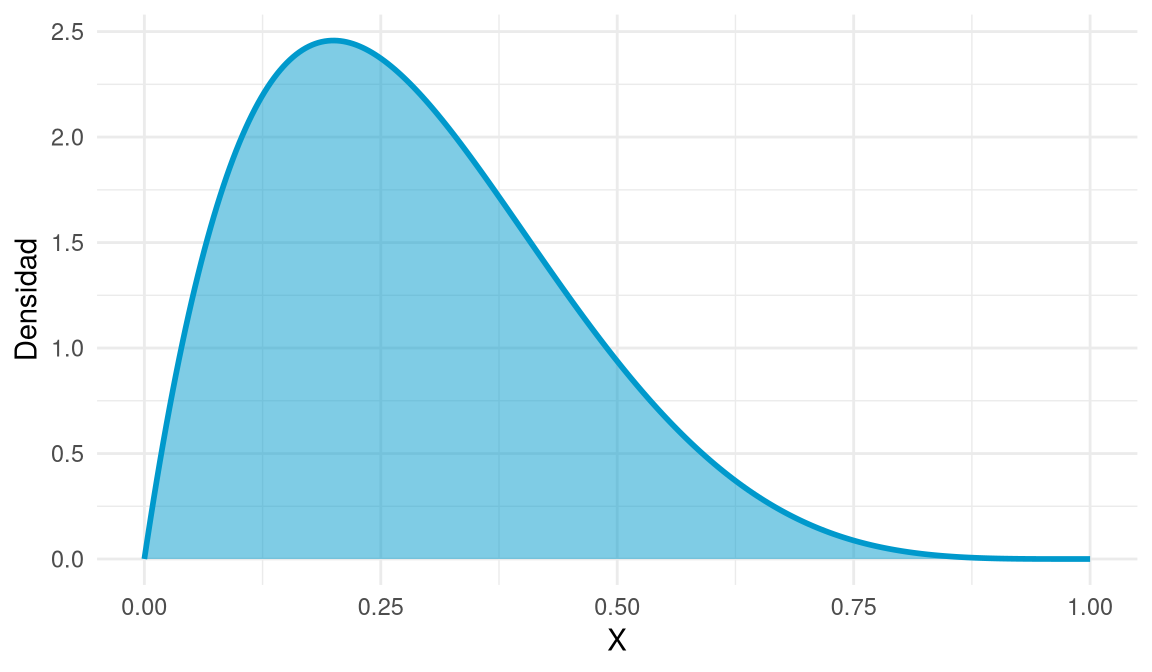
beta_params <- expand.grid(alpha = c(1, 10, 100), beta = c(1, 10, 100))
df_beta <- pmap_dfr(beta_params, function(alpha, beta) {
  tibble(x = seq(0.001, 0.999, length.out = 300),
         y = dbeta(x, shape1 = alpha, shape2 = beta),
         label = factor(paste0("Beta(", alpha, ", ", beta, ")"),
                        levels = paste0("Beta(", beta_params$alpha, ", ", beta_params$beta, ")")))
})

df_beta |>
  ggplot(aes(x = x, y = y)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  facet_wrap(~ label, scales = "free_y", nrow = 3) +
  labs(x = "x", y = NULL) +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))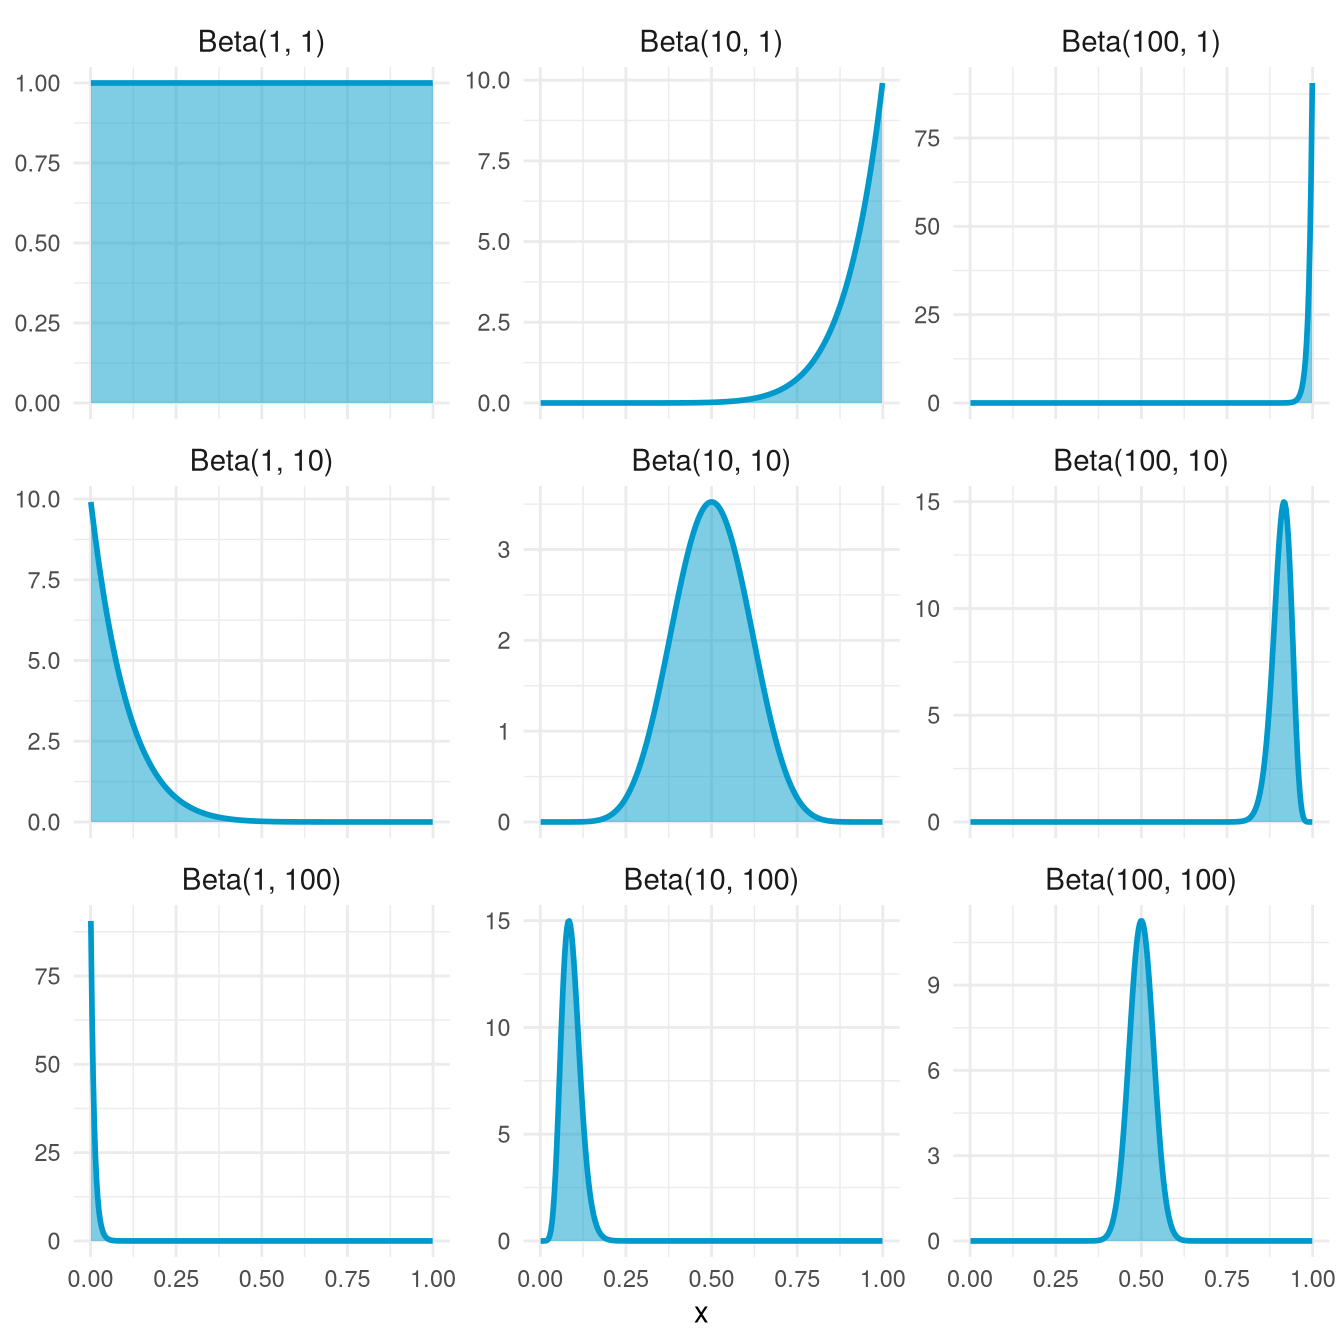
Definición 2.25 (Distribución normal) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución normal, \(X\sim N(\mu, \sigma)\), si su rango es \(\mbox{Ran}(X)=(-\infty,+\infty)\) y su función de densidad es
\[ f(x) = \frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^2}{2\sigma^2}} \quad x\in\mathbb{R}, \]
donde \(\mu\in\mathbb{R}\) es la media y \(\sigma>0\) la desviación típica.
El modelo normal es el más importante de la estadística. Describe muchos fenómenos naturales y, por el teorema central del límite, es la distribución límite de la media de muestras grandes de casi cualquier distribución. Sus estadísticos son
\[ E(X) = \mu \quad \mbox{y} \quad Var(X) = \sigma^2. \]
Ejemplo 2.31 La estatura de los adultos de una población suele seguir una distribución normal \(N(170, 8)\) (en cm).
# Función de densidad N(170, 8)
df <- tibble(x = seq(140, 200, length.out = 300),
             p = dnorm(x, mean = 170, sd = 8)) # Densidad de probabilidad
# Diagrama de densidad de probabilidad
ggplot(df, aes(x = x, y = p)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  scale_x_continuous(breaks = seq(140, 200, by = 10)) +
  labs(x = "Estatura (cm)", y = "Densidad") +
  theme_minimal()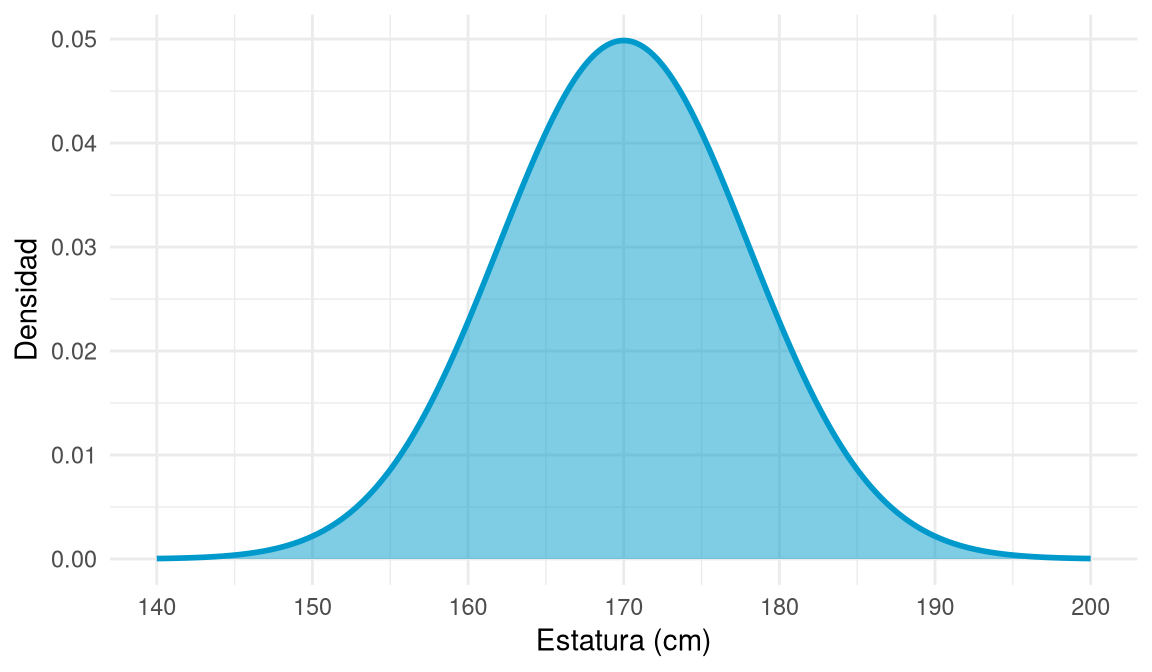
norm_params <- expand.grid(mu = c(0, 20, 100), sigma = c(1, 5, 10))
df_norm <- pmap_dfr(norm_params, function(mu, sigma) {
  tibble(x = seq(mu - 4*sigma, mu + 4*sigma, length.out = 300),
         y = dnorm(x, mean = mu, sd = sigma),
         mu    = factor(paste0("μ = ", mu),    levels = paste0("μ = ", c(0, 20, 100))),
         sigma = factor(paste0("σ = ", sigma), levels = paste0("σ = ", c(1, 5, 10))))
})

df_norm |>
  ggplot(aes(x = x, y = y)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  facet_grid(sigma ~ mu, scales = "free") +
  labs(x = "x", y = NULL) +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))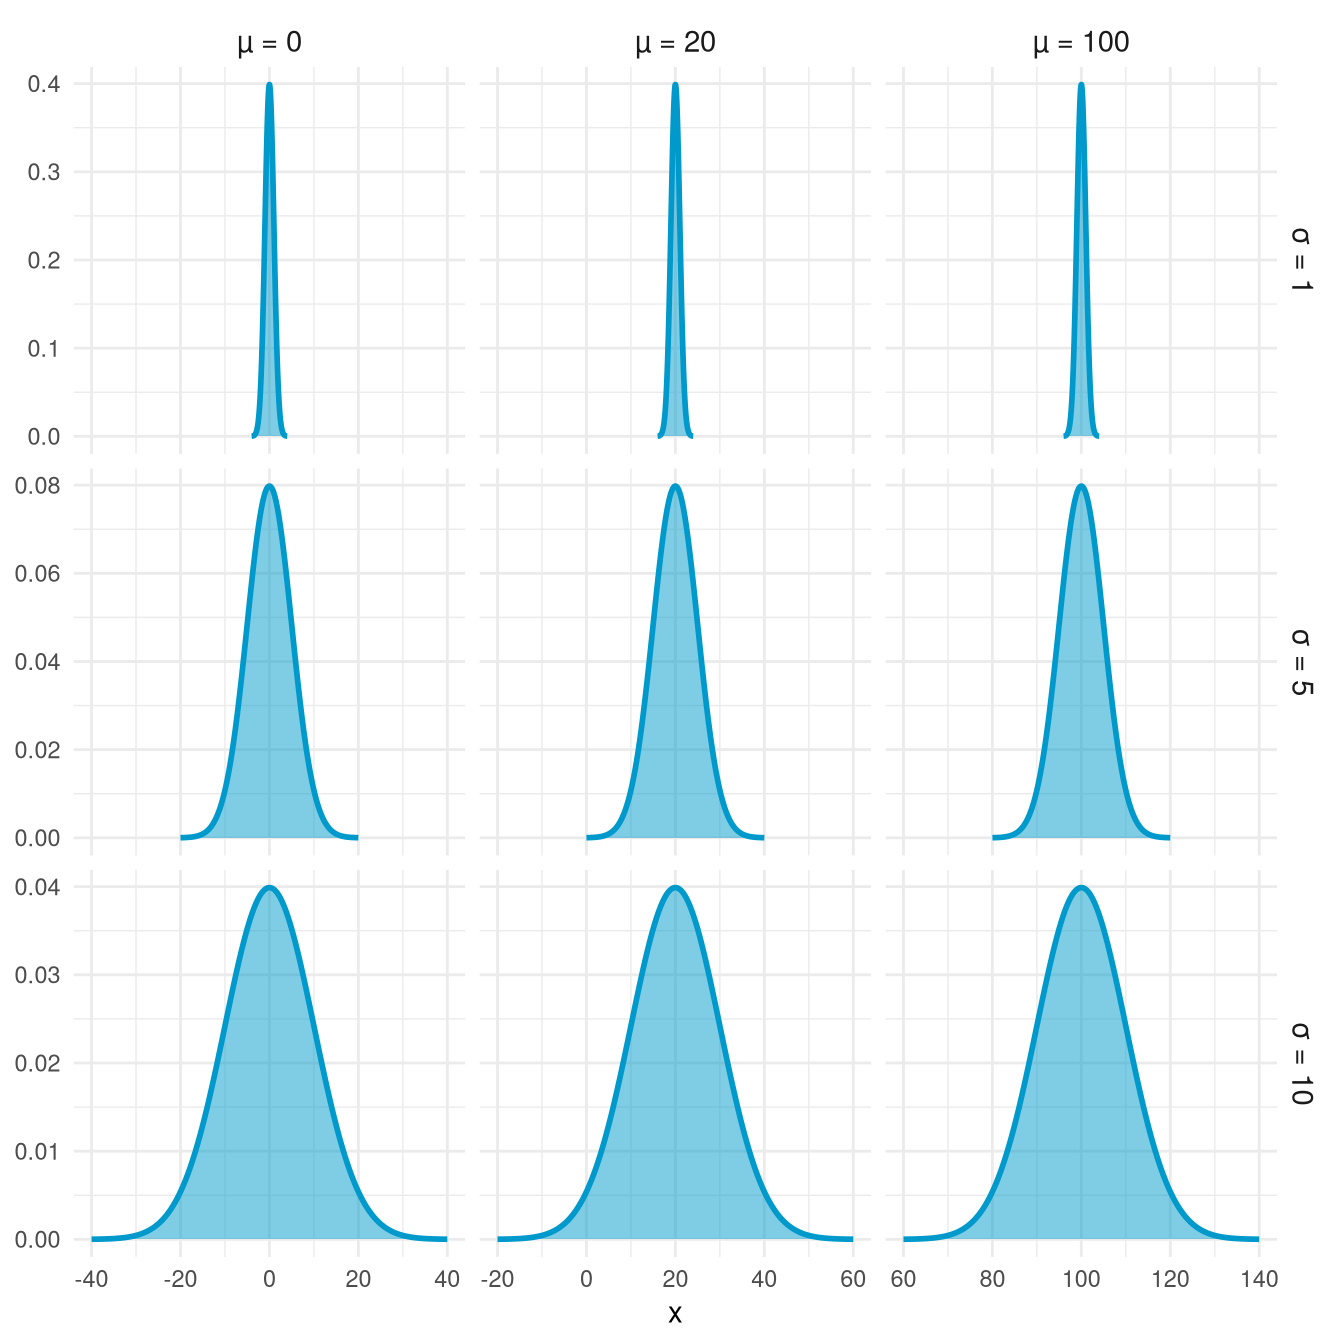
Definición 2.26 (Distribución exponencial) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución exponencial, \(X\sim Exp(\lambda)\), si su rango es \(\mbox{Ran}(X)=(0,+\infty)\) y su función de densidad es
\[ f(x) = \lambda e^{-\lambda x} \quad x>0, \]
donde \(\lambda > 0\) es la tasa de ocurrencia del suceso.
El modelo exponencial se utiliza para modelar tiempos de espera o duraciones positivas, como el tiempo entre llamadas a una centralita o el tiempo de vida de un paciente. Sus estadísticos son
\[ E(X) = \frac{1}{\lambda} \quad \mbox{y} \quad Var(X) = \frac{1}{\lambda^2}. \]
Ejemplo 2.32 Se sabe que la tasa de infecciones por un virus es de 0,2 por día. Entonces, el tiempo hasta que haya una infección sigue una distribución exponencial \(Exp(0{,}2)\).
# Función de densidad Exp(0.2)
df <- tibble(x = seq(0, 30, length.out = 300),
             p = dexp(x, rate = 0.2)) # Densidad de probabilidad
# Diagrama de densidad de probabilidad
ggplot(df, aes(x = x, y = p)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  labs(x = "Tiempo hasta la infección (días)", y = "Densidad") +
  theme_minimal()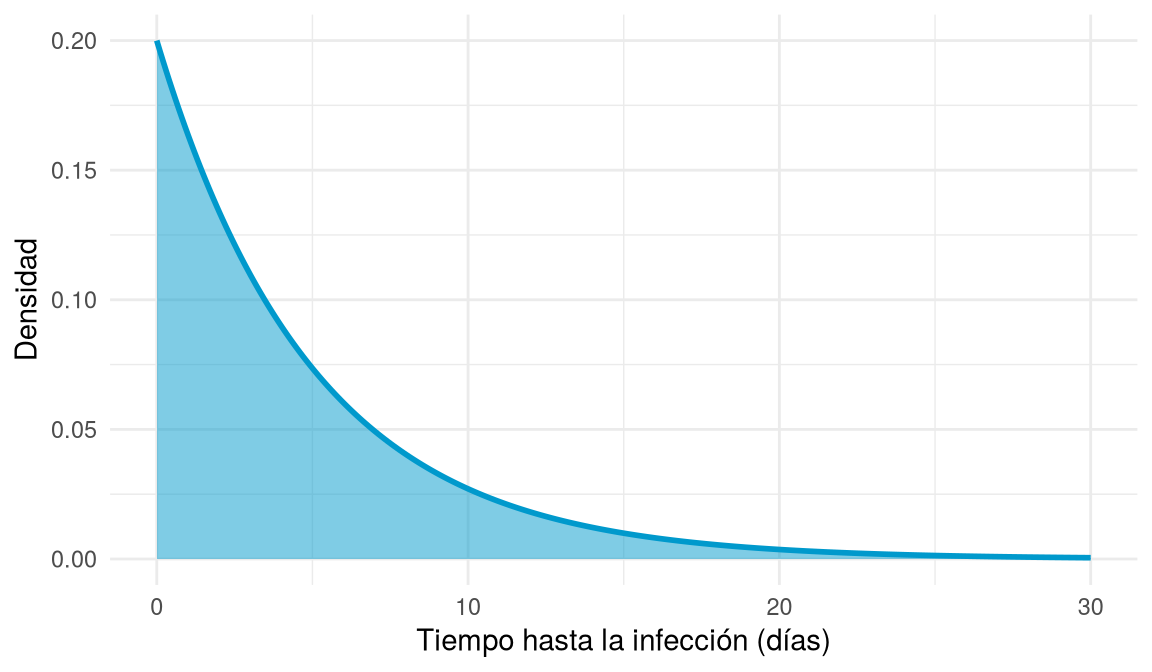
lambdas <- c(0.1, 0.3, 0.5)
df_exp <- tibble(lambda = lambdas) |>
  rowwise() |>
  mutate(x = list(seq(0, qexp(0.99, rate = lambda), length.out = 300)),
         y = list(dexp(x, rate = lambda))) |>
  unnest(cols = c(x, y)) |>
  mutate(label = factor(paste0("λ = ", lambda), levels = paste0("λ = ", lambdas)))

df_exp |>
  ggplot(aes(x = x, y = y)) +
  geom_line(color = myblue) +
  geom_area(fill = myblue, alpha = 0.5) +
  labs(x = "X", y = "Densidad") +
  facet_wrap(~ label, nrow = 1) +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))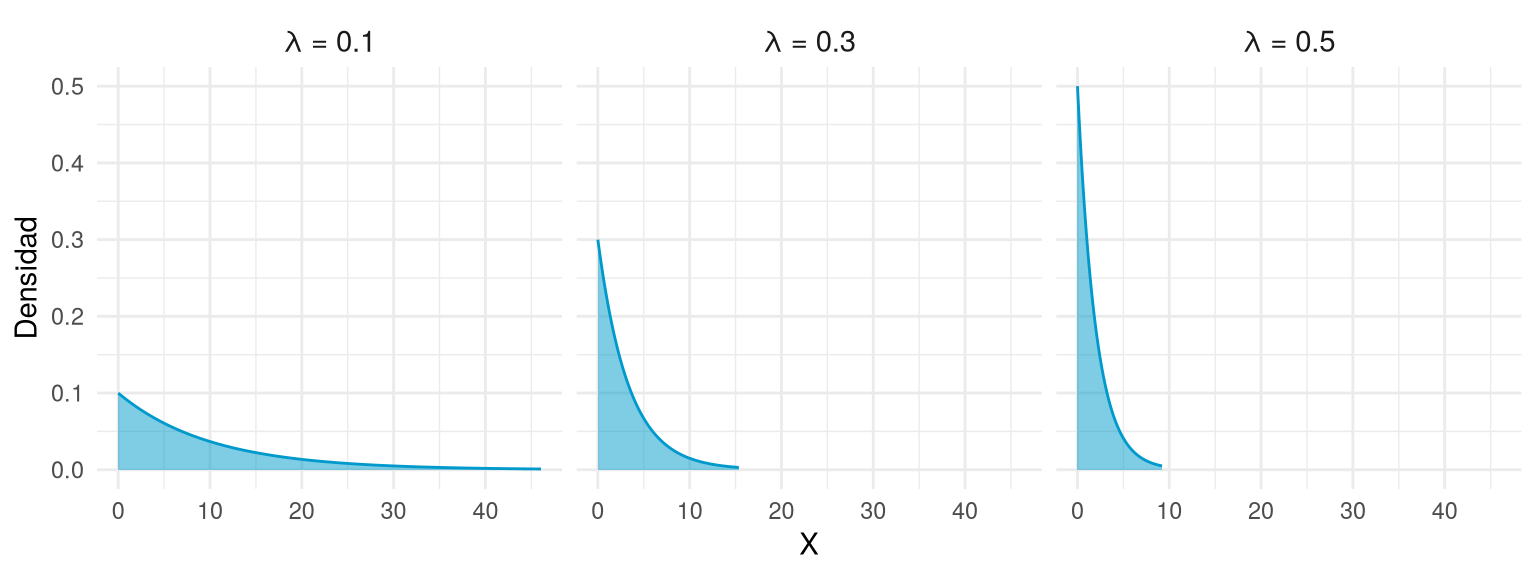
Definición 2.27 (Distribución gamma) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución gamma, \(X\sim \mbox{Gamma}(\alpha, \beta)\), si su rango es \(\mbox{Ran}(X)=(0,+\infty)\) y su función de densidad es
\[ f(x) = \frac{\beta^\alpha}{\Gamma(\alpha)}x^{\alpha-1}e^{-\beta x} \quad x>0, \]
donde \(\alpha>0\) es el parámetro de forma, \(\beta>0\) el parámetro de tasa y \(\Gamma(\alpha)\) la función gamma.
El modelo gamma se utiliza para modelar tiempos de espera o duraciones positivas. Incluye como caso particular la distribución exponencial (\(\alpha=1\)) y, para valores grandes de \(\alpha\), se aproxima a la normal. Sus estadísticos son
\[ E(X) = \frac{\alpha}{\beta} \quad \mbox{y} \quad Var(X) = \frac{\alpha}{\beta^2}. \]
Ejemplo 2.33 El tiempo hasta el tercer contagio de un virus, si los contagios ocurren a una tasa de 2 por hora, sigue una distribución \(\mbox{Gamma}(3, 2)\).
# Función de densidad Gamma(3, 2)
df <- tibble(x = seq(0, 5, length.out = 300),
             p = dgamma(x, shape = 3, rate = 2))
# Diagrama de densidad de probabilidad
ggplot(df, aes(x = x, y = p)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  labs(x = "Tiempo hasta el tercer contagio (horas)", y = "Densidad") +
  theme_minimal()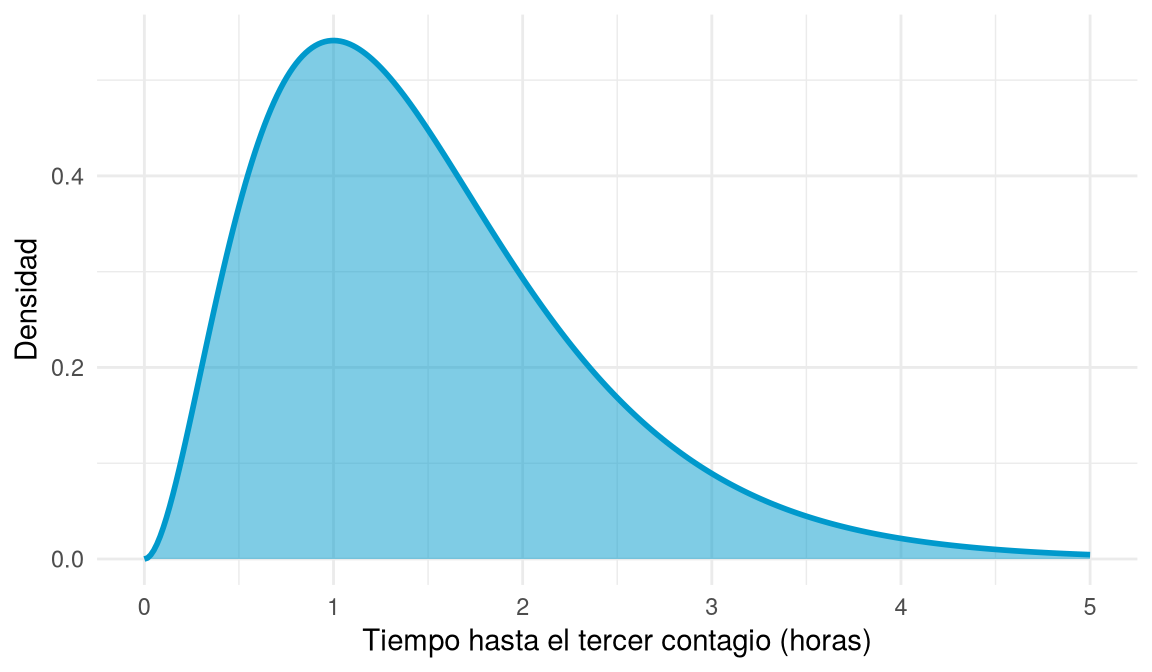
library(ggh4x) # Para facet_grid2
alpha_vals <- c(1, 10, 30)
beta_vals <- c(0.1, 0.2, 0.3)

df_gamma <- expand.grid(alpha = alpha_vals, beta = beta_vals) |>
  pmap_dfr(function(alpha, beta) {
    x_max <- qgamma(0.9999, shape = alpha, rate = beta)
    tibble(x = seq(0.001, x_max, length.out = 300),
           y = dgamma(x, shape = alpha, rate = beta),
           alpha = factor(paste0("α = ", alpha), levels = paste0("α = ", alpha_vals)),
           beta = factor(paste0("β = ", beta), levels = paste0("β = ", beta_vals)))
  })

df_gamma |>
  ggplot(aes(x = x, y = y)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  ggh4x::facet_grid2(alpha ~ beta, scales = "free", independent = "y") +
  labs(x = "X", y = "Densidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))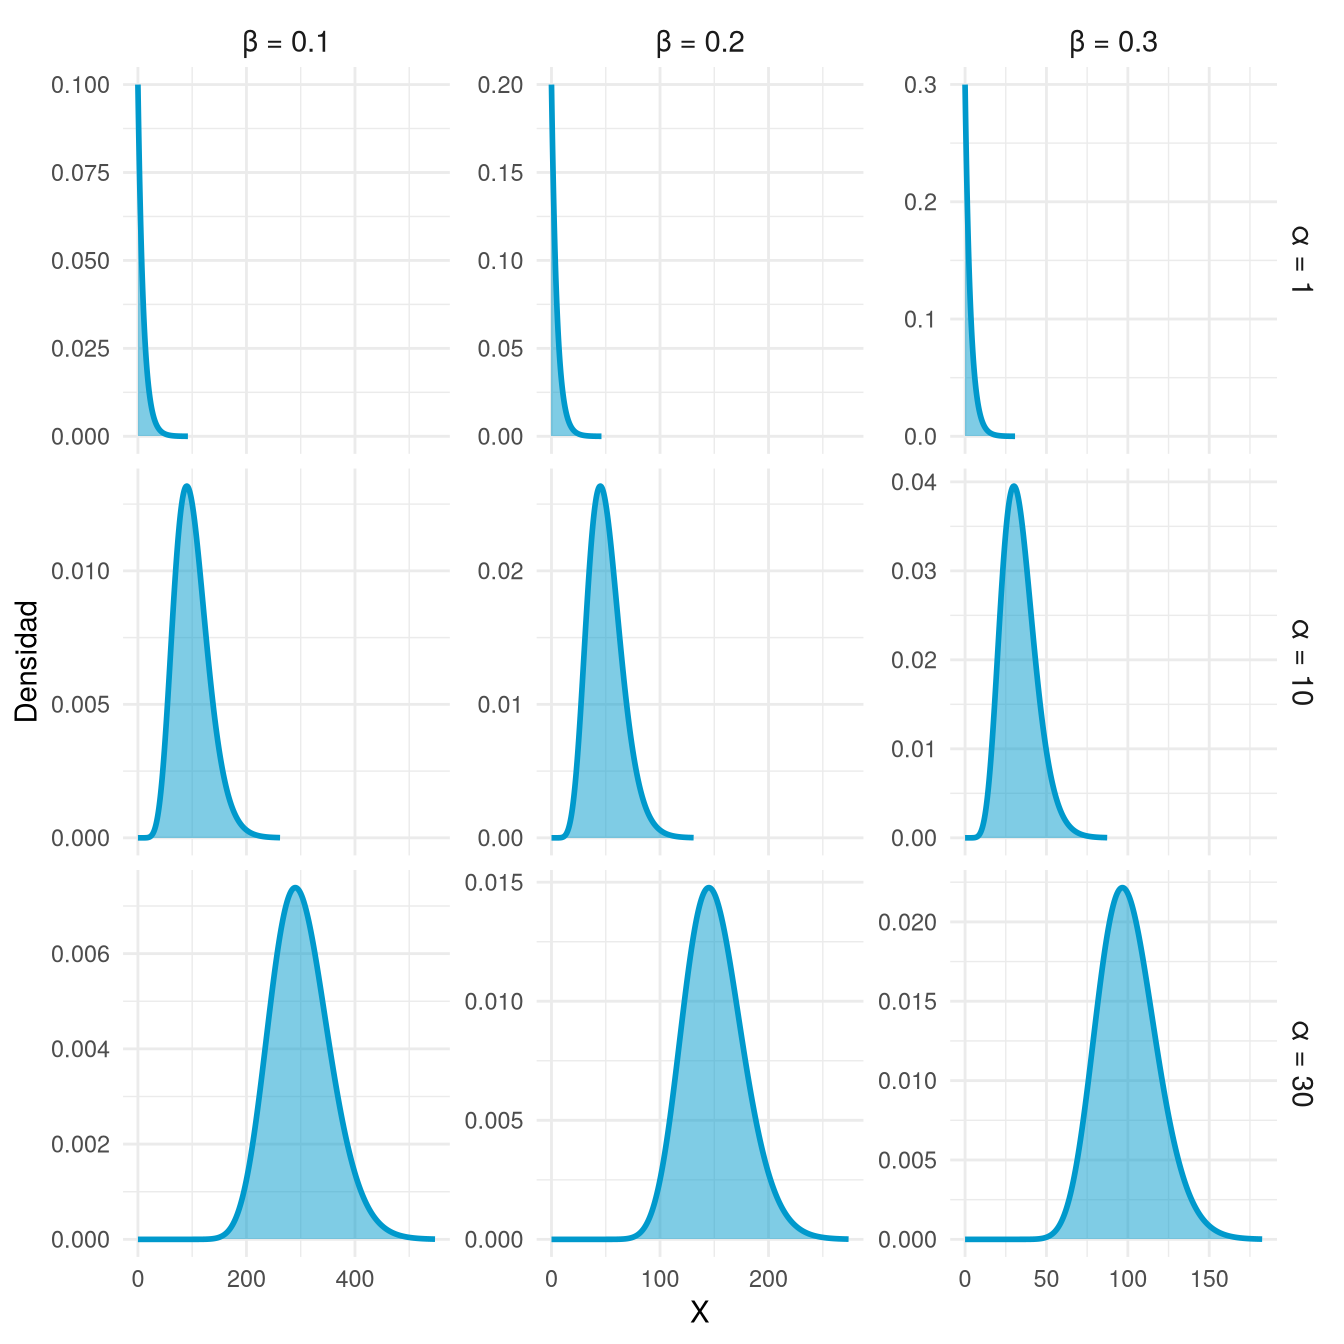
Definición 2.28 (Distribución gamma inversa) Se dice que una variable aleatoria continua \(X\) sigue un modelo de distribución gamma inversa, \(X\sim \mbox{Gamma}^{-1}(\alpha, \beta)\), si su rango es \(\mbox{Ran}(X)=(0,+\infty)\) y su función de densidad es
\[ f(x) = \frac{\beta^{\alpha}}{\Gamma(\alpha)}x^{-\alpha-1}e^{-\beta/x}, \quad x>0, \]
donde \(\alpha>0\) es el parámetro de forma, \(\beta>0\) el parámetro de escala y \(\Gamma(\alpha)\) la función gamma.
Si \(X\sim \mbox{Gamma}(\alpha, \beta)\) (con \(\beta\) como tasa), entonces \(1/X\sim \mbox{Gamma}^{-1}(\alpha, \beta)\). La distribución gamma inversa se utiliza habitualmente para modelar varianzas en estadística bayesiana. Sus estadísticos son
\[ E(X) = \frac{\beta}{\alpha-1} \quad \mbox{y} \quad Var(X) = \frac{\beta^2}{(\alpha-1)^2(\alpha-2)} \quad \mbox{para } \alpha > 2. \]
library(extraDistr)
library(ggh4x) # Para facet_grid2
alpha_vals <- c(5, 10, 15)
beta_vals <- c(1, 5, 10)

df_gamma_inv <- expand.grid(alpha = alpha_vals, beta = beta_vals) |>
  pmap_dfr(function(alpha, beta) {
    x_max <- qinvgamma(0.99, alpha = alpha, beta = beta)
    tibble(x = seq(0.001, x_max, length.out = 300),
           y = dinvgamma(x, alpha = alpha, beta = beta),
           alpha = factor(paste0("α = ", alpha), levels = paste0("α = ", alpha_vals)),
           beta = factor(paste0("β = ", beta), levels = paste0("β = ", beta_vals)))
  })

df_gamma_inv |>
  ggplot(aes(x = x, y = y)) +
  geom_area(fill = myblue, alpha = 0.5) +
  geom_line(color = myblue, linewidth = 1) +
  ggh4x::facet_grid2(alpha ~ beta, scales = "free", independent = "y") +
  labs(x = "X", y = "Densidad") +
  theme_minimal() +
  theme(strip.text = element_text(size = 11))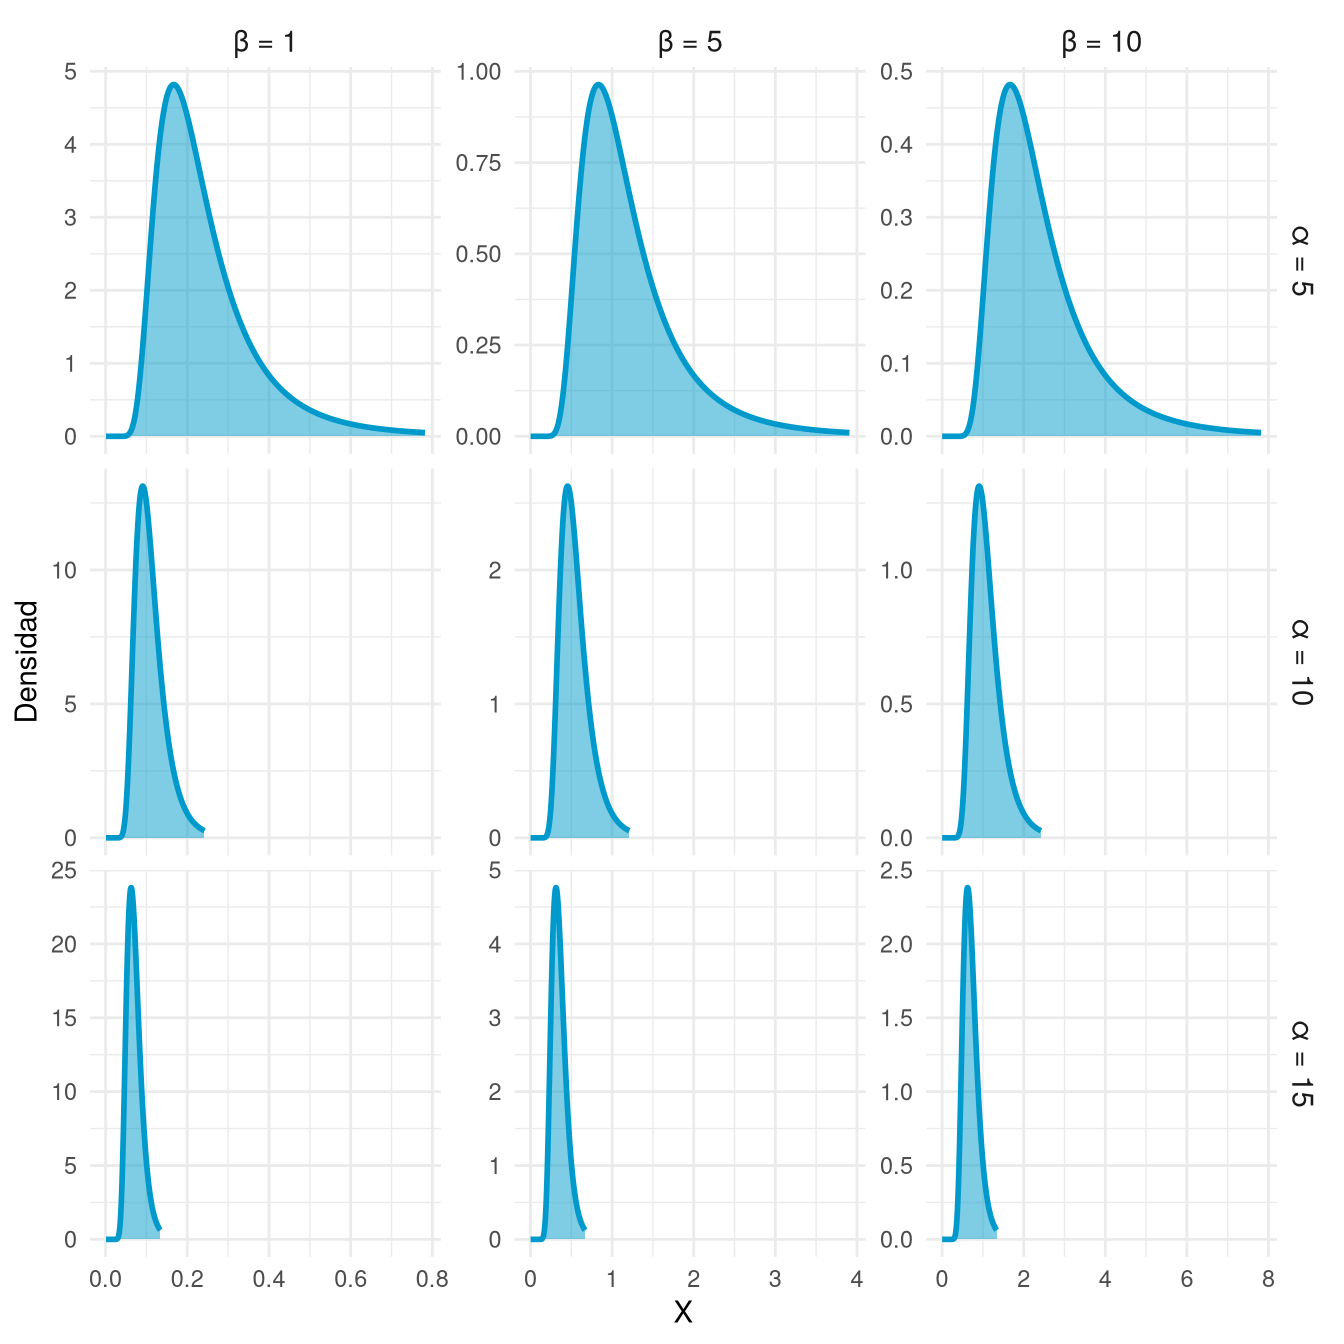
| Distribución | Parámetros | Media | Varianza | Usos habituales |
|---|---|---|---|---|
| Uniforme(\(a, b\)) | \(a < b\) | \(\dfrac{a+b}{2}\) | \(\dfrac{(b-a)^2}{12}\) | Prior no informativo sobre parámetros acotados: probabilidades, proporciones. |
| Beta(\(\alpha, \beta\)) | \(\alpha, \beta > 0\) | \(\dfrac{\alpha}{\alpha+\beta}\) | \(\dfrac{\alpha\beta}{(\alpha+\beta)^2(\alpha+\beta+1)}\) | Prior conjugado para proporciones: prevalencia, sensibilidad, especificidad. |
| Dirichlet(\(\alpha_1,\ldots,\alpha_k\)) | \(\alpha_i > 0\) | \(\dfrac{\alpha_i}{\alpha_0}\) | \(\dfrac{\alpha_i(\alpha_0-\alpha_i)}{\alpha_0^2(\alpha_0+1)}\) | Prior conjugado para vectores de probabilidad: serotipos, mezclas de poblaciones. |
| Normal(\(\mu, \sigma^2\)) | \(\mu \in \mathbb{R},\ \sigma^2 > 0\) | \(\mu\) | \(\sigma^2\) | Prior para medias y coeficientes: presión arterial, colesterol, efectos de tratamiento. |
| \(t\) de Student(\(\nu, \mu, \sigma^2\)) | \(\nu > 0,\ \mu \in \mathbb{R},\ \sigma^2 > 0\) | \(\mu\ (\nu > 1)\) | \(\dfrac{\nu\sigma^2}{\nu-2}\ (\nu > 2)\) | Prior robusto con colas pesadas; marginal de \(\mu\) en el modelo normal-gamma inversa. |
| Cauchy(\(\mu, \sigma\)) | \(\mu \in \mathbb{R},\ \sigma > 0\) | no existe | no existe | Prior de colas muy pesadas para coeficientes en regresión logística. |
| Exponencial(\(\lambda\)) | \(\lambda > 0\) | \(\dfrac{1}{\lambda}\) | \(\dfrac{1}{\lambda^2}\) | Prior débilmente informativo para \(\sigma\) y \(\tau\); tiempo entre eventos con riesgo constante. |
| Gamma(\(\alpha, \beta\)) | \(\alpha, \beta > 0\) | \(\dfrac{\alpha}{\beta}\) | \(\dfrac{\alpha}{\beta^2}\) | Prior conjugado para tasas Poisson: incidencia, mortalidad. |
| Gamma inversa(\(\alpha, \beta\)) | \(\alpha, \beta > 0\) | \(\dfrac{\beta}{\alpha-1}\ (\alpha > 1)\) | \(\dfrac{\beta^2}{(\alpha-1)^2(\alpha-2)}\ (\alpha > 2)\) | Prior conjugado para varianzas \(\sigma^2\); varianza de efectos aleatorios. |
| Lognormal(\(\mu, \sigma^2\)) | \(\mu \in \mathbb{R},\ \sigma^2 > 0\) | \(e^{\mu+\sigma^2/2}\) | \(\left(e^{\sigma^2}-1\right)e^{2\mu+\sigma^2}\) | Parámetros positivos asimétricos: dosis, concentraciones, tiempos de supervivencia. |
| Weibull(\(k, \lambda\)) | \(k, \lambda > 0\) | \(\lambda\,\Gamma\!\left(1+\tfrac{1}{k}\right)\) | \(\lambda^2\!\left[\Gamma\!\left(1+\tfrac{2}{k}\right)-\Gamma\!\left(1+\tfrac{1}{k}\right)^2\right]\) | Modelos de supervivencia: tiempo hasta la muerte, recaída o fracaso de tratamiento. |
Ejercicio 2.4 ¿Qué tipo de distribución de probabilidad utilizarías para modelar las siguientes variables aleatorias?
El proceso de obtener valores de una variable aleatoria mediante la realización de un experimento aleatorio se conoce como muestreo. Cuando la selección de los valores se hace de manera independiente y con la misma distribución, se dice que se ha realizado un muestreo aleatorio simple.
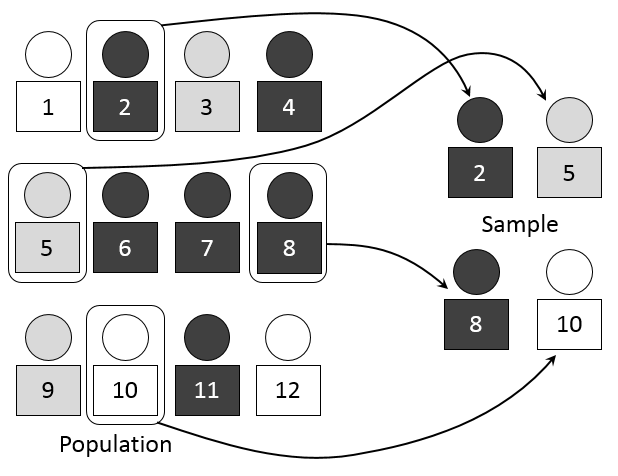
Para realizar un muestreo aleatorio simple de una variable aleatoria discreta con un número finito de valores se puede usar la función sample de R.
sample
Devuelve una muestra aleatoria de los elementos de un vector dado, con o sin reemplazamiento, y con probabilidades asociadas a cada elemento.
Parámetros:
x: vector de valores a muestrear.size: número de valores a muestrear.prob: vector de probabilidades asociadas a cada valor de x. Si no se especifica, se asume que todos los valores tienen la misma probabilidad.replace: TRUE indica que el muestreo es con reemplazo, mientras que FALSE implica que el muestreo es sin reemplazo.Ejemplo 2.34 El siguiente código realiza un muestreo aleatorio simple de tamaño 10 del resultado de lanzar una moneda equilibrada, es decir, con probabilidades iguales para cara y cruz.
set.seed(123) # Para reproducibilidad
# Valores posibles: Cara ("C") y Cruz ("X")
x <- c("C", "X")
# Probabilidades asociadas a cada valor
p <- c(0.5, 0.5)
# Muestreo aleatorio simple de tamaño 10
sample(x, size = 10, prob = p, replace = TRUE)
[1] "X" "C" "X" "C" "C" "X" "C" "C" "C" "X"Si la moneda estuviera trucada, por ejemplo con una probabilidad de cara de 0,8 y de cruz de 0,2, se tendría:
# Probabilidades asociadas a cada valor
p <- c(0.8, 0.2)
# Muestreo aleatorio simple de tamaño 10
sample(x, size = 10, prob = p, replace = TRUE)
[1] "X" "C" "C" "C" "C" "X" "C" "C" "C" "X"Otra opción para tomar muestras aleatorias de un data frame es la función slice_sample del paquete dplyr.
slice_sample
Devuelve una muestra aleatoria de tamaño determinado de un data frame o tibble.
Parámetros:
.data: data frame o tibble del que se quiere tomar la muestra.n: número de filas a muestrear.weight_by: nombre de la columna que contiene las probabilidades asociadas a cada fila. Si no se especifica, se asume que todas las filas tienen la misma probabilidad.replace: TRUE indica que el muestreo es con reemplazo, mientras que FALSE implica que el muestreo es sin reemplazo.El mismo ejemplo anterior puede replicarse con este código:
set.seed(123)
tibble(x = c("C", "X"), p = c(0.8, 0.2)) |>
  slice_sample(n = 10, weight_by = p, replace = TRUE)
# A tibble: 10 × 2
x p
<chr> <dbl>
1 C 0.8
2 C 0.8
3 C 0.8
4 X 0.2
5 X 0.2
6 C 0.8
7 C 0.8
8 X 0.2
9 C 0.8
10 C 0.8Para realizar un muestreo aleatorio simple de una variable aleatoria con distribución binomial se puede usar la función rbinom de R.
rbinom
Devuelve una muestra aleatoria de una distribución binomial.
Parámetros:
n: tamaño de la muestra.size: número de repeticiones o ensayos.prob: probabilidad de éxito para cada ensayo.Ejemplo 2.35 Se sabe que el porcentaje de fumadores en una población es del 20 %. Vamos a realizar un muestreo aleatorio simple de tamaño 20 del número de fumadores en muestras aleatorias de 10 personas.
set.seed(123) # Para reproducibilidad
n <- 10  # Número de repeticiones
p <- 0.2 # Probabilidad de éxito (fumador)
# Muestreo aleatorio simple de la distribución binomial
df <- tibble(x = rbinom(n = 20, size = n, prob = p))
df$x
[1] 1 3 2 4 4 0 2 4 2 2 4 2 2 2 0 4 1 0 1 4# Distribución binomial teórica
df_binom <- tibble(x = 0:n, p = dbinom(0:n, size = n, prob = p))
ggplot(df, aes(x = x)) +
# Diagrama de barras de la distribución muestral
geom_bar(aes(y = after_stat(count / sum(count))), fill = myblue, width = 0.2) +
# Distribución de probabilidad del modelo binomial
geom_point(data = df_binom, aes(x = x, y = p), color = myred, size = 2) +
scale_x_continuous(breaks = 0:n) +
labs(x = "Número de fumadores", y = "Frecuencia relativa / Probabilidad") +
theme_minimal()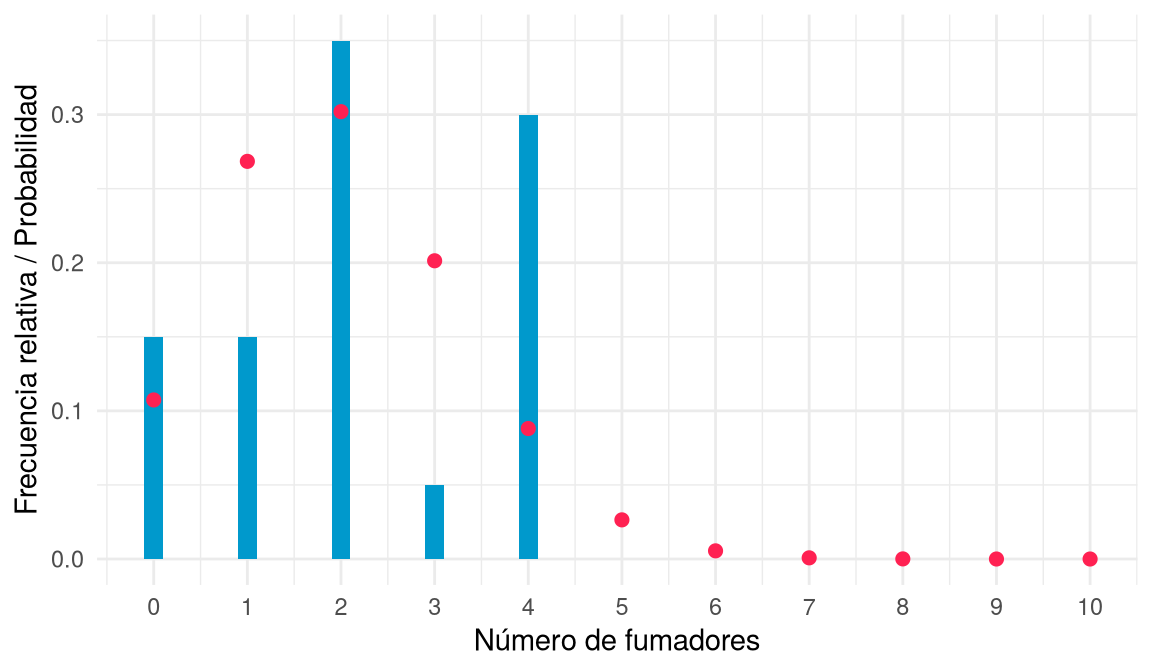
Para tamaños muestrales pequeños, la distribución de frecuencias muestral es muy diferente a la distribución de probabilidad del modelo binomial \(B(10, 0{,}2)\). Pero para tamaños muestrales grandes, la distribución de frecuencias del muestreo se aproxima a la distribución de probabilidad del modelo:
df <- tibble(x = rbinom(n = 10000, size = n, prob = p))
# Distribución binomial teórica
df_binom <- tibble(x = 0:n, p = dbinom(0:n, size = n, prob = p))
ggplot(df, aes(x = x)) +
  geom_bar(aes(y = after_stat(count / sum(count))), fill = myblue, width = 0.2) +
  geom_point(data = df_binom, aes(x = x, y = p), color = myred, size = 2) +
  scale_x_continuous(breaks = 0:n) +
  labs(x = "Número de fumadores", y = "Frecuencia relativa / Probabilidad") +
  theme_minimal()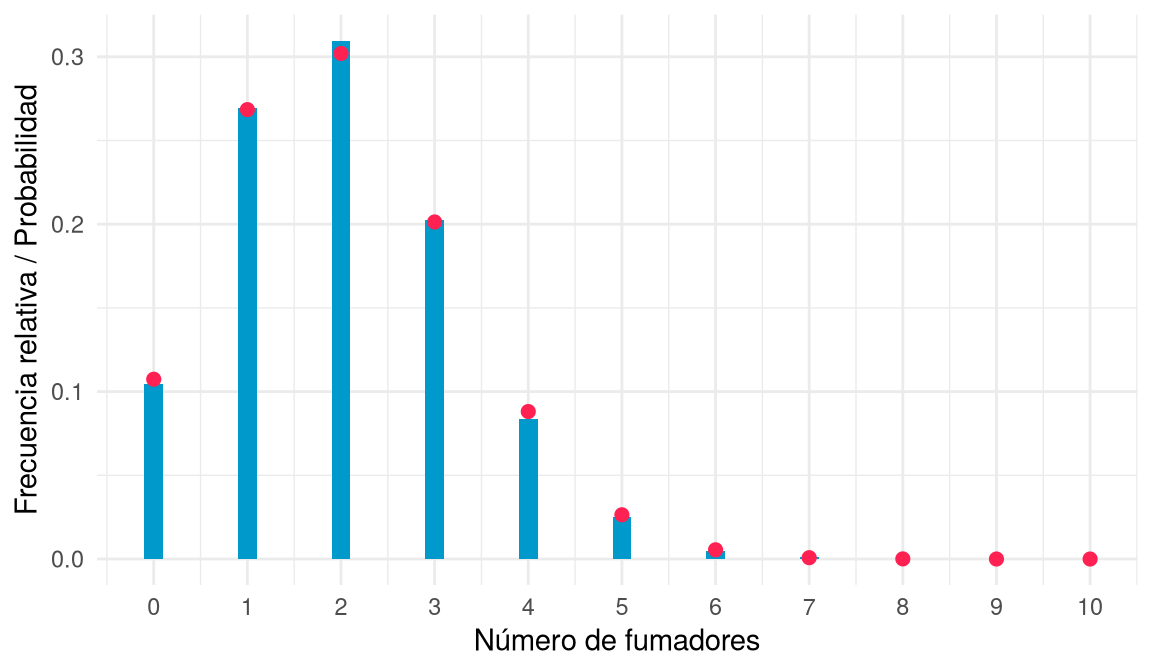
Para realizar un muestreo aleatorio simple de una variable aleatoria con distribución geométrica se puede usar la función rgeom de R, cuyos parámetros son n (tamaño de la muestra) y prob (probabilidad de éxito en cada ensayo).
Ejemplo 2.36 La probabilidad de que un paciente responda favorablemente a un tratamiento es del 30 %. Tomamos una muestra aleatoria de tamaño 10000 del número de pacientes no respondedores tratados hasta obtener el primer éxito.
set.seed(123) # Para reproducibilidad
p <- 0.3 # Probabilidad de éxito
# Muestreo aleatorio simple de la distribución geométrica
df <- tibble(x = rgeom(n = 10000, prob = p))
# Distribución geométrica teórica
x_max <- max(df$x)
df_geom <- tibble(x = 0:x_max, p = dgeom(0:x_max, prob = p))
ggplot(df, aes(x = x)) +
  geom_bar(aes(y = after_stat(count / sum(count))), fill = myblue, width = 0.2) +
  geom_point(data = df_geom, aes(x = x, y = p), color = myred, size = 2) +
  scale_x_continuous(breaks = 0:x_max) +
  labs(x = "Número de fracasos antes del primer éxito", y = "Frecuencia relativa / Probabilidad") +
  theme_minimal()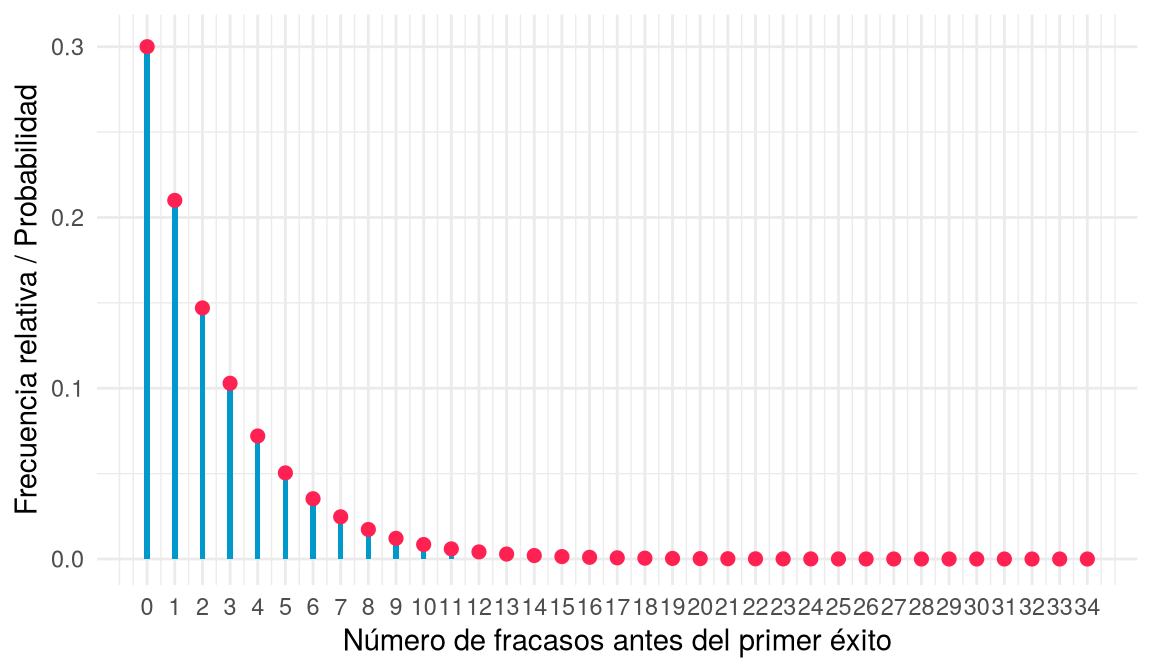
Para realizar un muestreo aleatorio simple de una variable aleatoria con distribución de Poisson se puede usar la función rpois de R, cuyos parámetros son n (tamaño de la muestra) y lambda (número medio de ocurrencias).
Ejemplo 2.37 El número medio de infartos que se producen diariamente en una ciudad es 5. Tomamos una muestra aleatoria de tamaño 10000 del número de infartos diarios.
set.seed(123)
lambda <- 5  # Media
df <- tibble(x = rpois(n = 10000, lambda = lambda))
x_max <- max(df$x)
df_pois <- tibble(x = 0:x_max, p = dpois(0:x_max, lambda = lambda))
ggplot(df, aes(x = x)) +
  geom_bar(aes(y = after_stat(count / sum(count))), fill = myblue, width = 0.2) +
  geom_point(data = df_pois, aes(x = x, y = p), color = myred, size = 2) +
  scale_x_continuous(breaks = 0:x_max) +
  labs(x = "Número de infartos", y = "Frecuencia relativa / Probabilidad") +
  theme_minimal()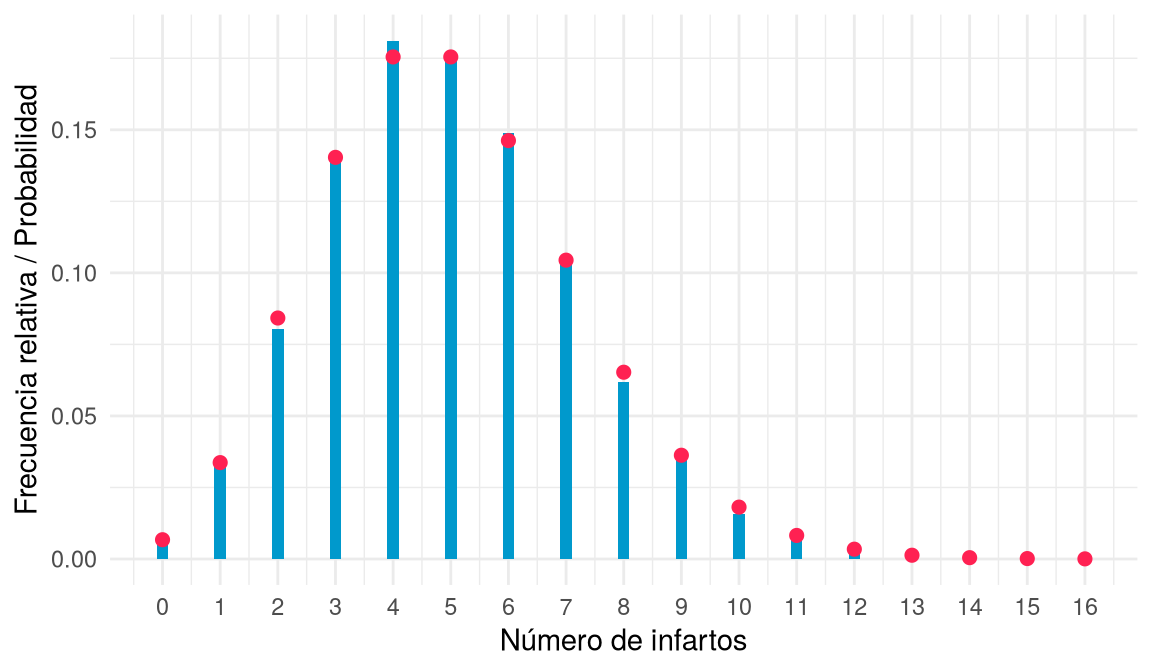
Para muestrear una variable con distribución uniforme continua se usa la función runif, con los parámetros n, min y max.
Ejemplo 2.38 El tiempo de espera de un autobús que pasa cada 20 minutos sigue una distribución \(U(0, 20)\). Tomamos una muestra aleatoria de tamaño 10000 del tiempo de espera.
set.seed(123)
df <- tibble(x = runif(n = 10000, min = 0, max = 20))
ggplot(df, aes(x = x)) +
  geom_area(stat = "density", fill = myblue, alpha = 0.5, bounds = c(0, 20)) +
  geom_line(stat = "density", color = myblue, linewidth = 1, bounds = c(0, 20)) +
  geom_hline(yintercept = 1/20, color = myred, linewidth = 1) +
  labs(x = "Tiempo de espera (minutos)", y = "Densidad") +
  theme_minimal()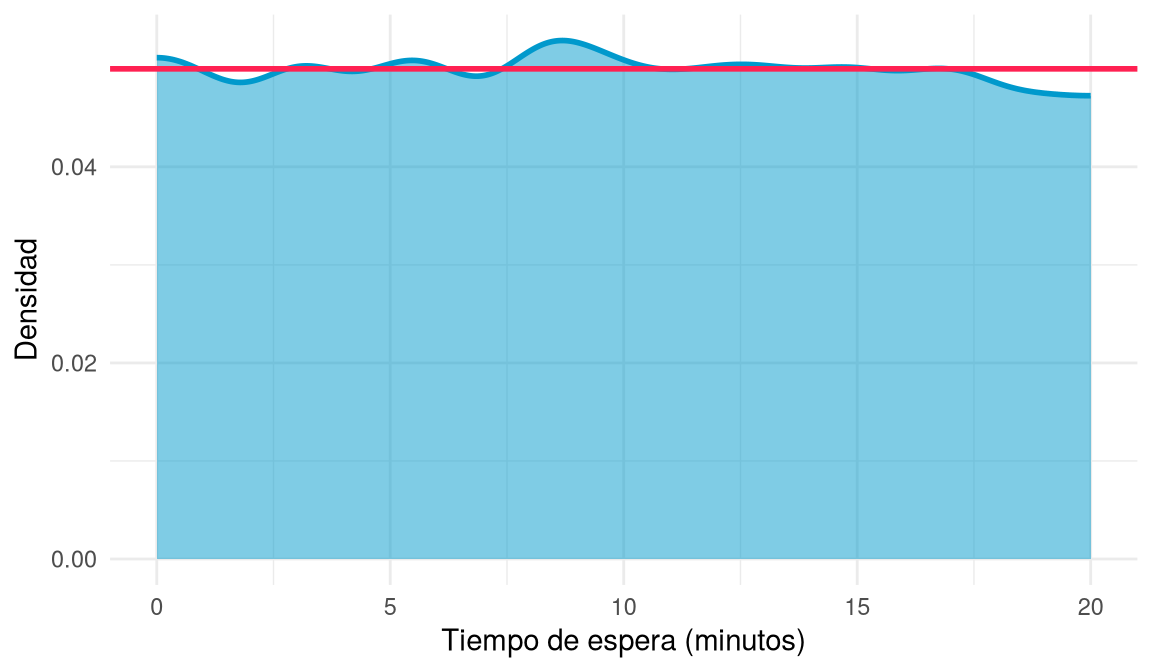
Para muestrear una variable con distribución beta se usa la función rbeta, con los parámetros n, shape1 (\(\alpha\)) y shape2 (\(\beta\)).
Ejemplo 2.39 La proporción de individuos que responden positivamente a un tratamiento puede modelarse con una distribución \(\mbox{Beta}(2, 5)\). Tomamos una muestra aleatoria de tamaño 10000 de esta distribución.
set.seed(123)
n <- 10000  # Tamaño de la muestra
shape1 <- 2 # Parámetro de forma α
shape2 <- 5 # Parámetro de forma β
# Muestreo aleatorio simple de la distribución beta
df <- tibble(x = rbeta(n = n, shape1 = shape1, shape2 = shape2))
# Distribución beta teórica
df_beta <- tibble(x = seq(0, 1, length.out = 300),
                  p = dbeta(x, shape1 = shape1, shape2 = shape2))
ggplot(df, aes(x = x)) +
  geom_area(stat = "density", fill = myblue, alpha = 0.5) +
  geom_line(stat = "density", color = myblue, linewidth = 1) +
  geom_line(data = df_beta, aes(x = x, y = p), color = myred, linewidth = 1) +
  labs(x = "Proporción de respuestas positivas", y = "Densidad") +
  theme_minimal()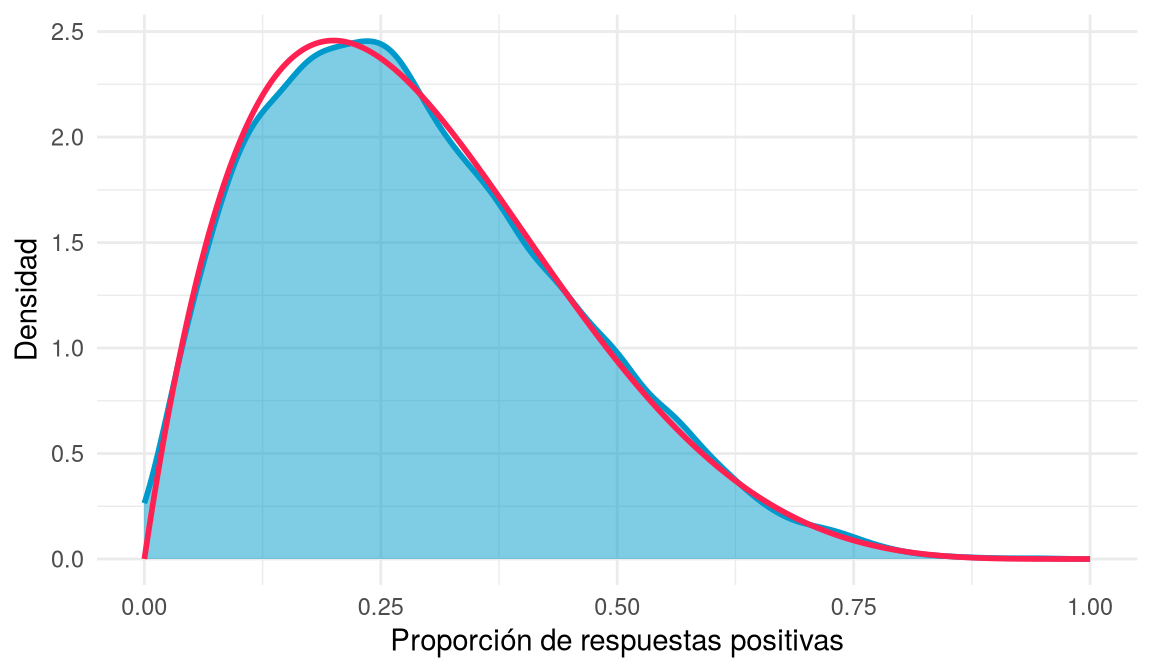
Para muestrear una variable con distribución normal se usa la función rnorm, con los parámetros n, mean (\(\mu\)) y sd (\(\sigma\)).
Ejemplo 2.40 La estatura de los adultos de una población suele seguir una distribución \(N(170, 8)\) (en cm). Tomamos una muestra aleatoria de tamaño 10000 de esta distribución.
set.seed(123)
n <- 10000  # Tamaño de la muestra
mean <- 170 # Media μ
sd <- 8     # Desviación típica σ
# Muestreo aleatorio simple de la distribución normal
df <- tibble(x = rnorm(n = n, mean = mean, sd = sd))
# Distribución normal teórica
df_norm <- tibble(x = seq(140, 200, length.out = 300),
                  p = dnorm(x, mean = mean, sd = sd))
ggplot(df, aes(x = x)) +
  geom_area(stat = "density", fill = myblue, alpha = 0.5) +
  geom_line(stat = "density", color = myblue, linewidth = 1) +
  geom_line(data = df_norm, aes(x = x, y = p), color = myred, linewidth = 1) +
  scale_x_continuous(breaks = seq(140, 200, by = 10)) +
  labs(x = "Estatura (cm)", y = "Densidad") +
  theme_minimal()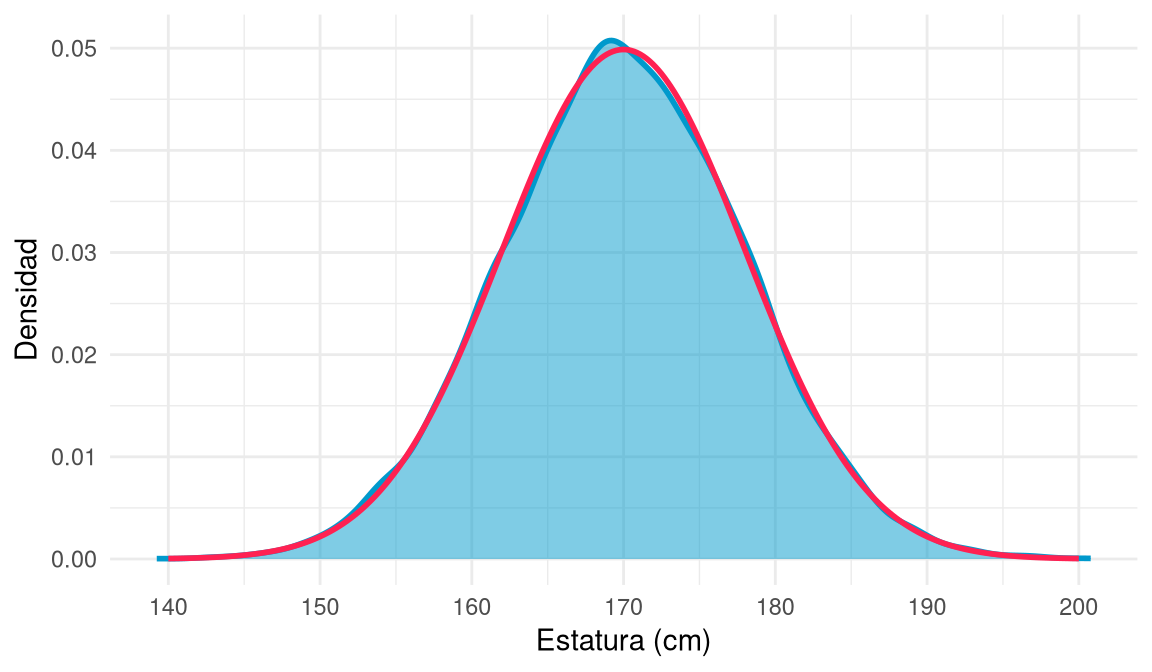
Para muestrear una variable con distribución exponencial se usa la función rexp, con los parámetros n y rate (\(\lambda\)).
Ejemplo 2.41 El tiempo hasta la infección por un virus sigue una distribución \(Exp(0{,}2)\). Tomamos una muestra aleatoria de tamaño 10000 de esta distribución.
set.seed(123)
n <- 10000  # Tamaño de la muestra
rate <- 0.2 # Tasa de ocurrencia λ
# Muestreo aleatorio simple de la distribución exponencial
df <- tibble(x = rexp(n = n, rate = rate))
# Distribución exponencial teórica
x_max <- qexp(0.999, rate = rate)
df_exp <- tibble(x = seq(0, x_max, length.out = 300), p = dexp(x, rate = rate))
ggplot(df, aes(x = x)) +
  geom_area(stat = "density", fill = myblue, alpha = 0.5, bounds = c(0, x_max)) +
  geom_line(stat = "density", color = myblue, linewidth = 1, bounds = c(0, x_max)) +
  geom_line(data = df_exp, aes(x = x, y = p), color = myred, linewidth = 1) +
  labs(x = "Tiempo hasta la infección (días)", y = "Densidad") +
  theme_minimal()
Warning: Some data points are outside of `bounds`. Removing them.
Some data points are outside of `bounds`. Removing them.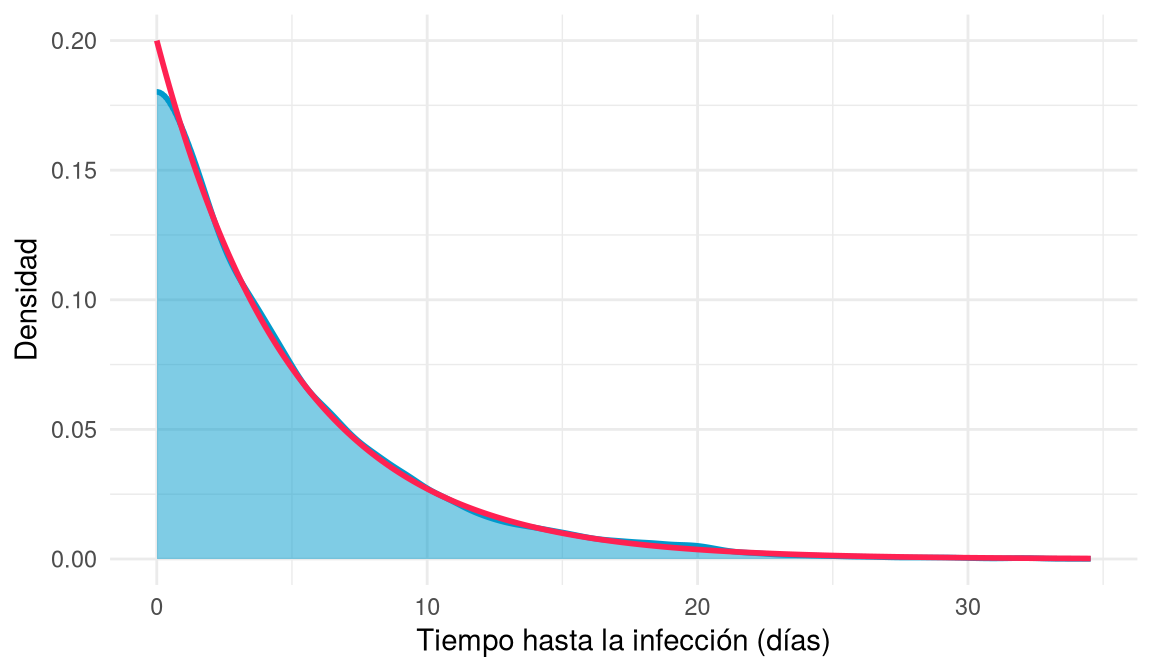
Para muestrear una variable con distribución gamma se usa la función rgamma, con los parámetros n, shape (\(\alpha\)) y rate (\(\beta\)).
Ejemplo 2.42 El tiempo hasta el tercer contagio de un virus, si los contagios ocurren a una tasa de 2 por hora, sigue una distribución \(\mbox{Gamma}(3, 2)\). Tomamos una muestra aleatoria de tamaño 10000 de esta distribución.
set.seed(123)
n <- 10000  # Tamaño de la muestra
shape <- 3 # Parámetro de forma α
rate <- 2  # Parámetro de tasa β
# Muestreo aleatorio simple de la distribución gamma
df <- tibble(x = rgamma(n = n, shape = shape, rate = rate))
# Distribución gamma teórica
x_max <- qgamma(0.999, shape = shape, rate = rate)
df_gamma <- tibble(x = seq(0, x_max, length.out = 300),
                   p = dgamma(x, shape = shape, rate = rate))
ggplot(df, aes(x = x)) +
  geom_area(stat = "density", fill = myblue, alpha = 0.5) +
  geom_line(stat = "density", color = myblue, linewidth = 1) +
  geom_line(data = df_gamma, aes(x = x, y = p), color = myred, linewidth = 1) +
  labs(x = "Tiempo hasta el tercer contagio (horas)", y = "Densidad") +
  theme_minimal()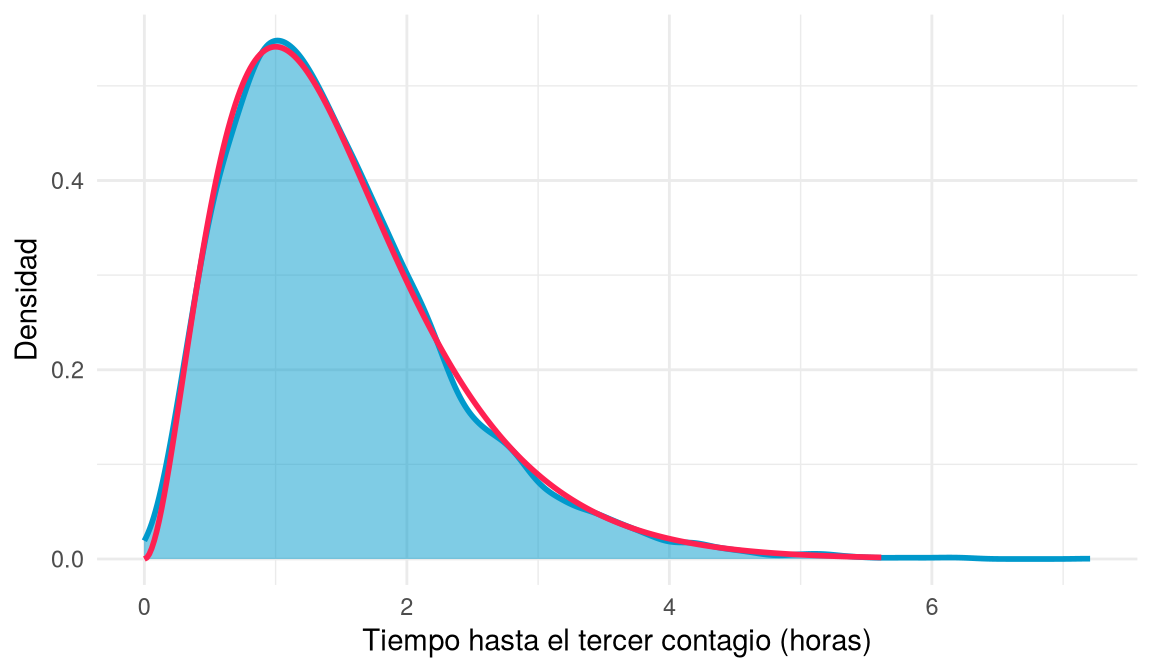
Ejercicio 2.5 En una población hay un 30 % de personas fumadoras. Se sabe que la prevalencia de cáncer de pulmón es del 10 % en fumadoras y del 1 % en no fumadoras.
set.seed(123)
tibble(x = rbinom(n = 20, size = 100, prob = 0.1)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Número de personas con cáncer en 100 fumadoras",
       x = "Número de personas con cáncer", y = "Frecuencia relativa")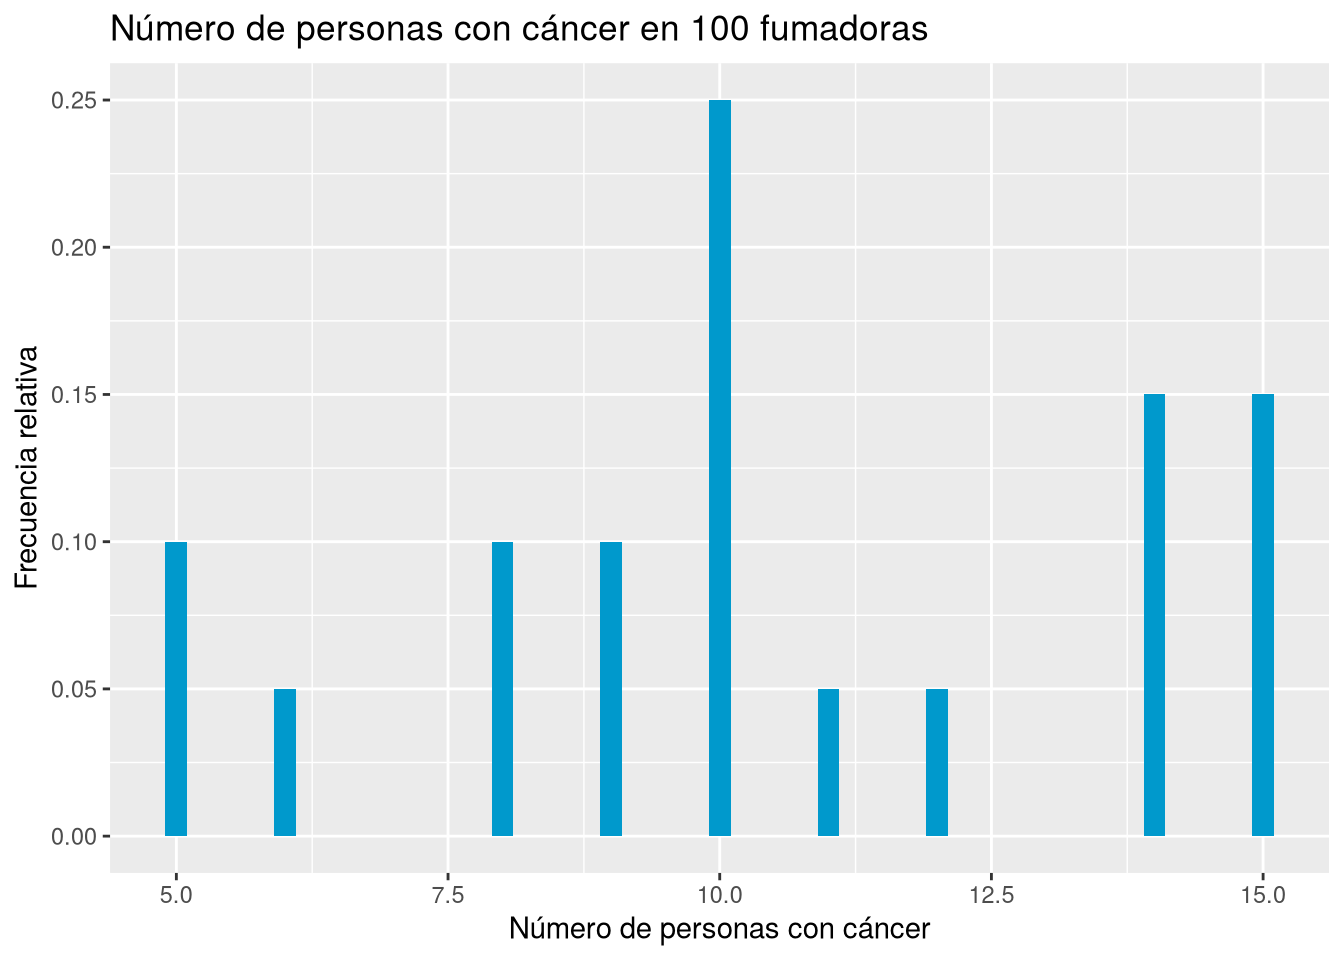
tibble(x = rbinom(n = 20, size = 100, prob = 0.01)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Número de personas con cáncer en 100 no fumadoras",
       x = "Número de personas con cáncer", y = "Frecuencia relativa")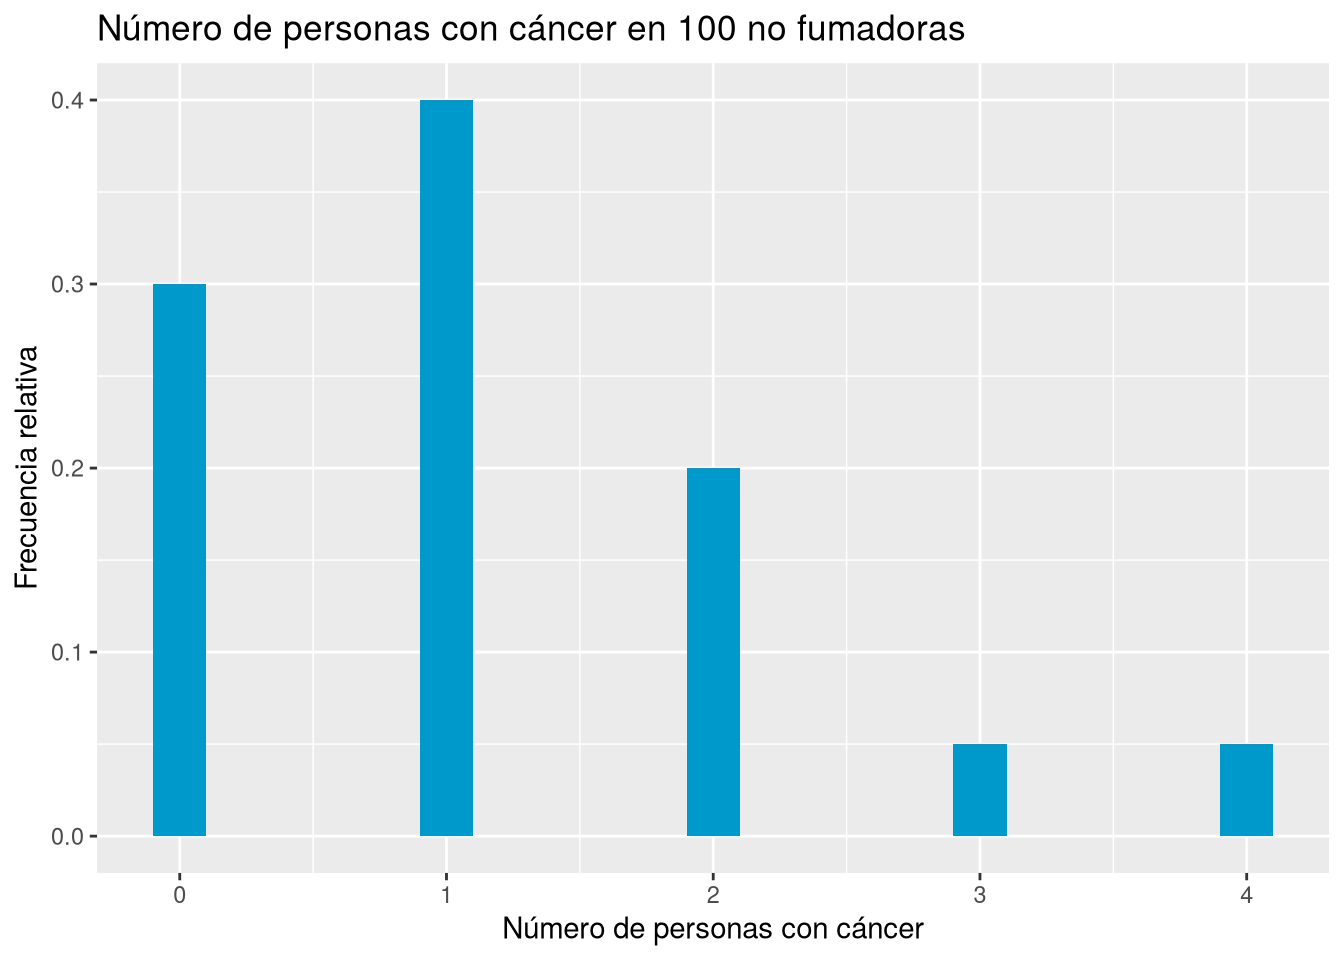
# Cada muestra de 100 personas: primero el número de fumadoras y después los casos en cada grupo
set.seed(123)
tibble(fumadoras = rbinom(n = 20, size = 100, prob = 0.3)) |>
  mutate(x = rbinom(n = n(), size = fumadoras, prob = 0.1) +
               rbinom(n = n(), size = 100 - fumadoras, prob = 0.01)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Casos de cáncer en muestras de 100 personas",
       x = "Número de personas con cáncer", y = "Frecuencia relativa")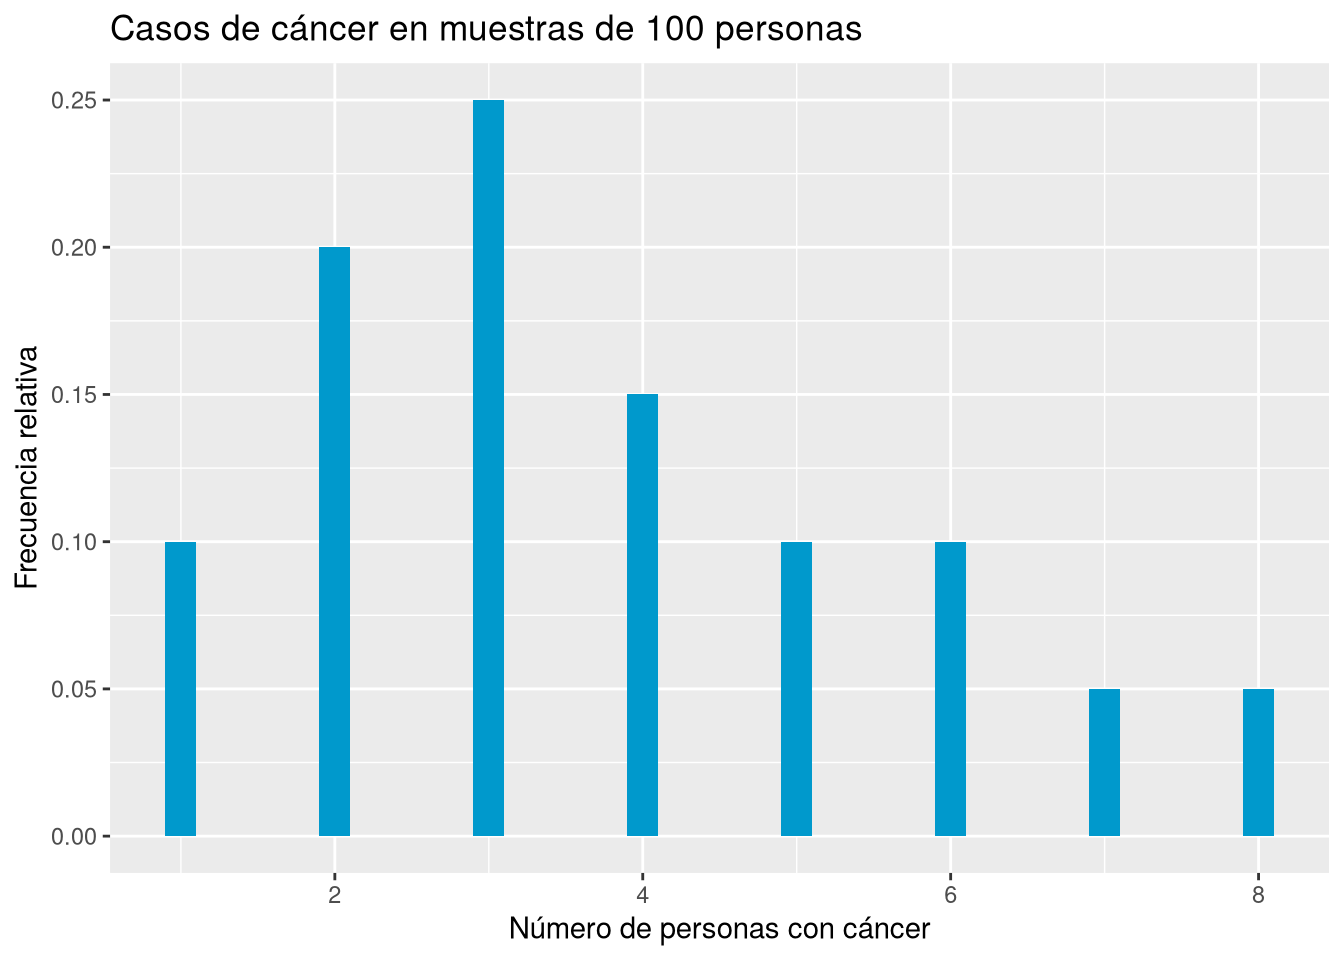
set.seed(123)
tibble(fumadoras = rbinom(n = 10000, size = 100, prob = 0.3)) |>
  mutate(x = rbinom(n = n(), size = fumadoras, prob = 0.1) +
               rbinom(n = n(), size = 100 - fumadoras, prob = 0.01)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Casos de cáncer en 10000 muestras de 100 personas",
       x = "Número de personas con cáncer", y = "Frecuencia relativa")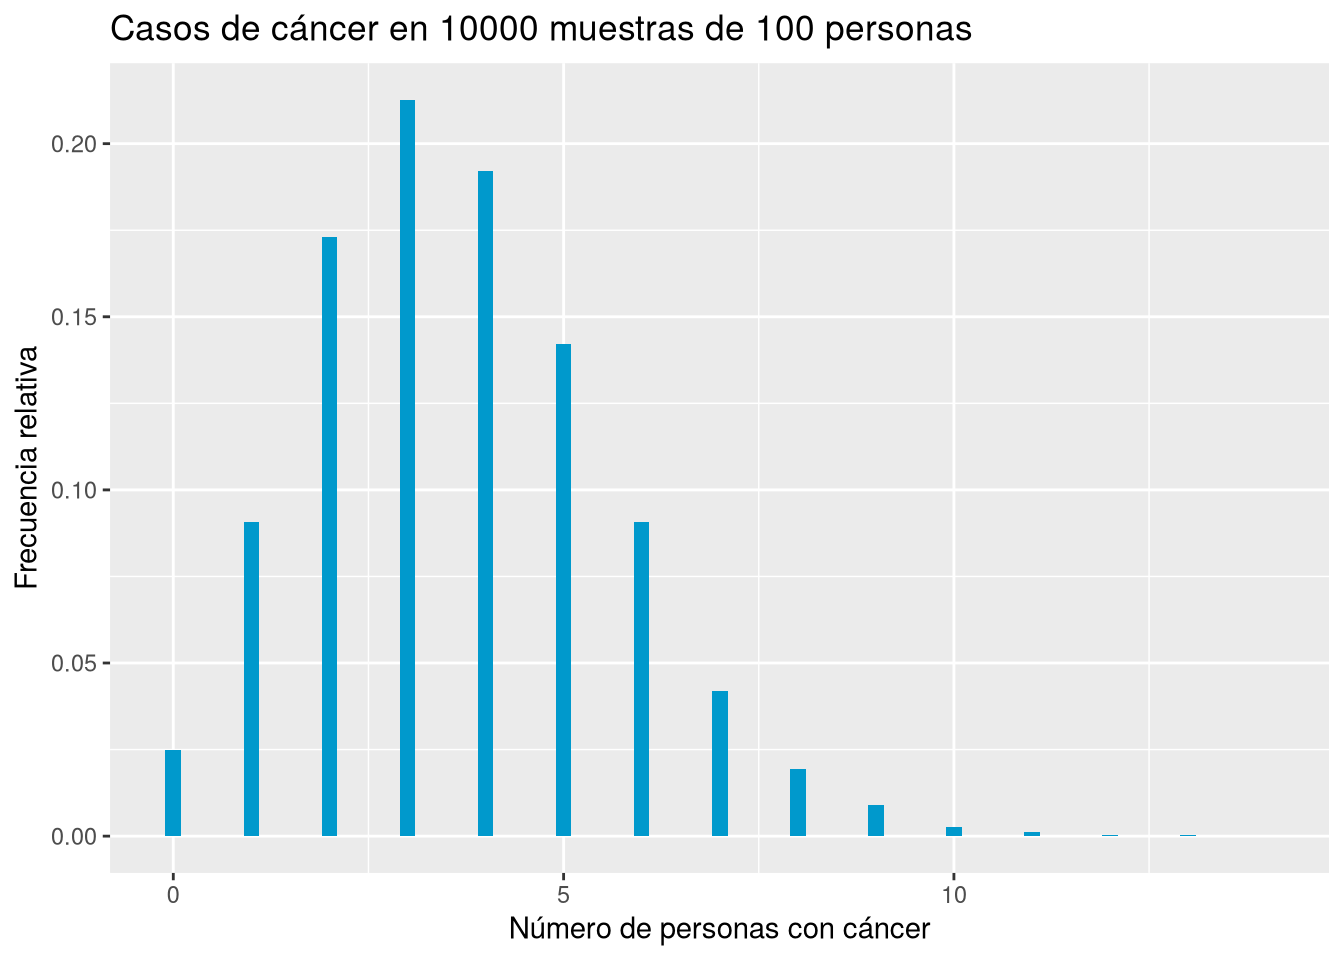
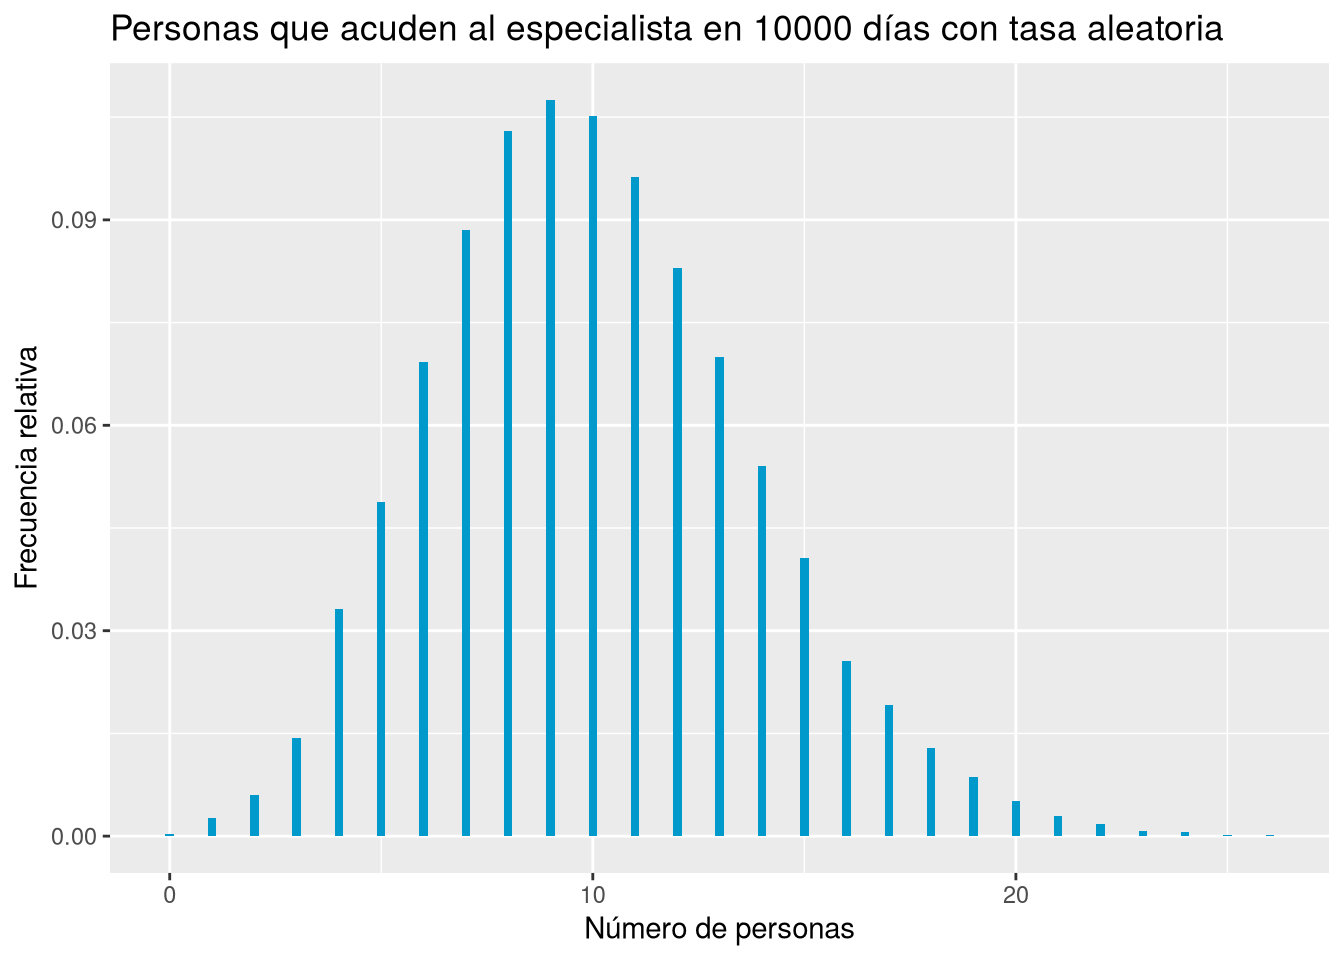
Ejercicio 2.6 La tasa diaria de personas que acuden a un especialista en un hospital sigue una distribución normal de media 10 y desviación típica 2.
set.seed(123)
tibble(x = rpois(n = 30, lambda = 10)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Personas que acuden al especialista en 30 días con tasa 10",
       x = "Número de personas", y = "Frecuencia relativa")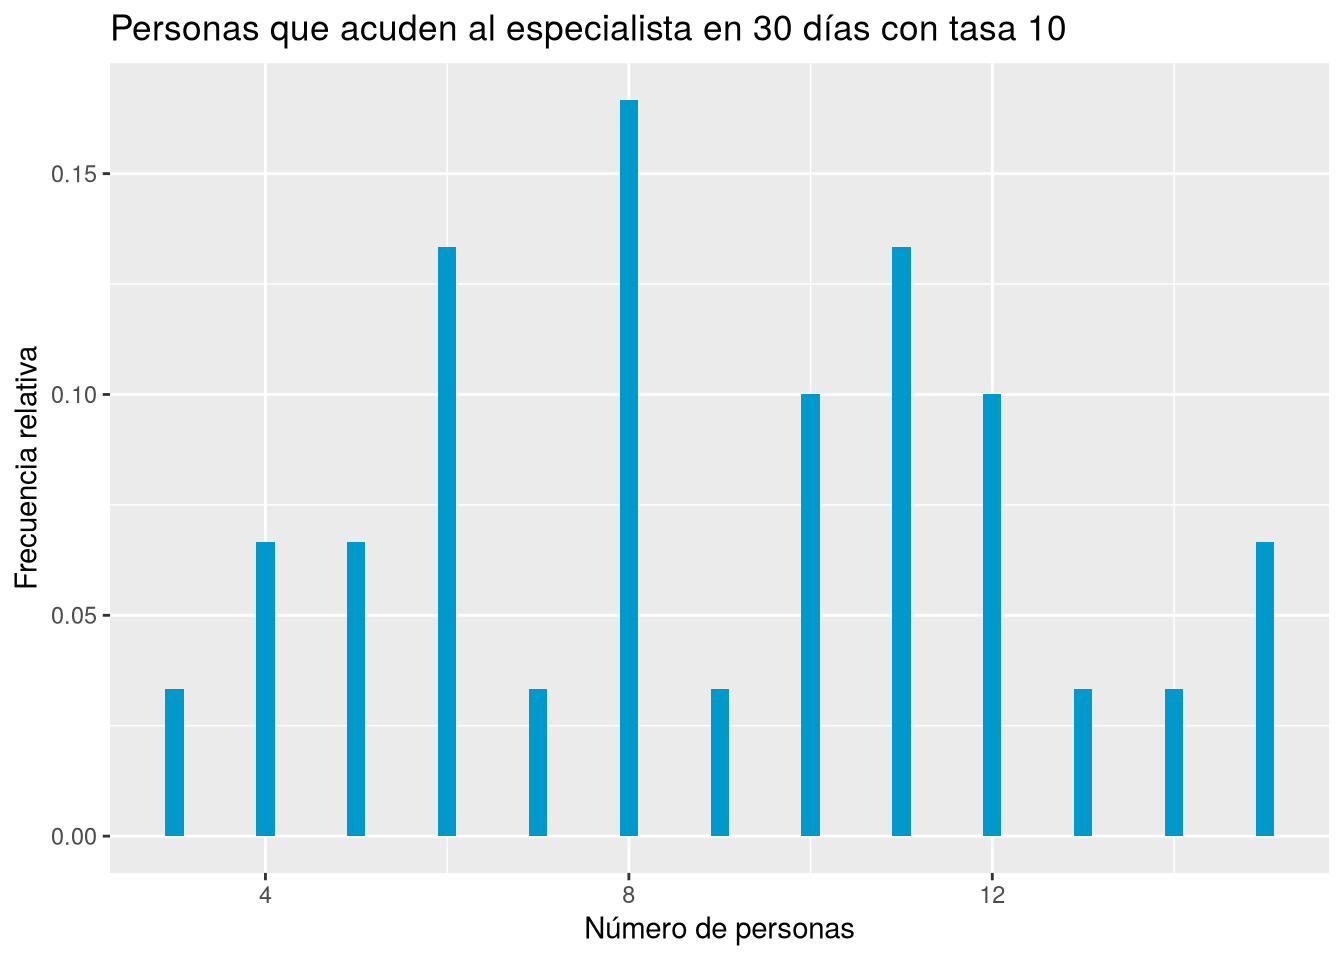
set.seed(123)
tibble(lambda = rnorm(n = 30, mean = 10, sd = 2)) |>
  mutate(x = rpois(n = n(), lambda = lambda)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Personas que acuden al especialista en 30 días con tasa aleatoria",
       x = "Número de personas", y = "Frecuencia relativa")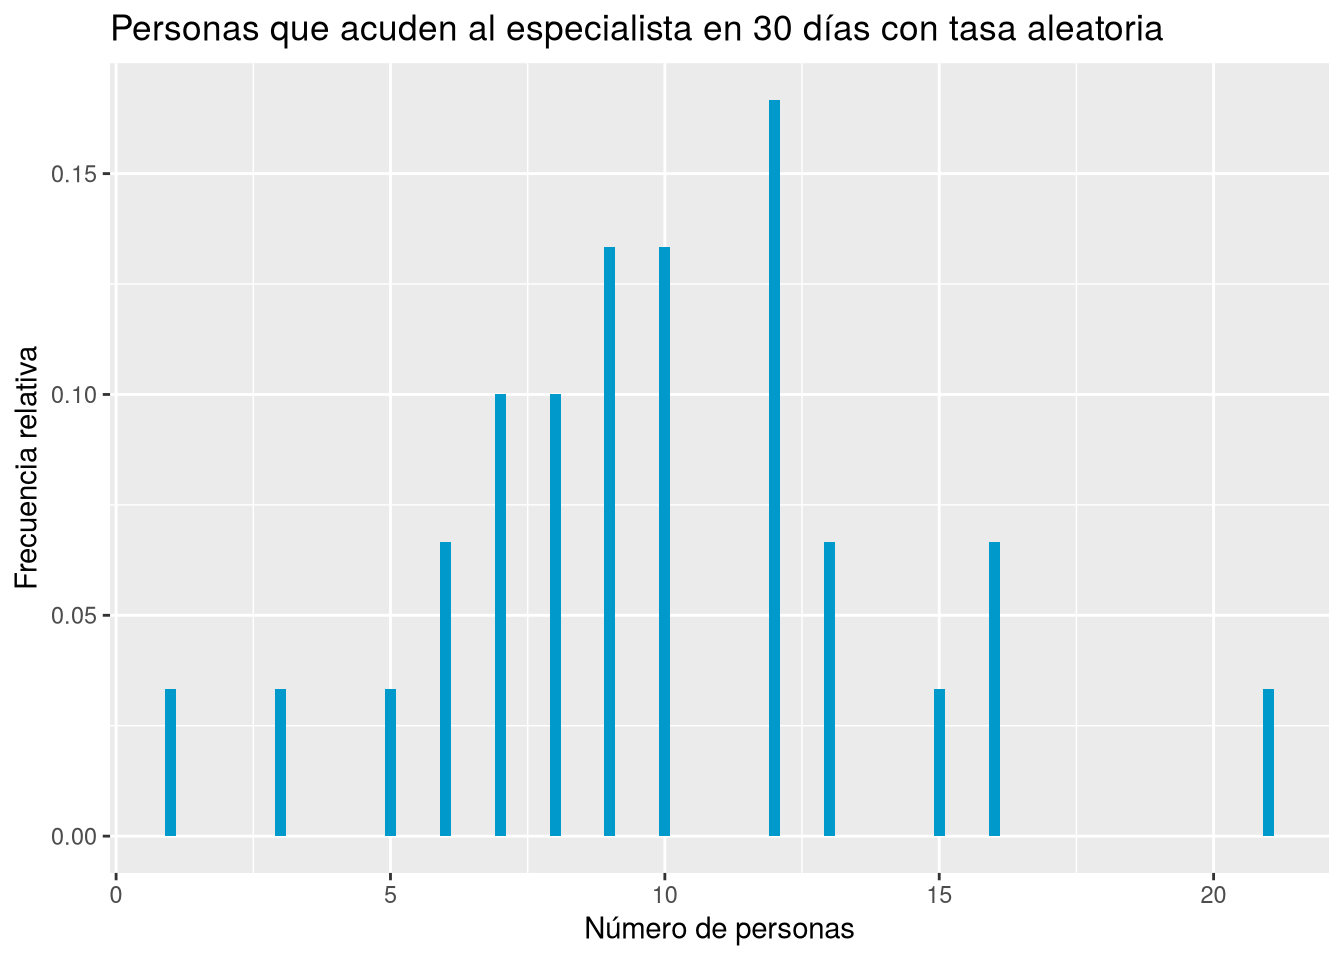
set.seed(123)
tibble(x = rpois(n = 10000, lambda = 10)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Personas que acuden al especialista en 10000 días con tasa 10",
       x = "Número de personas", y = "Frecuencia relativa")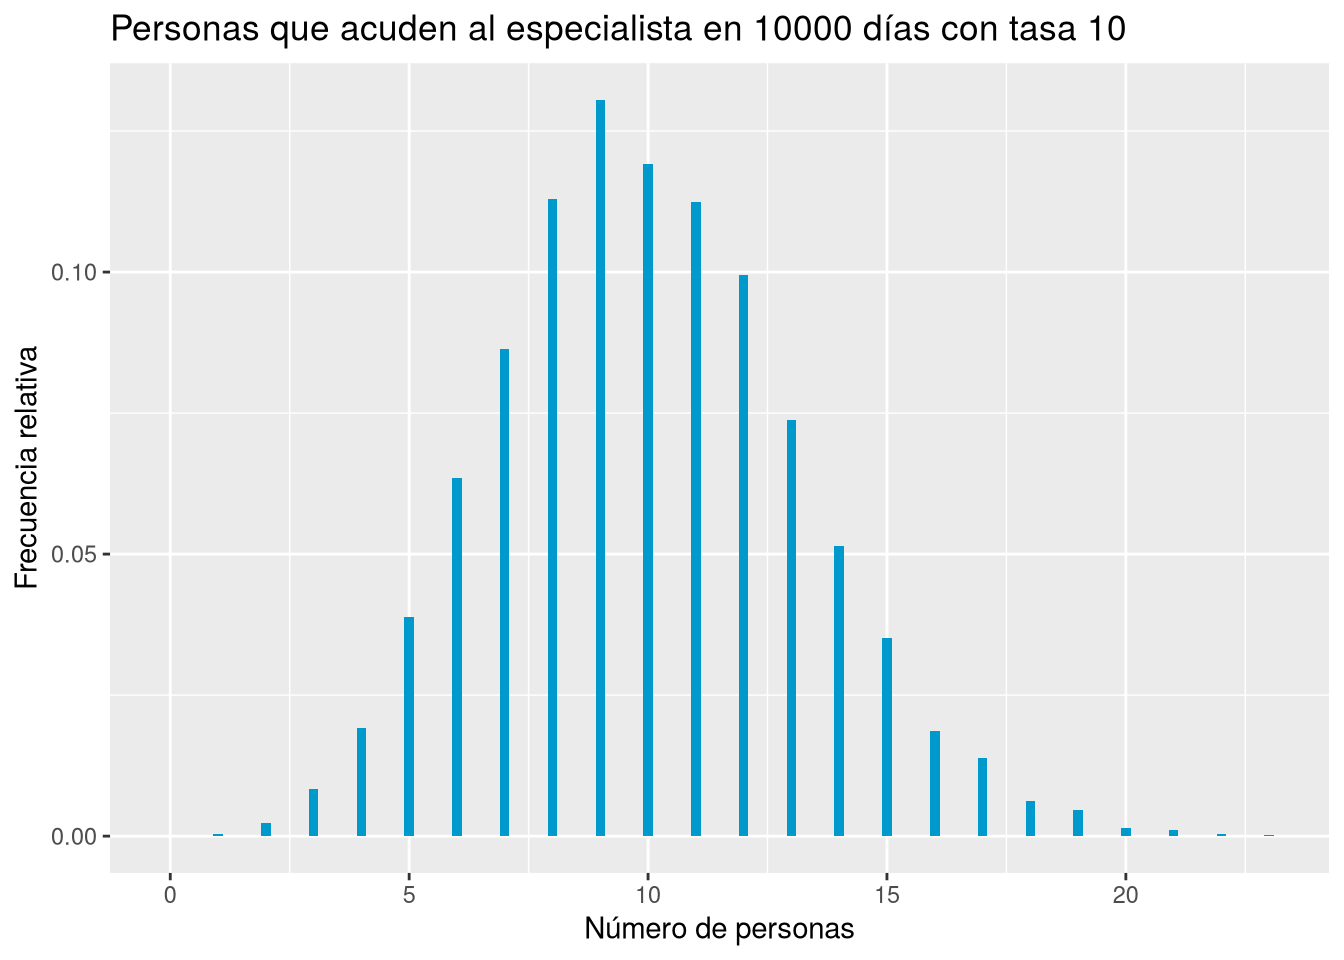
set.seed(123)
tibble(lambda = rnorm(n = 10000, mean = 10, sd = 2)) |>
  mutate(x = rpois(n = n(), lambda = lambda)) |>
  ggplot(aes(x = x, y = after_stat(prop))) +
  stat_count(fill = myblue, width = 0.2) +
  labs(title = "Personas que acuden al especialista en 10000 días con tasa aleatoria",
       x = "Número de personas", y = "Frecuencia relativa")