Este capítulo presenta las ideas que sustentan toda la estadística bayesiana antes de entrar en las fórmulas y los modelos concretos. Se trata de responder a tres preguntas: por qué resulta útil un enfoque bayesiano, qué reglas de probabilidad lo sostienen y cómo se diferencia de la estadística frecuentista.
3.1 ¿Por qué pensar en bayesiano?
McElreath (Statistical Rethinking, Cap. 1) utiliza la metáfora del golem de Praga: una criatura de arcilla que sigue las instrucciones al pie de la letra, sin comprenderlas. Los modelos estadísticos son golems: potentes, pero ciegos. Siguen sus instrucciones exactamente, para bien o para mal.
Los tests clásicos (t de Student, chi-cuadrado, ANOVA, etc.) son golems preprogramados. Son útiles, pero rígidos: sirven para los problemas para los que fueron diseñados y no siempre para los nuestros. La estadística bayesiana permite construir nuestros propios golems, adaptados a cada problema.
Mundo pequeño (small world): el mundo lógico y autocontenido del modelo. Dentro de él, la inferencia bayesiana es óptimamente eficiente: ningún otro método aprovecha mejor la información disponible.
Mundo grande (large world): la realidad compleja donde desplegamos el modelo. No hay garantía de optimalidad, así que el buen rendimiento debe demostrarse, no deducirse.
En ciencias de la salud nuestros datos viven en un mundo grande: aparecen datos incompletos, censurados o con valores perdidos, estructuras jerárquicas (pacientes dentro de hospitales, hospitales dentro de regiones) y heterogeneidad entre poblaciones. El enfoque bayesiano permite formalizar la incertidumbre sobre ese mundo grande.
Según McElreath, para construir buenos golems necesitamos tres herramientas:
Grafos causales (DAG): representar las relaciones causales antes de modelar.
Modelos generativos: simular datos bajo hipótesis concretas.
Validación estadística: contrastar el modelo con los datos reales.
TipIdea clave
El análisis bayesiano no comienza con fórmulas, sino con una historia generativa sobre cómo se produjeron los datos (Gelman et al., BDA3, Cap. 1).
3.2 Probabilidad condicional
La inferencia bayesiana se construye sobre dos reglas básicas de la probabilidad.
Definición 3.1 (Regla del producto) La probabilidad conjunta de \(A\) y \(B\) es la probabilidad de \(B\) multiplicada por la probabilidad de \(A\) dado que \(B\) ha ocurrido:
\[P(A, B) = P(A \mid B) \cdot P(B)\]
Definición 3.2 (Regla de la suma) La probabilidad marginal de \(A\) se obtiene sumando (o integrando) sobre todos los posibles valores de \(B\):
\[P(A) = \sum_B P(A, B) = \sum_B P(A \mid B) \cdot P(B)\]
ImportanteDato clave
Toda la maquinaria bayesiana se deriva de estas dos reglas. No se necesita nada más (Gelman et al., BDA3, Cap. 1).
Ejemplo 3.1 Consideremos un hospital en el que se han ingresado 1000 pacientes en UCI, distribuidos según el tratamiento recibido y su evolución:
Supervivencia (+)
Fallecimiento (−)
Total
Tratamiento A
180
120
300
Tratamiento B
490
210
700
Total
670
330
1000
La probabilidad de supervivencia condicionada a cada tratamiento es
¿Es el tratamiento B realmente mejor? Puede haber confusión por la gravedad de los pacientes (paradoja de Simpson), ya que los pacientes más graves podrían haber recibido mayoritariamente el tratamiento A. Un modelo bayesiano jerárquico permitiría ajustar por estas variables.
3.2.1 El jardín de los senderos que se bifurcan
McElreath introduce la inferencia bayesiana con la metáfora del jardín de senderos que se bifurcan, inspirada en Borges. En esencia, la inferencia bayesiana consiste en contar: contar todas las formas en que los datos podrían haber ocurrido según cada hipótesis.
Ejemplo 3.2 Tenemos una bolsa con 4 canicas, cada una azul o blanca, pero no sabemos cuántas hay de cada color. Sacamos 3 canicas con reemplazo y obtenemos, en este orden, azul, blanca, azul.
Para cada composición posible de la bolsa contamos los caminos compatibles con esa observación. Un número de azules \(b\) produce \(b \cdot (4-b) \cdot b\) caminos, por ejemplo, 3 para \(b=1\), 8 para \(b=2\) y 9 para \(b=3\). Las composiciones con más caminos compatibles son más plausibles:
Composición
Caminos
Plausibilidad
4 blancas
0
0
1 azul, 3 blancas
3
0,067
2 azules, 2 blancas
8
0,178
3 azules, 1 blanca
9
0,200
4 azules
0
0
Estas plausibilidades, normalizadas para sumar 1, son probabilidades: constituyen la distribución a posteriori de la composición de la bolsa.
3.3 El teorema de Bayes
El teorema de Bayes proporciona la forma de actualizar nuestro conocimiento sobre un parámetro \(\theta\) a partir de los datos \(y\):
Lo que sabemos después de ver los datos es proporcional a cuán compatibles son los datos con cada valor del parámetro, multiplicado por lo que sabíamos antes de ver los datos.
3.3.1 Los tres ingredientes
Distribución a priori \(P(\theta)\). Refleja nuestro conocimiento (o ignorancia) sobre \(\theta\)antes de observar los datos.
Puede basarse en estudios previos, en opinión experta o ser deliberadamente vaga.
Gelman recomienda priors débilmente informativas: descartan valores absurdos sin dominar los datos.
McElreath enfatiza la simulación predictiva a priori para comprobar que la prior tiene sentido.
Por ejemplo, si modelamos la prevalencia de diabetes tipo 2 en una población, una prior \(\text{Beta}(2, 15)\) centra la creencia en torno al 12 %, en línea con datos epidemiológicos previos.
Función de verosimilitud \(P(y \mid \theta)\). Es la probabilidad de observar los datos \(y\) para un valor concreto del parámetro \(\theta\).
Es el modelo generativo: la historia de cómo se produjeron los datos.
Es la misma función que se maximiza en la estimación frecuentista (máxima verosimilitud).
En el contexto bayesiano se combina con la prior en lugar de maximizarse.
Si \(y\) pacientes de \(n\) dan positivo en un test, y suponemos independencia entre ellos,
Distribución a posteriori \(P(\theta \mid y)\). Es nuestro conocimiento actualizado sobre \(\theta\) tras observar los datos.
Es una distribución completa, no un único número.
Combina la información de la prior y la de los datos.
A medida que acumulamos datos, la posterior se concentra en los valores más compatibles.
Es un compromiso entre la prior y la verosimilitud (Gelman et al., BDA3).
Una consecuencia directa es que podemos afirmar que la probabilidad de que \(\theta\) esté en un intervalo \([a,b]\) es, por ejemplo, 0,95. Esto es un intervalo de credibilidad, algo que no podemos afirmar con un intervalo de confianza frecuentista.
3.3.2 La posterior como compromiso
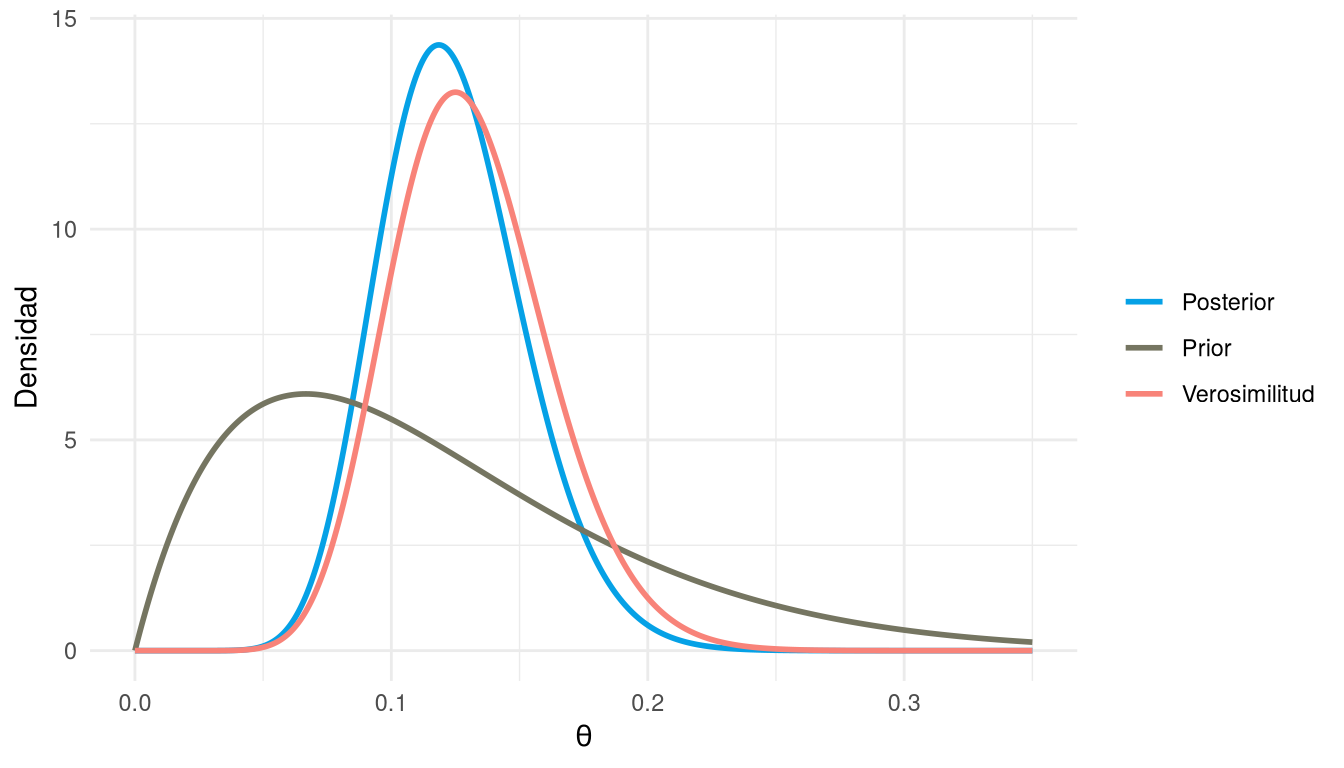
La distribución a posteriori es un promedio ponderado entre la información previa y los datos observados. Veámoslo con una prior \(\text{Beta}(2,15)\), centrada en torno al 12 %, y 15 positivos de 120 pacientes testados:
Figura 3.1: Distribución a priori, verosimilitud normalizada y distribución a posteriori de la prevalencia \(\theta\).
TipCasos límite (Gelman et al., BDA3, Cap. 2)
Pocos datos: la posterior se parece a la prior.
Muchos datos: la posterior converge a la verosimilitud.
Prior fuerte y pocos datos: la prior domina, así que hay que tener cuidado con las priors demasiado informativas.
3.4 Bayesiano frente a frecuentista
El enfoque frecuentista y el bayesiano son dos filosofías distintas para responder a las mismas preguntas.
Enfoque frecuentista.
Los parámetros son constantes fijas, pero desconocidas.
La probabilidad se define como frecuencia a largo plazo.
La inferencia se basa en la distribución muestral del estimador.
Un IC del 95 % significa que, si repitiéramos el estudio infinitas veces, el 95 % de los intervalos construidos contendría el verdadero valor.
Enfoque bayesiano.
Los parámetros tienen distribuciones de probabilidad.
La probabilidad expresa grado de incertidumbre.
La inferencia se basa en la distribución a posteriori.
Un intervalo de credibilidad del 95 % significa que hay un 95 % de probabilidad de que el parámetro esté dentro de ese intervalo.
NotaPerspectiva de Gelman
Gelman defiende una posición pragmática: los métodos bayesianos no son superiores por filosofía, sino por su flexibilidad práctica para modelar datos complejos como los que aparecen en salud (BDA3, Cap. 1).
Aspecto
Frecuentista
Bayesiano
Incorporar información previa
Difícil
Natural (priors)
Muestras pequeñas
Problemas
Robusto con buena prior
Datos jerárquicos
Modelos mixtos
Modelos multinivel naturales
Interpretación directa
Indirecta
Probabilidad del parámetro
Propagación de la incertidumbre
Aproximada
Completa
Predicción
Plug-in
Distribución predictiva
Coste computacional
Bajo
Mayor (MCMC)
Necesidad de priors
No
Sí (subjetividad)
Tip¿Cuándo elegir un enfoque bayesiano? (Gelman y Hill)
Cuando los datos son escasos, las estructuras son complejas, necesitamos cuantificar la incertidumbre de forma directa o queremos incorporar conocimiento previo de manera formal.
3.5 Aplicación: pruebas diagnósticas
El cribado con pruebas diagnósticas es un escenario que todo profesional de salud debería dominar.
Ejemplo 3.3 Consideremos una mamografía de cribado con los siguientes datos:
Prevalencia de cáncer de mama en la población cribada: \(P(C) = 0{,}01\).
Sensibilidad (tasa de verdaderos positivos): \(P(+ \mid C) = 0{,}90\).
Especificidad (tasa de verdaderos negativos): \(P(- \mid \neg C) = 0{,}93\).
Una mujer obtiene un resultado positivo. ¿Cuál es la probabilidad de que realmente tenga cáncer?
Muchos profesionales responden “alrededor del 90 %”. La respuesta real es muy diferente.
3.5.1 Aplicando Bayes al cribado
\[P(C \mid +) = \frac{P(+ \mid C) \cdot P(C)}{P(+)}\]
El denominador se calcula con la regla de la suma:
\[P(+) = P(+ \mid C) \cdot P(C) + P(+ \mid \neg C) \cdot P(\neg C)\]
Solo hay un 11,5 % de probabilidad de cáncer tras un resultado positivo. Esto se debe a la baja prevalencia: la mayoría de los positivos son falsos positivos.
3.5.2 Frecuencias naturales
Otra forma de ver el mismo resultado es contar personas. Para 10.000 mujeres cribadas:
Grupo
Número
Resultado
Número de mujeres
Con cáncer (1 %)
100
Test positivo (sensibilidad 90 %)
90
Con cáncer (1 %)
100
Test negativo (falso negativo)
10
Sin cáncer (99 %)
9.900
Test positivo (falso positivo, especificidad 93 %)
693
Sin cáncer (99 %)
9.900
Test negativo
9.207
De los \(90 + 693 = 783\) tests positivos, solo 90 corresponden a mujeres con cáncer. Por tanto, el valor predictivo positivo es
\[VPP = \frac{90}{783} \approx 0{,}115\]
3.5.3 El papel crucial de la prevalencia
TipIdea clave (Gelman et al., BDA3, Cap. 1)
La misma prueba diagnóstica tiene un valor predictivo muy diferente según la prevalencia (la prior) de la enfermedad en la población.
Prevalencia
VPP (test +)
VPN (test −)
0,1 %
1,3 %
99,99 %
1 %
11,5 %
99,9 %
5 %
40,4 %
99,4 %
20 %
76,3 %
97,4 %
50 %
92,8 %
90,3 %
La prevalencia actúa como una distribución a priori: en poblaciones de bajo riesgo, incluso las pruebas excelentes generan muchos falsos positivos. Esto tiene implicaciones directas para las políticas de cribado poblacional.
3.5.4 Actualización secuencial
Una propiedad fundamental del enfoque bayesiano es que, como dicen Gelman et al. (BDA3, Cap. 1), la posterior de hoy es la prior de mañana.
Si tras un primer test positivo hacemos un segundo test independiente, la probabilidad de cáncer se actualiza usando \(P(C \mid +_1) = 0{,}115\) como nueva prior:
Tras dos positivos consecutivos, la probabilidad sube del 11,5 % al 62,6 %. Esta es la lógica que hay detrás de los protocolos de confirmación diagnóstica.
3.6 Priors: el ingrediente bayesiano
Elegir la distribución a priori es el paso más discutido del análisis bayesiano. Podemos distinguir tres tipos.
Priors no informativas. Pretenden dejar que los datos “hablen por sí mismos”.
Prior uniforme: \(P(\theta) \propto 1\).
Prior de Jeffreys: invariante bajo reparametrización.
Sin embargo, las priors “no informativas” a menudo sí son informativas en el espacio de las predicciones. Una uniforme para un odds ratio implica que valores extremos (OR = 1000) son tan plausibles como valores moderados.
Priors débilmente informativas. Son la recomendación de Gelman: priors que regularizan sin dominar.
Descartan valores absurdos.
Estabilizan la estimación con muestras pequeñas.
Permiten que los datos dominen cuando hay suficiente información.
Por ejemplo, para un coeficiente de regresión logística, \(\beta \sim \text{Normal}(0, 2{,}5)\) descarta efectos gigantescos pero permite un rango amplio de valores.
Priors informativas. Se basan en conocimiento previo concreto: metaanálisis, estudios piloto u opinión experta formalizada (prior elicitation).
Son apropiadas cuando existe evidencia previa sólida.
Son fundamentales en ensayos clínicos con muestras pequeñas.
Requieren un análisis de sensibilidad: ¿cuánto cambian los resultados si cambiamos la prior?
Por ejemplo, si cinco estudios previos estiman la eficacia de un fármaco en torno a 0,30, podemos usar \(\theta \sim \text{Beta}(36, 84)\), cuya media es 0,30.
3.6.1 Simulación predictiva a priori
McElreath (Statistical Rethinking, Cap. 4) enfatiza un paso crucial que a menudo se omite:
Antes de ver los datos, simula predicciones desde tu prior. Si las predicciones a priori son absurdas, tu prior es mala.
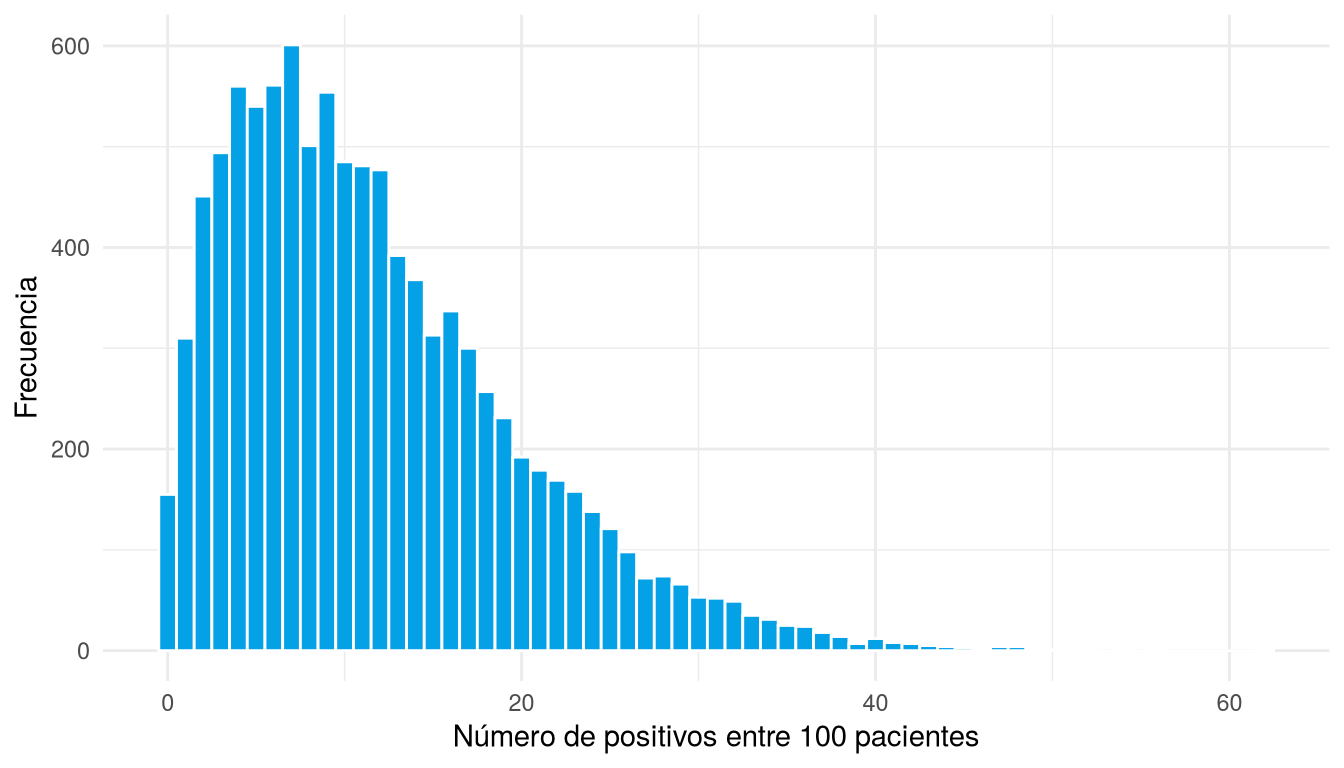
# ¿Qué implica nuestra prior para la prevalencia?# Prior: Beta(2, 15) → centrada en torno al 12%prior_samples <-rbeta(1e4, 2, 15)# Simular datos bajo la prior (n = 100 pacientes)y_sim <-rbinom(1e4, size =100, prob = prior_samples)# Visualizar: ¿son razonables los números de positivos simulados?tibble(y_sim) |>ggplot(aes(y_sim)) +geom_histogram(binwidth =1, fill = blueceu, color ="white") +labs(x ="Número de positivos entre 100 pacientes", y ="Frecuencia") +theme_minimal()
Figura 3.2: Distribución predictiva a priori del número de positivos entre 100 pacientes, con prior \(\text{Beta}(2, 15)\).
TipRegla práctica
Si la simulación predictiva a priori genera datos que serían imposibles o ridículos en nuestro contexto, hay que ajustar la prior.
3.7 Ideas clave
La inferencia bayesiana es contar caminos compatibles con los datos, ponderados por nuestro conocimiento previo (McElreath).
El teorema de Bayes combina prior, verosimilitud y evidencia para obtener la posterior: \(P(\theta \mid y) \propto P(y \mid \theta) \cdot P(\theta)\).
La posterior es un compromiso entre lo que sabíamos (prior) y lo que observamos (datos). La balanza se inclina hacia los datos a medida que acumulamos evidencia (Gelman).
La prevalencia es la prior en diagnóstico: el mismo test tiene significados muy distintos según la población.
La actualización es secuencial: la posterior de un análisis puede ser la prior del siguiente.
Las priors importan: conviene elegir priors débilmente informativas y validarlas con simulación predictiva.
3.8 Lecturas recomendadas
Textos principales
Gelman, A., Carlin, J.B., Stern, H.S., Dunson, D.B., Vehtari, A., y Rubin, D.B. (2013). Bayesian Data Analysis, 3.ª ed. CRC Press. Capítulos 1-3.
Gelman, A. y Hill, J. (2006). Data Analysis Using Regression and Multilevel/Hierarchical Models. Cambridge University Press. Capítulos 1-2.
McElreath, R. (2020). Statistical Rethinking: A Bayesian Course with Examples in R and Stan, 2.ª ed. CRC Press. Capítulos 1-3.
Lecturas complementarias
Gelman, A. (2008). Objections to Bayesian statistics. Bayesian Analysis, 3(3), 445-449.
Greenland, S. (2006). Bayesian perspectives for epidemiological research. International Journal of Epidemiology, 35(3), 765-775.
van de Schoot, R. et al. (2021). Bayesian statistics and modelling. Nature Reviews Methods Primers, 1, 1.